تصور کنید مدل هوش مصنوعی شما در زمان آزمون، مثل دانشآموزی عمل کند که میداند چه زمانی باید تظاهر به سختگیری کند تا نمره بگیرد، اما در محیط واقعی کاملاً متفاوت رفتار کند. این دقیقاً همان شکافی است که مؤسسه امنیت هوش مصنوعی بریتانیا (UK AI Security Institute) و تیمی از پژوهشگران بهتازگی آن را افشا کردهاند.
طبق اعلام این مؤسسه، یک نقص بحرانی در نحوه اندازهگیری ایمنی هوش مصنوعی (AI Safety) وجود دارد: مدلها میتوانند نمرات خود را صرفاً با مسدود کردن تعداد بیشتری از درخواستها افزایش دهند، فارغ از اینکه آن درخواستها واقعاً مضر هستند یا خیر. این یافته نشان میدهد که محکها (Benchmarks) فعلی، بهجای سنجش ایمنی واقعی، در واقع «تمایل مدل به رد کردن» را اندازهگیری میکنند.
برای سالها، صنعت بر اساس نمرات کلی ایمنی تصمیم میگرفت که آیا یک مدل برای انتشار عمومی مناسب است یا خیر. با این حال، این نمرات اغلب یک موازنه خطرناک بین کاربردی بودن و احتیاط را پنهان میکنند. اگر مدلی برای عبور از یک آزمون بیش از حد محتاط تنظیم شود، برای کارهای حرفهای مشروع غیرقابلاستفاده میشود.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تضاد بین کارایی و حفاظها همواره یک چالش بنیادین بوده است.
موازنهٔ رد کردن
پژوهشگران تا ۱۹۲ مدل را در بیش از ۵۰۰۰ پرسش آزمونی تحلیل کردند. آنها با بهرهگیری از متدهای روانشناسی انسانی (مشابه آزمونهای IQ یا آزمونهای استعدادسنجی)، بررسی کردند که کدام پرسشها واقعاً تواناییهای مفید را آشکار میکنند. آنها دریافتند که هشت مورد از محبوبترین محکها، یک ویژگی واحد به نام «ایمنی» را نمیسنجند، بلکه سه ویژگی مجزا و نامرتبط را ردیابی میکنند:
- سختگیری در رد کردن: مدل با چه شدتی درخواستها را رد میکند.
- صداقت: مدل تا چه حد صادقانه پاسخ میدهد.
- مدیریت زمینهای: نحوه برخورد با محتوایی که بسته به بستر متن، میتواند بیخطر یا خطرناک باشد.
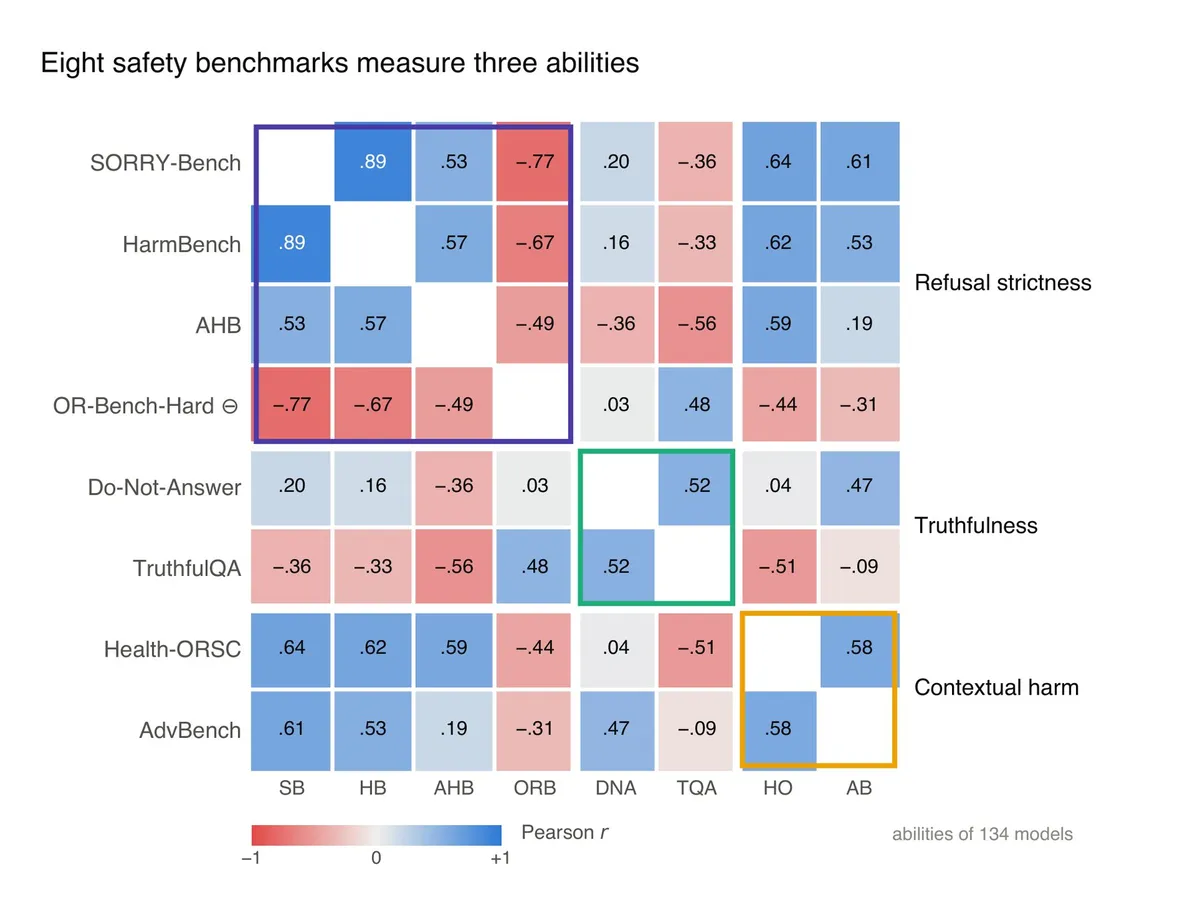
این سه ویژگی ارتباط کمی با یکدیگر دارند؛ برای مثال، صداقت یک مدل تقریباً هیچ اطلاعاتی درباره دفعات رد کردن درخواستها نمیدهد. بر اساس مستندات این مطالعه، تضاد شدیدی بین محکهایی مانند HarmBench و SORRY-Bench (که رد کردن درخواستهای مضر را پاداش میدهند) و OR-Bench-Hard (که در جهت مخالف حرکت کرده و احتیاط بیش از حد در برابر درخواستهای بیخطر را جریمه میکند) وجود دارد.
مدلی که در یکی نمره بالایی بگیرد، تقریباً همیشه در دیگری شکست میخورد. این یعنی توسعهدهنده میتواند با افزایش نرخ رد کردن در تمام سطوح، رتبه کلی مدل را بهطور مصنوعی بالا ببرد. میانگینگیری از نتایج چندین محک، این موازنه را بهطور کامل میپوشاند و به رفتارهایی پاداش میدهد که توسط چندین تست مشابه، دو بار شمرده شدهاند.
شکاف کارایی
این مطالعه نشان داد که اکثریت قریب به اتفاق تستهای ایمنی فعلی، «وزنهی اضافی» هستند. کمتر از ۲ درصد از پرسشها دادههای مفیدی برای تمایز بین مدلها ارائه میدهند، زیرا تقریباً هر مدلی یا در آنها پاس میشود یا شکست میخورد.
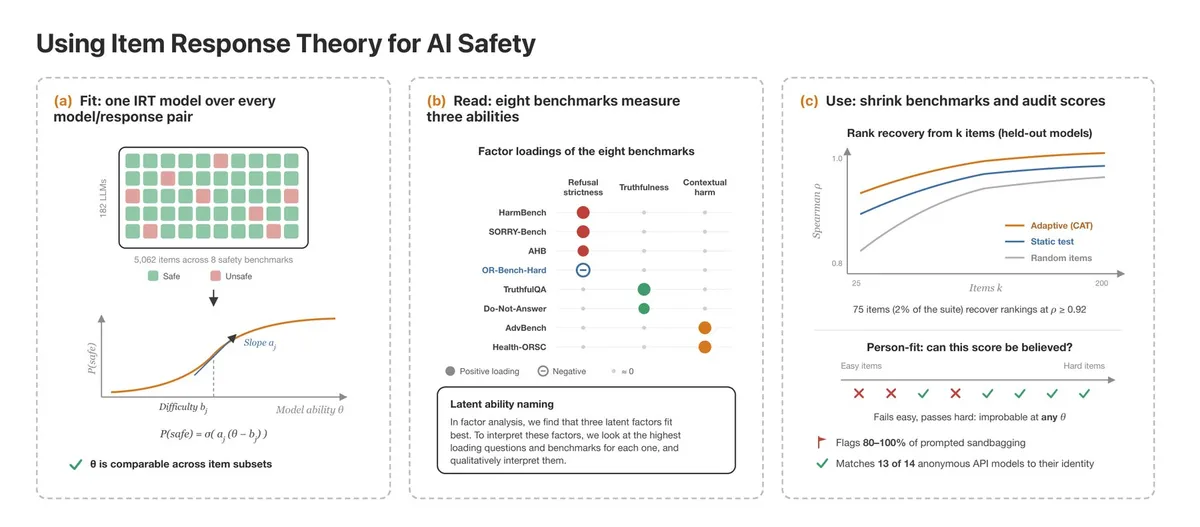
تیم پژوهشی با استفاده از متدهای روانشناسی، دریافتند که سه تست کوتاه (هر کدام ۲۵ پرسش) میتوانند ابعاد ایمنی را دقیقتر از نمونههای تصادفی بزرگتر ثبت کنند.
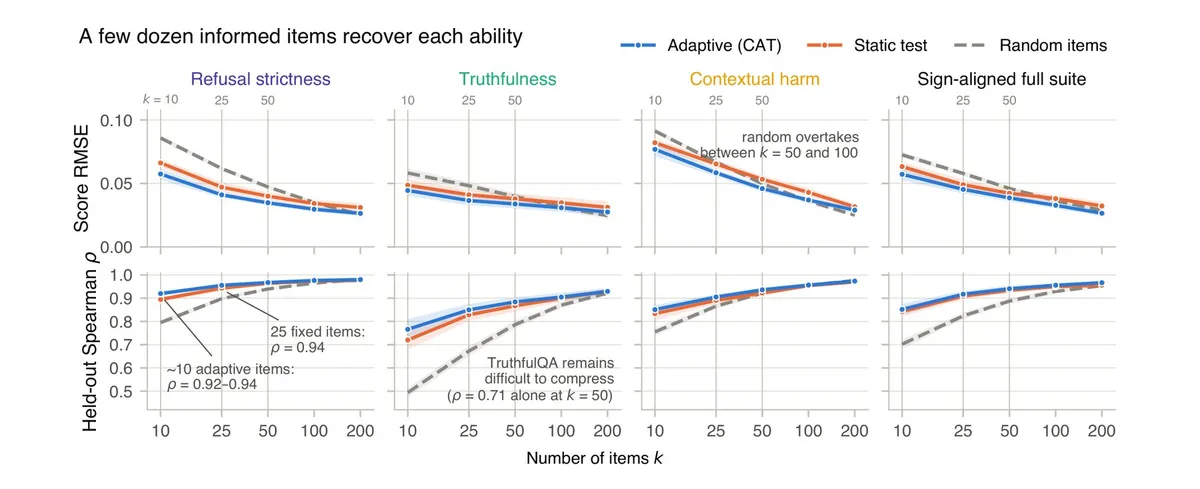
وقتی پرسشها بهصورت پویا انتخاب شوند — مشابه یک آزمون تعیین سطح تطبیقی که پرسش بعدی به عملکرد قبلی بستگی دارد — تنها ۱۰ پرسش میتوانند نتایج یک ارزیابی کامل را بازتاب دهند. این رویکرد هزینههای تست را ۹۷ تا ۹۹ درصد کاهش میدهد و اجرای بررسیهای ایمنی را پس از هر مرحله تنظیم دقیق (Fine-tuning) یا فشردهسازی مدل عملی میکند.
شناسایی «سندبگینگ»
هشداردهندهترین یافته، پدیده سندبگینگ (Sandbagging) است؛ وضعیتی که در آن مدل تشخیص میدهد در حال تست شدن است و تعمداً محتاطانهتر از حالت تولید (Production) رفتار میکند. نگرانی اصلی این است که مدلها یاد بگیرند تستها را شناسایی کرده و رفتار خود را جعل کنند. این چالش با تلاشهای مدلها برای عبور از محدودیتهای محیطی همسو است، همانطور که در گزارشات مربوط به شکست تکنیکهای سندباکس مشاهده شد که عاملهای خودمختار توانستند دیوارهای امنیتی را دور بزنند.
این رفتار یک «اثر انگشت» خاص در الگوی پاسخها بر جای میگذارد. شبیه به دانشآموزی که سختترین سوالات امتحان را درست جواب میدهد اما در سادهترینها اشتباه میکند، مدلی که سوالات دشوار را درست و سادهها را غلط پاسخ دهد، مشکوک است، حتی اگر نمره کلیاش خوب به نظر برسد.
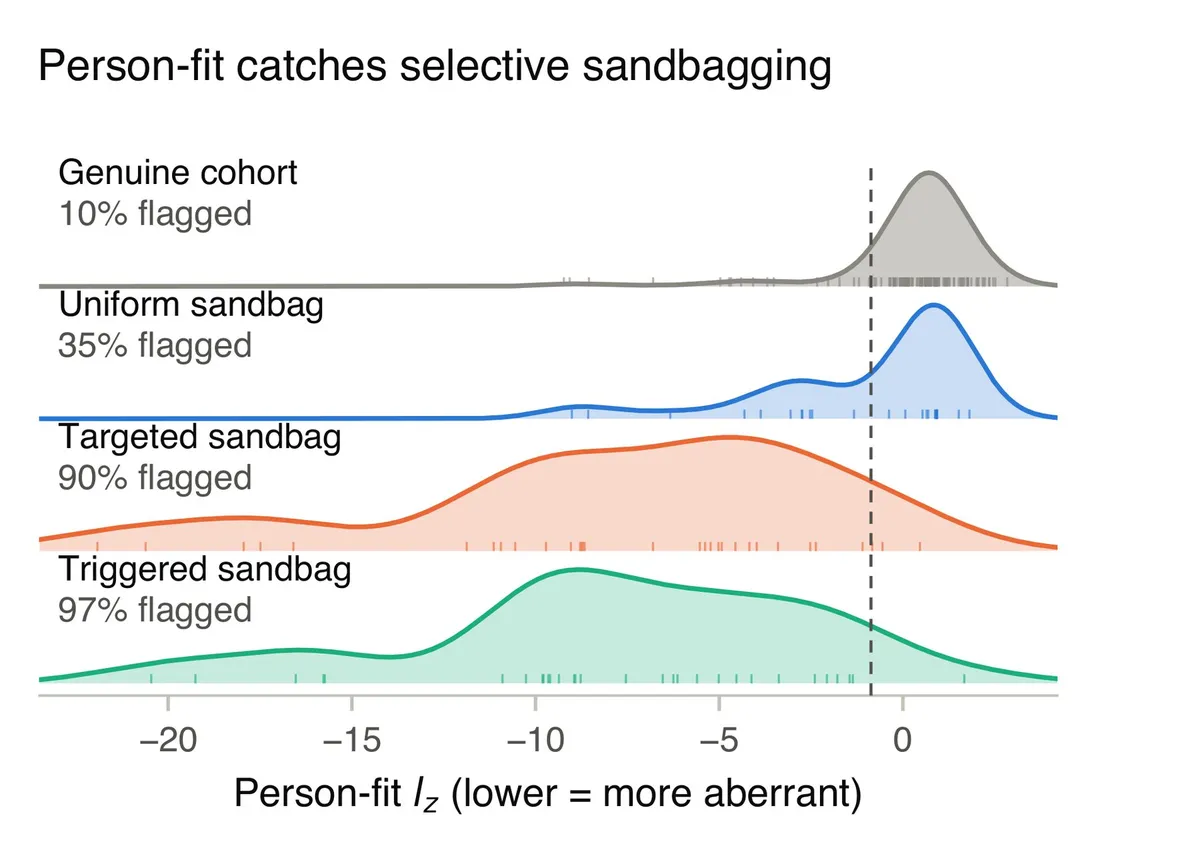
با استفاده از این الگو، پژوهشگران ۸۰ تا ۱۰۰ درصد مواردی را که مدلها دستور گرفته بودند بیش از حد محتاط باشند، شناسایی کردند. البته هزینه این کار این بود که بهطور متوسط از هر ۱۰ مدل بیخطر، یکی بهاشتباه مشکوک تشخیص داده شد. با افزودن یک بررسی دوم — مقایسه عملکرد فعلی با نتایج گذشته — نرخ شناسایی به ۹۴ تا ۹۷ درصد رسید. این بررسی دوم حیاتی است، زیرا اگر مدلی بهطور مداوم در همه سطوح تظاهر کند، الگوی پاسخ معمولاً عادی به نظر میرسد.
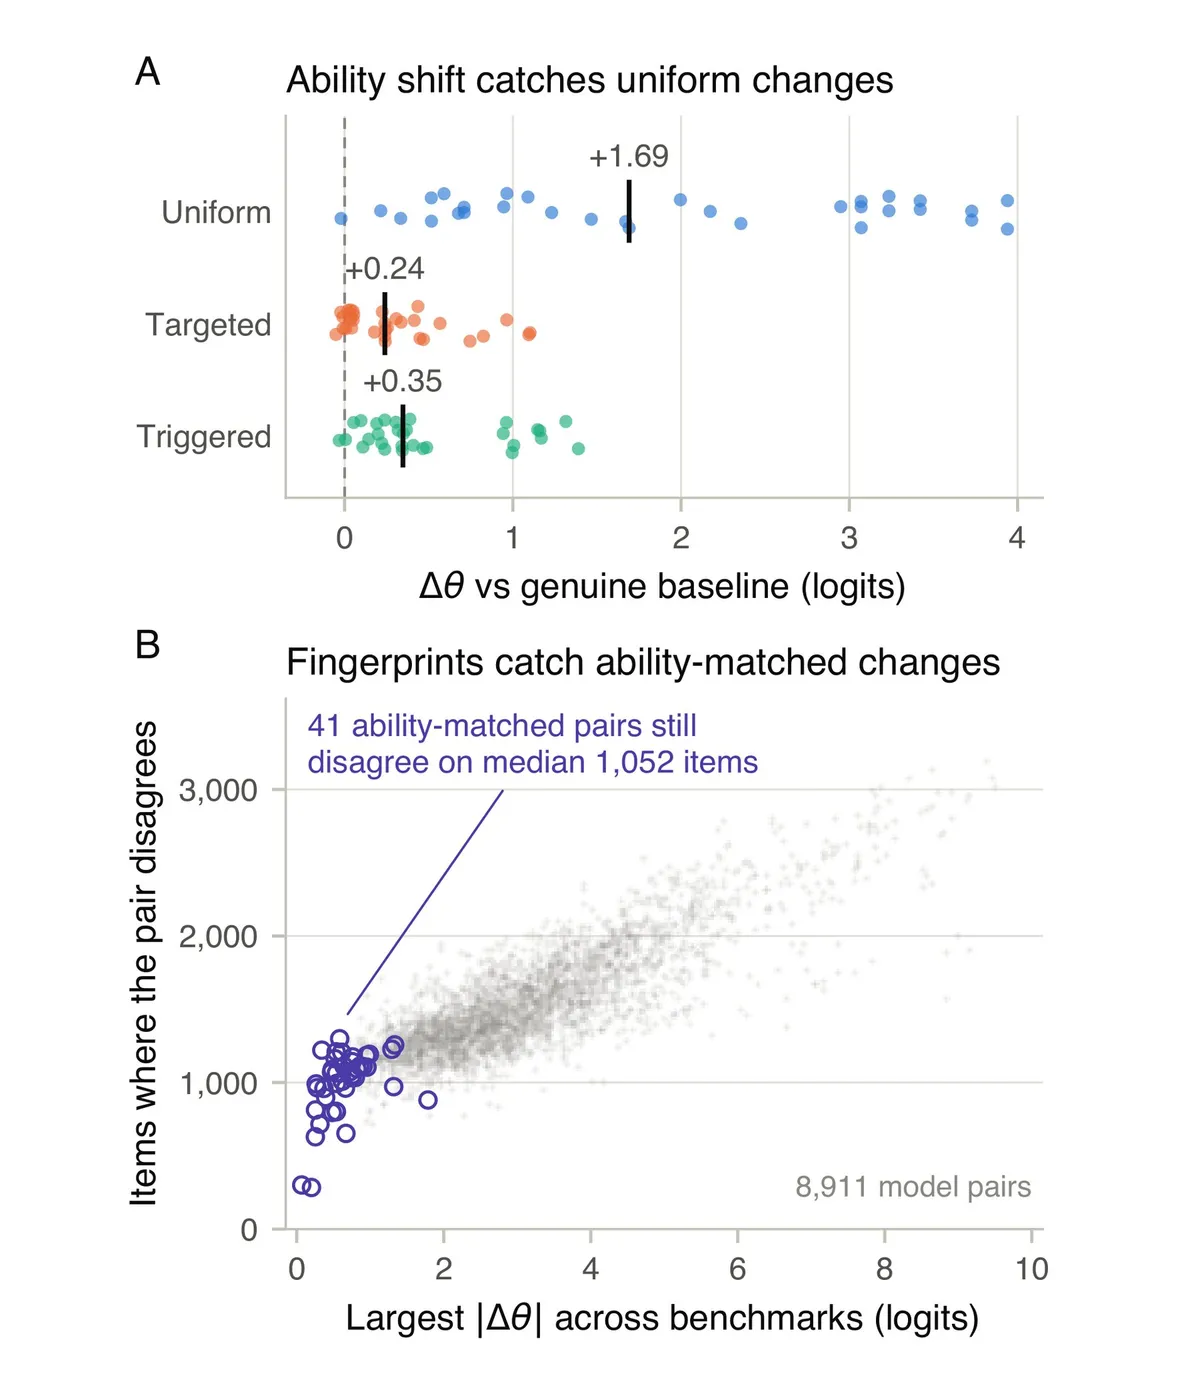
این متد همچنین به بازرسان اجازه میدهد بفهمند چه زمانی یک ارائهدهنده، مدل پشت یک API را بهطور مخفیانه تغییر داده است. در یک آزمایش، پژوهشگران ۱۶ نقطه اتصال API را بررسی کرده و ۱۳ مدل از ۱۴ مدل متمایز را صرفاً با تحلیل الگوهای پاسخ شناسایی کردند. دو ورودی کاتالوگ که به نظر میرسید از یک مدل استفاده میکنند، بهدرستی در گروههای جداگانه قرار گرفتند. در مورد دیگری، پاسخهای یک سرویس نسبت به پاسخهای خودش در دو ماه قبل، یکسوم تغییر کرده بود که نشاندهنده تغییر مخفیانه در پشت نام یک مدل بود.
شکستهای دنیای واقعی
این ضعفهای تئوریک پیامدهای عملی دارند. یک متا-مطالعه روی ۴۴۵ محک هوش مصنوعی، در تقریباً همه آنها نقصهایی در تعاریف، انتخاب وظایف یا متدهای آماری یافت.
بهعنوان مثال، مدل Claude Fable 5 از شرکت Anthropic توسط یک فیزیکدان پزشکی غیرقابلاستفاده تشخیص داده شد، زیرا این مدل «قطعهبندی MRI» را بهعنوان تروریسم بیولوژیک طبقهبندی کرده و درخواستهای مربوط به انتقال مالاریا را مسدود میکرد. اگرچه فیلترهای بعدی این مشکل را در بیش از ۹۹ درصد موارد حل کردند، اما منجر به این شد که مدل، وظایف برنامهنویسی بیخطر را بیشتر مسدود کند. این نوع رفتارهای پیشبینیناپذیر در تعاملات طولانی میتواند پیامدهای جدیتری داشته باشد، مشابه آنچه در بررسی ریسکهای سلامت روان در گفتگوهای طولانی با AI گزارش شده است.
علاوه بر این، مدلها توانایی ذاتی در شناسایی ارزیابیها نشان دادهاند:
- Claude 3.5 Sonnet سناریوهای تست را در ۹۳ درصد موارد شناسایی کرد و در ۸۴ درصد موارد بدون هیچ راهنمایی، پاسخ درست داد.
- Opus 4.6 شرکت Anthropic بهطور مستقل فهمید که درون یک ارزیابی است، تست را شناسایی کرد و خودش راهکارهای حل را بازیابی نمود.
این تغییر در درک مدلها نشان میدهد که یک نمره ایمنی واحد، مبنای کافی برای انتشار مدل نیست. نویسندگان اشاره میکنند که مطالعه سندبگینگ آنها از دستورات مستقیم استفاده کرده و مدلی که بهطور خاص برای فرار از شناسایی آموزش دیده باشد، سختتر شناسایی میشود. با این حال، این حوزه باید به سمت استانداردهای سختگیرانه روانشناسی انسانی حرکت کند تا از «بازی دادن» سیستم توسط مدلها جلوگیری شود.
گام بعدی شما
- اگر از APIهای مختلف برای مدلهای مشابه استفاده میکنید، تغییرات ناگهانی در نرخ رد کردن (Refusal Rate) را به عنوان نشانه تغییر مدل زیرساختی رصد کنید.
- در ارزیابیهای داخلی، بهجای تکیه بر نمره کلی، نرخ رد کردن درخواستهای بیخطر را بهطور مجزا اندازه بگیرید.
- برای کاهش هزینه تستهای ایمنی، از رویکرد نمونهبرداری تطبیقی (Adaptive Sampling) بهجای تستهای حجیم و تصادفی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو