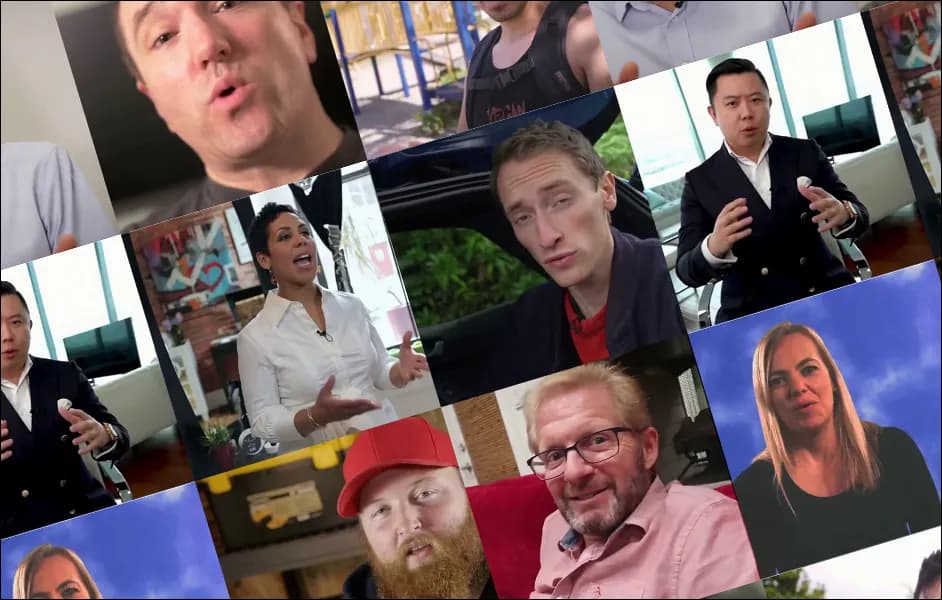
تصور کنید ویدئویی از یک مقام دولتی یا یک اینفلوئنسر را میبینید که با اطمینان کامل به شما میگوید حقیقت چیست، اما در واقع هیچ بخشی از آن تصویر هرگز وجود نداشته است. اکنون حتی پیشرفتهترین ابزارهای امنیتی هم نمیتوانند با اطمینان بگویند این ویدئو واقعی است یا ساختهی هوش مصنوعی.
طبق اعلام پژوهشگران در مقالهای جدید با عنوان DF26: We Cannot Tell Fake From Real Anymore که توسط تیمی از اوکراین رهبری شده است، صحت تشخیص خودکار جعل عمیق (Deepfake) تنها در یک سال از ۹۴٪ به ۴۸٪ سقوط کرده است. این کاهش ۴۹ درصدی در دقت نشان میدهد که نسل فعلی ویدئوهای هوش مصنوعی زاینده بهطور مؤثری از ابزارهایی که برای شکار آنها طراحی شدهاند، پیشی گرفته است.
این بحران دقیقاً زمانی رخ میدهد که صنعت از مدلهای قدیمی مبتنی بر خودرمزگذار (Autoencoder) به سمت مدلهای پیچیدهی مدل انتشار (Diffusion Model) حرکت کرده است. برای سالها، تشخیص جعل بر شناسایی نقصهای بصری (Artifacts) در جایگزینی چهره یا لرزشهای غیرطبیعی در میمیک صورت متکی بود. اما مدلهای مدرن اکنون فریمهای تصویر را از ابتدا و بهطور کامل خلق میکنند و هیچ «درز» یا مرز مشخصی برای تحلیل ابزارهای سنتی باقی نمیگذارند. این تغییر بنیادین باعث شده تا رویکردهای سنتی تحلیل پیکسل در برابر ویدیوهای بدون نقص (Artifact-free) شکست بخورند و نیاز به متدهای جدیدی مانند تأییدیه رمزنگاری ایجاد شود.
زمینه: تکامل فریب
از نظر تاریخی، فناوری جعل عمیق به خودرمزگذارها متکی بود؛ روشی که از اواخر سال ۲۰۱۷ و همزمان با ظهور اولیه دیپفیکها رایج شد. این تکنیک تنها ناحیهی داخل خطوط بیرونی صورت را جایگزین میکرد. تا سال ۲۰۲۲، این متد بهدلیل سهولت در شناسایی، عملاً بهطور کامل منسوخ و تخلیه شد.
با این حال، بخش پژوهشی علوم کامپیوتر همچنان بر «جایگزینی یا اصلاح داخلی صورت» تمرکز کرد چون این روش هدفی ثابت و مشخص برای مطالعه طولانیمدت فراهم میکرد. در نتیجه، بسیاری از سرویسهای تجاری تشخیص جعل، مدتها پس از تکامل فناوری زیرساختی، همچنان از این استراتژیهای منسوخ استفاده میکردند.
یک نمونه افراطی از عصر خودرمزگذار، دستکاری آرشیو واقعی ریچارد نیکسون بود. در این مورد، ویدئوها بهگونهای تغییر یافتند تا یک بیانیه جعلی دربارهی مرگ فضانوردان آپولو ۹ در سال ۱۹۶۹ را شبیهسازی کنند. اگرچه چنین اتفاقی هرگز رخ نداد، اما این جعل از یک متن واقعی برای تحمیل صدا و حرکات لب جعلی استفاده کرده بود.
اما مدلهای مبتنی بر انتشار در ۱۸ تا ۲۴ ماه گذشته جایگزین این روشها شدهاند. این چرخش باعث شد استراتژیهای قدیمی بیاثر شوند، زیرا پلتفرمهای جدید هوش مصنوعی زاینده دیگر توجه خود را بر یک مرز چهرهی خاص متمرکز نمیکنند و کل تصویر را بازسازی میکنند.
محک DF26
پژوهشگران برای کمی کردن این سقوط، مجموعهدادهی DF26 را ایجاد کردند؛ یک مجموعهی «برکنار» (Hold-out) که بهطور خاص برای ارزیابی محتوای سنتتیک دیده نشده طراحی شده است. این مجموعه شامل ۲۶۹۱ ویدئو در سه سناریوی پرخطر سخنرانی عمومی است:
- خطابهای غیررسمی و دوستانه رو به دوربین (شبیه به اینفلوئنسرهای تیکتاک یا یوتیوب).
- بیانیههای رسمی دولتی یا شرکتی.
- مصاحبههای استودیویی.
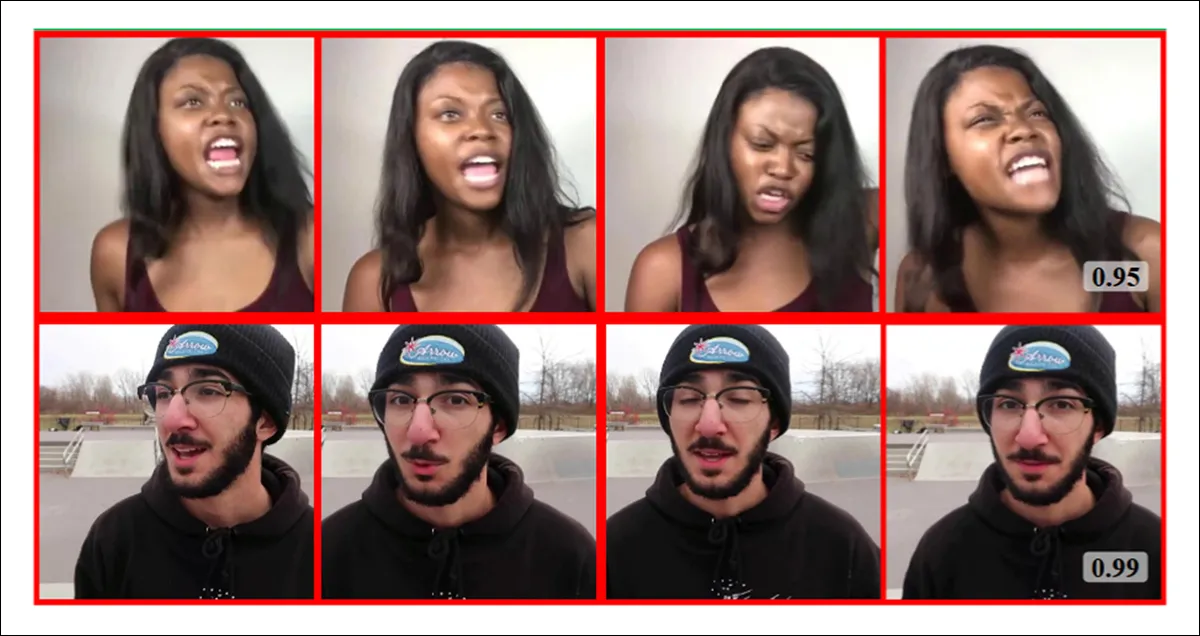
بر اساس مستندات این پژوهش، محققان از ۲۷۱ کلیپ واقعی از منابع OpenVid، TalkingCelebs و MAVOS-DD به عنوان ماده اولیه (Root Material) استفاده کردند. آنها با استخراج پرامپتهای متناظر از فریمها و استفاده از اولین فریم به عنوان مرجع (در جاهایی که پشتیبانی میشد)، ۲۴۲۰ کلیپ سنتتیک را با استفاده از هفت مدل پیشرو تولید کردند.
طراحی مجموعه داده و محدودیتها
برای اطمینان از سختگیرانه بودن این محک، نویسندگان چندین فیلتر سختگیرانه را در طول فرآیند تولید اعمال کردند:
- حذف متن: هیچ فریم واقعی که دارای لایههای متنی (مانند تگهای نام یا اعلانها) بود پذیرفته نشد، زیرا این موارد میتوانستند «میانبرهایی» برای تشخیصدهندهها ایجاد کنند.
- تکگوینده: هر قطعهای که بیش از یک چهره در آن ظاهر میشد رد شد تا محیط دقیقاً در حالت «تکگوینده» باشد.
- پنهانسازی واترمارک: محققان مجبور شدند واترمارکهای هوش مصنوعی را حذف یا پنهان کنند تا سیستمهای ارزیابی به تگهای بصری ساده متکی نشوند.
- تأیید کیفیت: کلیپهای کاندید توسط مدل Gemini 2.5 ارزیابی شدند تا از کیفیت و پایبندی آنها به پارامترهای مطالعه اطمینان حاصل شود.
برای ساخت این مجموعه، پژوهشگران از پلتفرم Higgsfield AI استفاده کردند که دسترسی به مدلهای مختلف بسته و متنباز با سطوح مختلفی از محدودیتها (Guardrails) را فراهم میکند. با استفاده از یک خوشهی تحقیقاتی داخلی مجهز به GPU مدل NVIDIA H200 (با ۱۴۱ گیگابایت VRAM)، تولید ۱۶۲۶ ویدئو از این مجموعه حدود ۴۴۰ ساعت محاسباتی GPU زمان برد.
مدلهایی که تشخیصدهندهها را شکست دادند
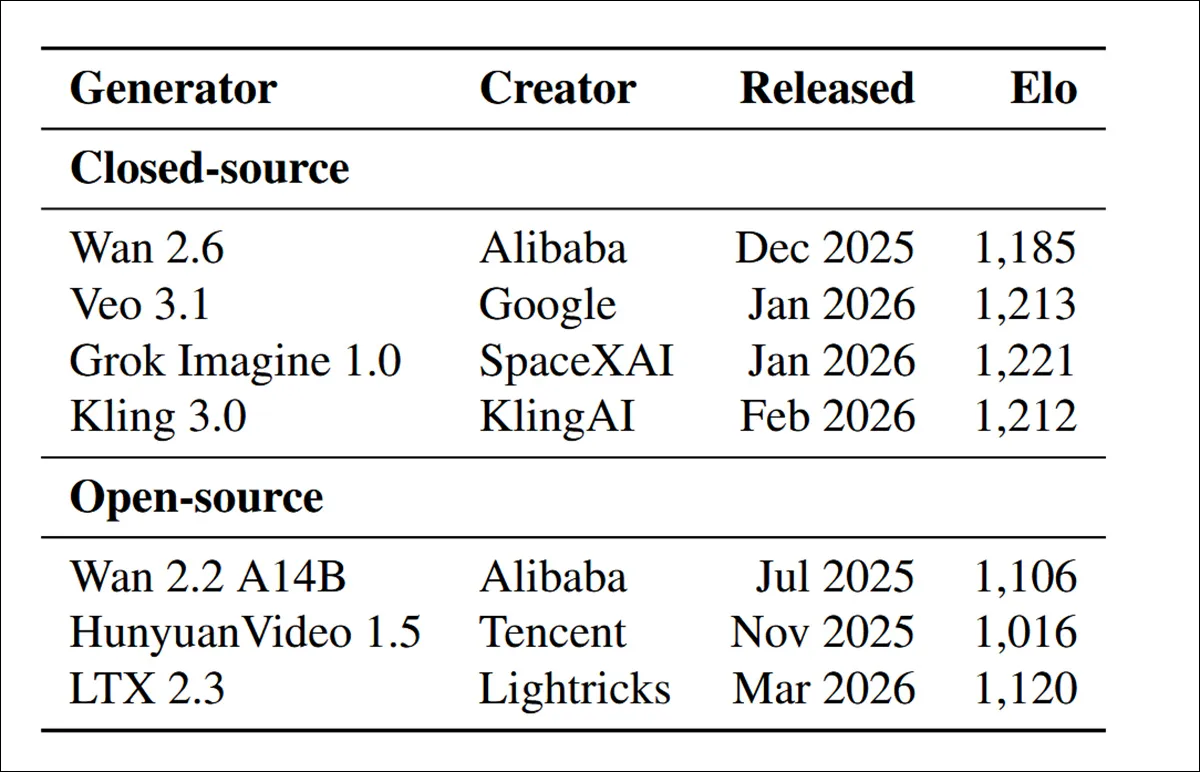
این مطالعه هم APIهای تجاری بسته و هم مدلهای وزنهای باز (Open Weights) را آزمایش کرد. مدلهای تجاری که در دور زدن تشخیص موفقترین بودند عبارت بودند از: Grok 1.0، Kling 3.0، Veo 3.1 و Wan 2.6.
به دلیل قوانین سختگیرانهی خدمات (TOS) و فیلترهای ضد جعل در مورد «تولید دیپفیک»، محققان عمدتاً از تولید «متن به ویدئو» (T2V) برای این پلتفرمها استفاده کردند. تلاشها برای تولید «تصویر به ویدئو» (I2V) اغلب باعث فعال شدن فیلترها یا نقض قوانین پلتفرم میشد.
در بخش متنباز، مدلهای Wan 2.2 A14B، HunyuanVideo 1.5 و LTX 2.3 مورد آزمایش قرار گرفتند. سری LTX بهدلیل توانایی در تولید گفتار همگامسازی شده (Synchronized Speech)، متقاعدکنندهترین جعلها را خلق کرد و قدرت ترغیب ویدئوها را افزایش داد.
نقاط شکست فنی
پژوهشگران عملکرد را با استفاده از سطح زیر منحنی ویژگی عملیاتی گیرنده (AUROC) و نرخ خطای برابر (EER) اندازهگیری کردند. آنها دریافتند که اکثر تشخیصدهندهها در محکهای قدیمی مثل CelebDF++ (CDFv3) عالی عمل میکنند اما در DF26 شکست میخورند.
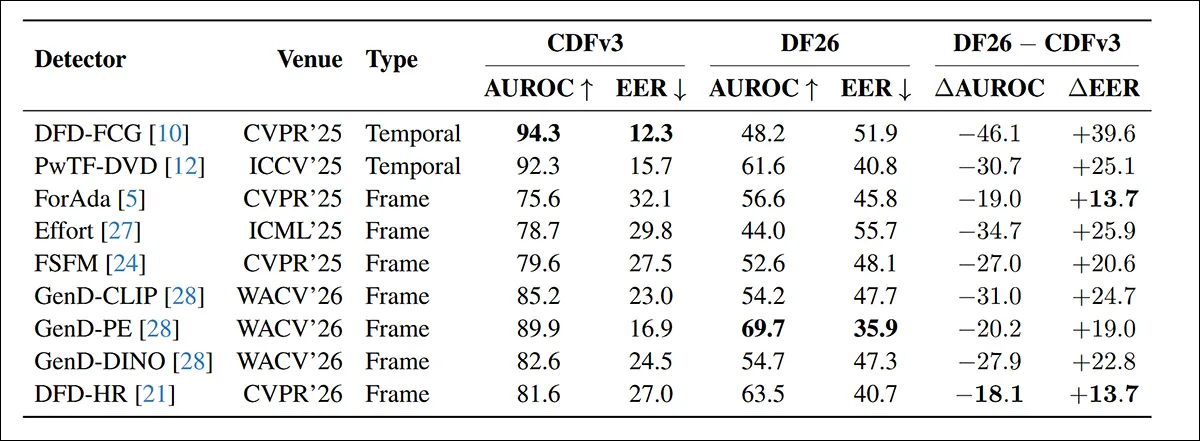
یافتههای کلیدی این مرحله عبارتند از:
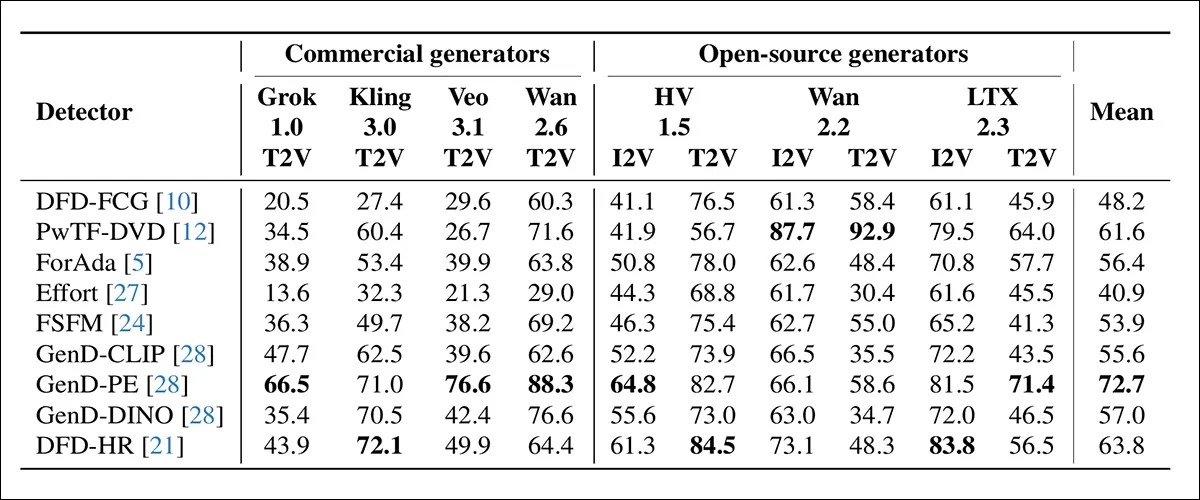
- زمانی در برابر فریممحور: تشخیصدهندههای فریممحور ۳۲ فریم با فاصله مساوی را در هر ویدئو بررسی کردند. اما تشخیصدهندههای زمانی (که توالی ویدئو را تحلیل میکنند)، شاهد سقوط AUROC از ۹۴.۳ و ۹۲.۳ در CelebDF++ به ۴۸.۲ و ۶۱.۶ در DF26 بودند.
- I2V در برابر T2V: محتوای «تصویر به ویدئو» (I2V) برای انسان و ماشین بهطور قابلتوجهی سختتر از «متن به ویدئو» (T2V) بود. مدل PwTF-DVD در I2V و GenD-PE در T2V بهترین عملکرد را داشتند.
- وابستگی به مولد: تشخیصدهندهها بهجای یادگیری امضای کلی ویدئوهای سنتتیک، ردپاهای «مختص به هر مولد» را یاد گرفته بودند. مثلاً PwTF-DVD در مدل Wan 2.2 نمره ۹۲.۹ AUROC گرفت اما در HunyuanVideo 1.5 به سطحی نزدیک به شانس (۵۰٪) سقوط کرد.
تفاوتهای عملکردی
مطالعه تفاوت شدیدی را بین نحوه برخورد تشخیصدهندهها با محتوای متنباز در مقابل محتوای تجاری نشان داد. تشخیصدهندههای زمانی با مدلهای تجاری بسیار بیشتر دستوپا زدند:
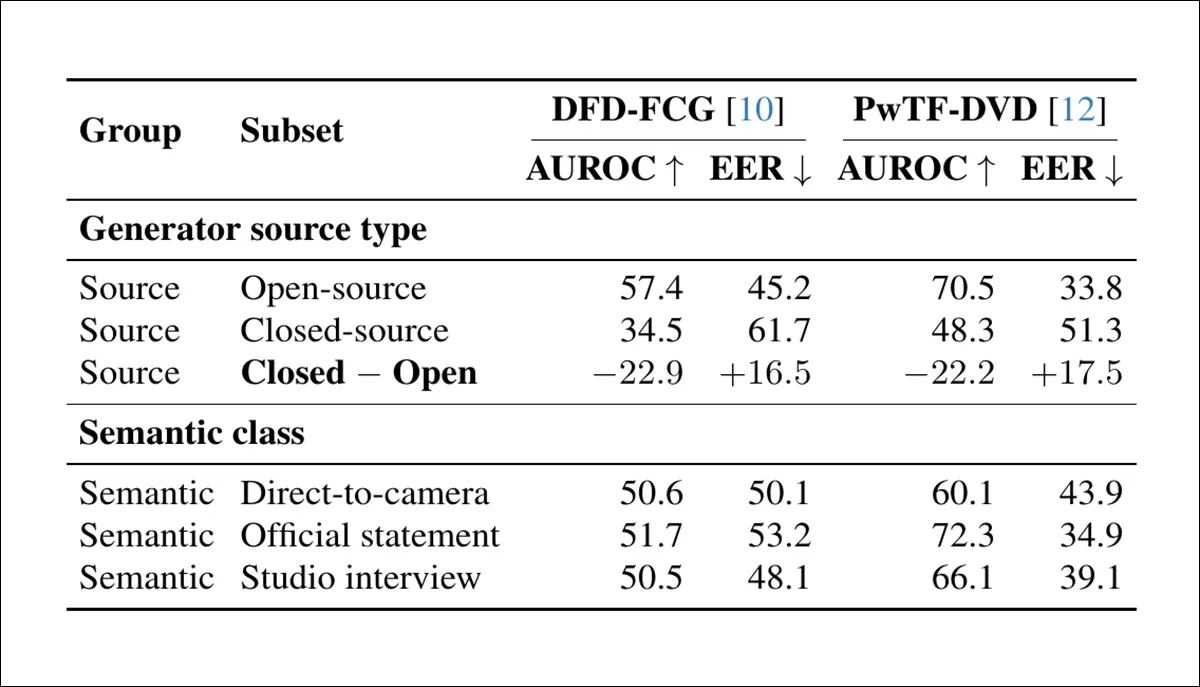
- DFD-FCG: از ۵۷.۴ AUROC در محتوای متنباز به ۳۴.۵ در ویدئوهای تجاری رسید.
- PwTF-DVD: از ۷۰.۵ AUROC در متنباز به ۴۸.۳ در ویدئوهای تجاری سقوط کرد.
جالب اینجاست که نوع صحنه (غیررسمی، رسمی یا مصاحبه) اهمیت بسیار کمتری نسبت به مدل مولد مورد استفاده داشت. مدل DFD-FCG در هر سه سناریو نزدیک به سطح شانس باقی ماند، در حالی که PwTF-DVD در بیانیههای رسمی بهترین عملکرد را داشت. نویسندگان پیشنهاد میکنند تفاوت در خانوادهی مدل، پسپردازش و کیفیت بصری، عوامل اصلی هستند نه محیط صحنه.
عنصر انسانی
این مطالعه شامل یک آزمایش انسانی با ۲۳۲ جلسه برچسبگذاری بود. شرکتکنندگان باید ویدئوهای DF26، CelebDF++ و DeepSpeak v2 را بدون دانستن توزیع کلاسها، به عنوان واقعی یا جعلی تشخیص میدادند.
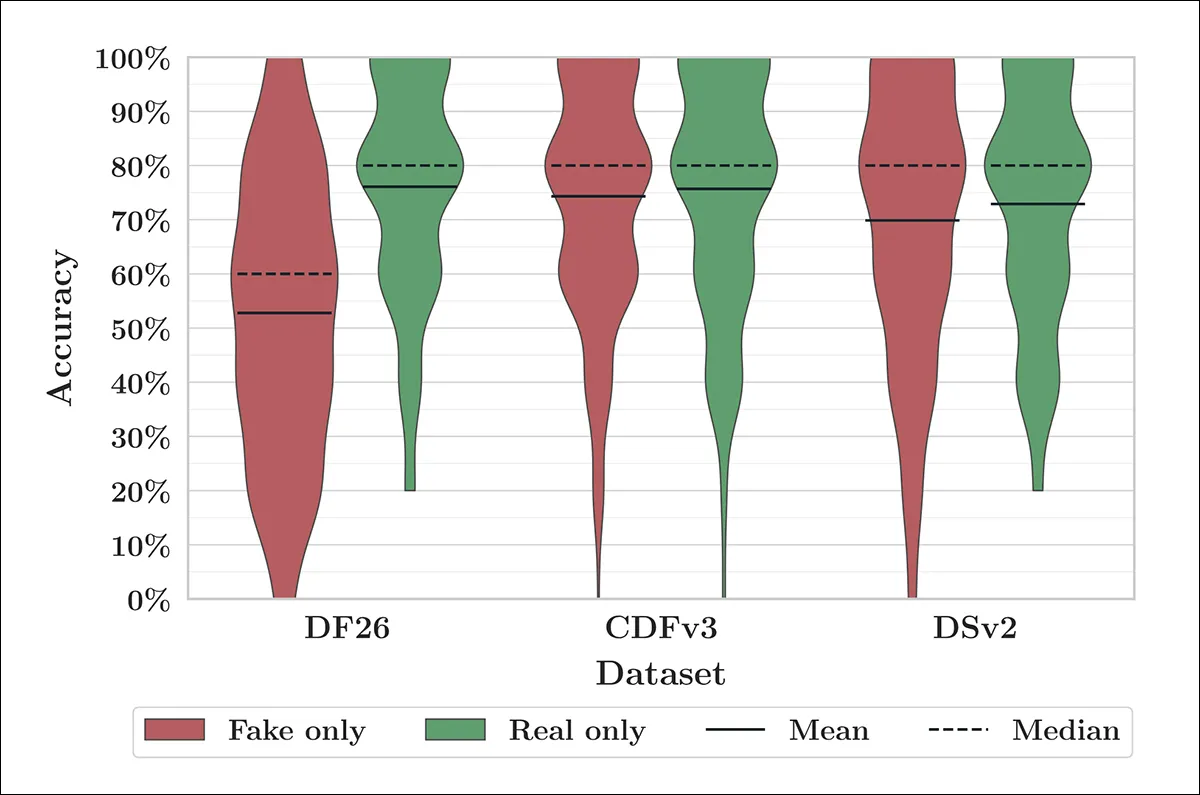
دقت در شناسایی ویدئوهای واقعی در تمام مجموعهدادهها ثابت ماند: ۷۶.۰٪ برای DF26، ۷۵.۵٪ برای CelebDF++ و ۷۲.۸٪ برای DeepSpeak v2. اما توانایی شناسایی ویدئوهای جعلی در مجموعه DF26 به ۵۲.۶٪ رسید؛ یعنی بهسختی بهتر از پرتاب سکه. این در حالی است که در مجموعههای قدیمیتر، این عدد ۷۴.۵٪ و ۶۹.۸٪ بود.
این یعنی انسانها لزوماً فریب نمیخورند تا هر جعلی را باور کنند، اما دیگر نمیتوانند شواهد بصری مشخصی را که برای اثبات سنتتیک بودن ویدئو لازم است، پیدا کنند. این یافته با گزارش سال ۲۰۲۴ که توانایی تشخیص انسانی را تنها ۵۷٪ (نه چندان بالاتر از شانس) اعلام کرده بود، همسو است.
بازآموزی و بازیابی
یک راه نجات وجود دارد: بازآموزی تشخیصدهندهها با دادههای جدید. وقتی تشخیصدهندهی GenD-PE روی دادههای DF26 بازآموزی شد، تواناییاش در شناسایی ویدئوهای تولید شده توسط مولدهای دیده نشده بهطور چشمگیری بهبود یافت.
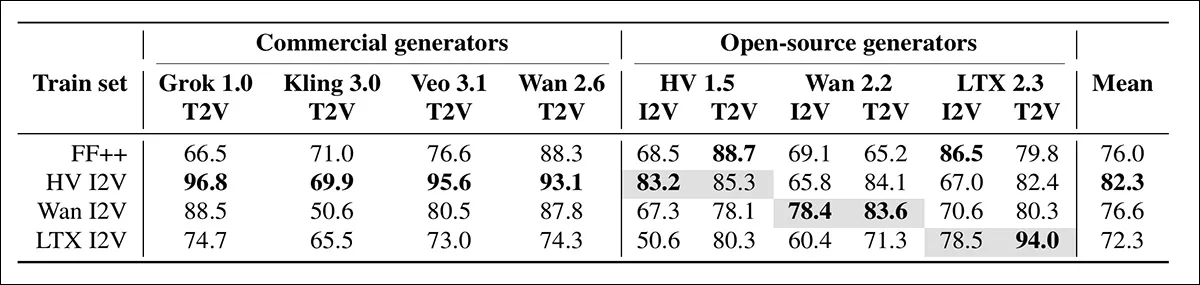
آموزش روی HunyuanVideo 1.5 باعث شد AUROC برای مدلهای Grok Imagine 1.0، Veo 3.1 و Wan 2.6 به حداقل ۹۳.۱٪ برسد. این تایید میکند که شکست، ذاتیِ فناوری تشخیص نیست، بلکه نتیجهی آموزش روی مجموعهدادههای منسوخی مثل FaceForensics++ است.
تحلیل: شکاف اعتماد
برای جامعه فنی، این مطالعه پایان عصر «جایگزینی داخلی صورت» است. این فرض که میتوانیم جعل عمیق را با جستوجوی ناهنجاریهای چهره تشخیص دهیم، اکنون یک ریسک و نقطه ضعف است. ما وارد دورهای میشویم که تشخیص باید کلنگر باشد و بهجای تمرکز بر چهره، کل فریم و ثبات زمانی را تحلیل کند.
از منظر امنیتی، تمرکز بر ویدئوهای «سرِ سخنگو» نگرانکننده است. این فرمتها از رابطهی اعتماد پیشفرض بین یک اینفلوئنسر یا گوینده خبر و مخاطب استفاده میکنند. این اعتماد، بهویژه در گزارشهای خبری یا مصاحبههای ماهوارهای، جایی که فرض بر اعتماد قبلی است، بستر مناسبی برای سوءاستفاده است.
وقتی نشانگرهای فنی جعل ناپدید میشوند، تنها دفاع باقیمانده «اعتماد منطقی» (Reasonable Credulity) است که یک قوه انسانی ذهنی و غیرقابلاعتماد است. این موضوع در بسترهای اطلاعاتی که پتانسیل سوءاستفاده در آنها بالاست، بهشدت خطرناک است.
نتیجهگیری
با وجود گزارش افزایش ۱۶ برابری فراوانی دیپفیکها در دو سال گذشته، واقعیتِ دیپفیکهای بدخواهانه تا حد زیادی از تجربه عادی مردم دور است، مگر اینکه کسی بهطور مشخص هدف قرار گرفته باشد. این موضوع بهویژه برای قربانیان دیپفیکهای جنسی یا کسانی که هدف کلاهبرداری قرار گرفتهاند صادق است.
همانطور که از «عصر طلایی» خودرمزگذارها به دوران دقیقتر دیپفیکهای مبتنی بر انتشار میرویم، مردم نیاز به مواجهه بیشتر با مواد جعلی واقعی دارند تا زمینه ذهنی خود را بهروز کنند. در حال حاضر، بیشتر خروجیهای هوش مصنوعی در پلتفرمهای اجتماعی ظاهر میشوند، جایی که ناظران یا نمیتوانند هوش مصنوعی را از واقعیت تشخیص دهند یا بهسادگی اهمیتی به آن نمیدهند. این روند در مقیاسهای صنعتی نیز مشهود است؛ برای مثال، در چین اکنون ۹۵٪ درامهای کوتاه با هوش مصنوعی تولید میشوند که نشاندهنده پذیرش گسترده محتوای سنتتیک در صنعت سرگرمی است.
از آنجایی که تشخیص از تولید عقب مانده است، صنعت ممکن است مجبور شود به سمت استانداردهای «اثبات منبع» (Provenance) تغییر مسیر دهد. برای یک دوره انتقالی، تا زمانی که با این قابلیتهای رو به رشد سازگار شویم، شاید مجبور باشیم قضاوت دربارهی اصالت ویدئوهای دیجیتال را به تعویق بیندازیم.
گام بعدی شما
- اگر مسئول امنیت یا مدیریت محتوا هستید، ابزارهای تشخیص خود را از مدلهای چهرهمحور به مدلهای تحلیل زمانی (Temporal) ارتقا دهید.
- برای اعتبارسنجی ویدئوهای حساس، بهجای تکیه بر ابزارهای خودکار، از متد «تأیید منبع» (Provenance) و امضاهای دیجیتال استفاده کنید.
- در برابر ویدئوهای «سر سخنگو» که از منابع غیررسمی منتشر میشوند، اصل عدماعتماد را جایگزین تحلیل بصری کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و نقش آنها در تسریع مدلهای انتشار مراجعه کنید.



گفتگو