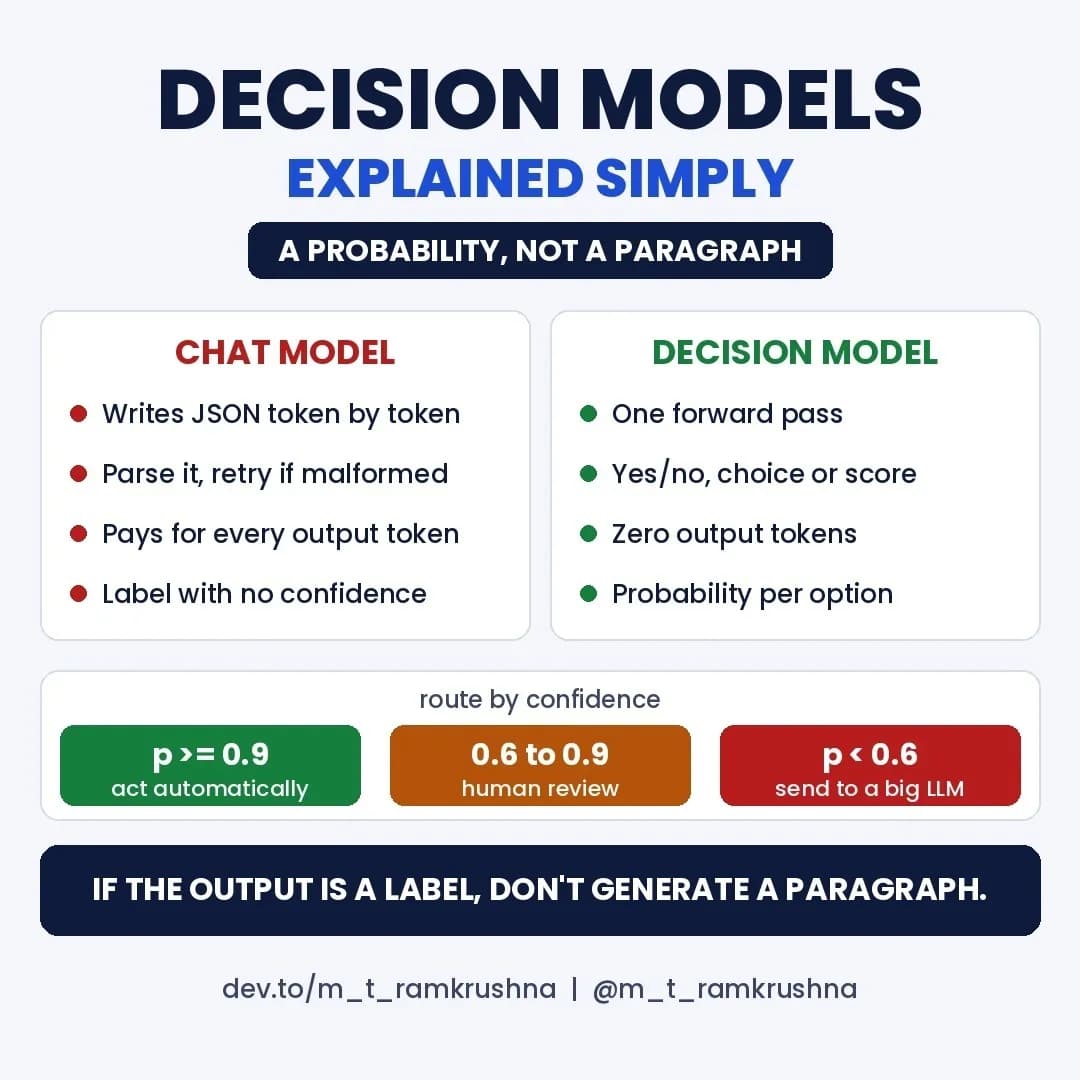
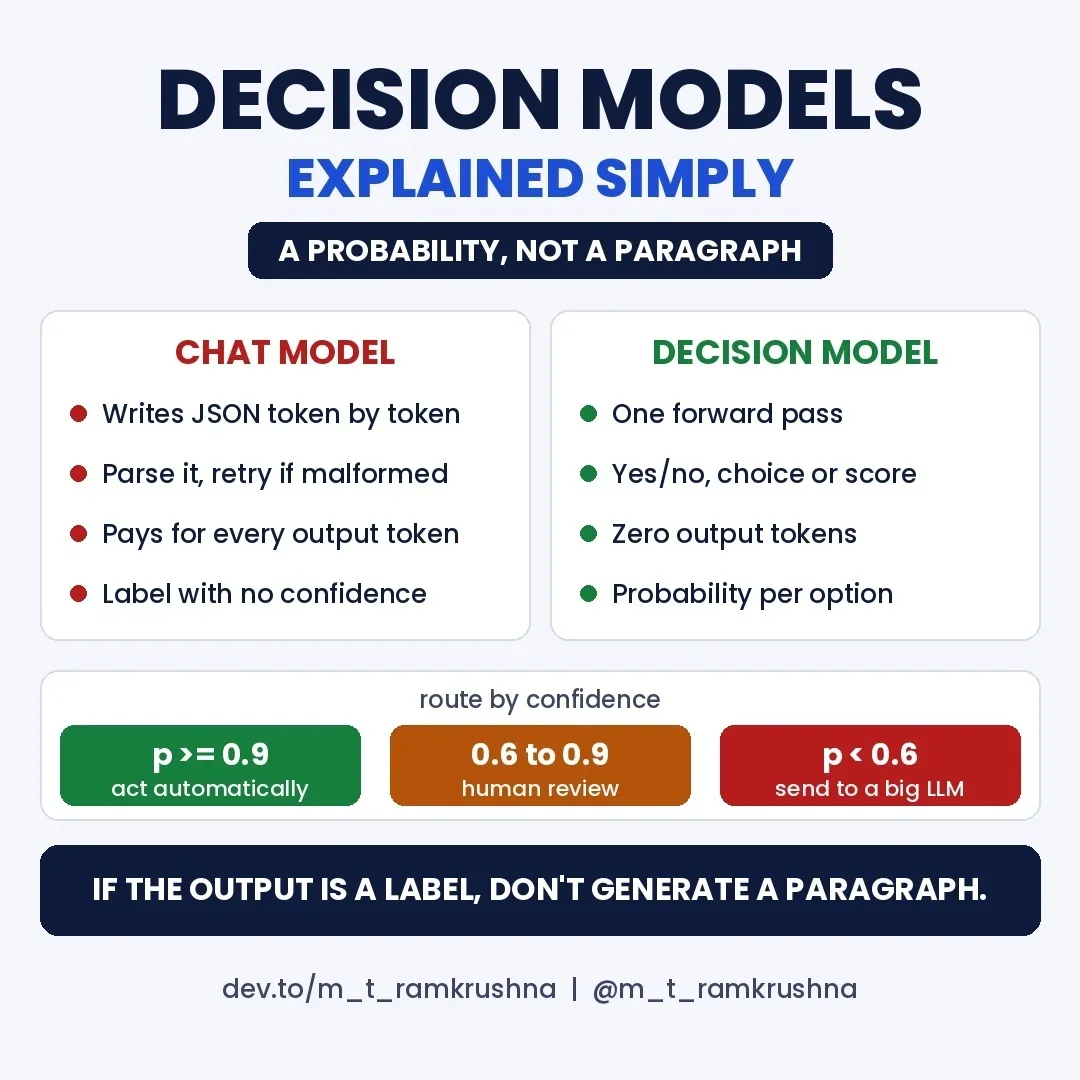
تصور کنید مدیر یک تیم پشتیبانی هستید و هر روز هزاران تیکت با جملاتی مثل «این ماه دو بار از حسابم کسر شده، یکی را برگردانید» دریافت میکنید. اگر برای طبقهبندی این پیامها از مدلهای چت استفاده کنید، باید هر بار منتظر بمانید تا مدل کلمه به کلمه پاسخ دهد و سپس امیدوار باشید که فرمت JSON خروجی هیچ غلط املایی یا فاصله اضافی نداشته باشد.
این فرآیند نهتنها کند است، بلکه برای یک پاسخ ساده، توکنهای زیادی مصرف میکند. این چالشها دقیقاً همان موانعی هستند که در بررسی هزینههای پنهان خطاهای JSON در طبقهبندی فاکتورها به آنها پرداختیم. شرکت Liquid AI در ۷ اکتبر ۲۰۲۶ با معرفی خانواده مدلهای d1، این الگوی قدیمی را شکست. این مدلها بهجای تولید متن، پاسخهای تایپشده و احتمالات را در یک مرحله (Forward Pass) برمیگردانند.
بسیاری از توسعهدهندگان در حال حاضر از مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بهعنوان طبقهبندیکنندهای استفاده میکنند که «لباس چت» پوشیده است. در این حالت، مدل باید توکنها را بهصورت متوالی تولید کند؛ یعنی یک توکن میسازد، آن را به ورودی برمیگرداند و توکن بعدی را تولید میکند. حتی یک پاسخ کوتاه JSON هم به دهها مرحله متوالی نیاز دارد و شما برای هر کاراکتر از برچسبی که خودتان تعریف کردهاید، هزینه پرداخت میکنید.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی استنتاج در لبه اشاره کردیم، حذف مراحل تکراری کلید افزایش سرعت است. مدلهای تصمیمگیرنده، طبقهبندی را بهجای یک وظیفه تولید متن، بهعنوان یک خروجی ریاضی مستقیم میبینند. بهجای نوشتن کلمه «حسابداری»، مدل ورودی را یکبار میخواند و پاسخ را مستقیماً از لایه نهایی استخراج میکند. به نقل از MarkTechPost، این وضعیت «صفر توکن خروجی» نام دارد و بهینهترین روش برای مدیریت طبقهبندی است.
خانواده مدلهای d1
شرکت Liquid AI دو نسخه با وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پخت آنها علناً منتشر شده و نه فقط غذای آماده — را برای این پژوهش عرضه کرده است:
- d1-3B: مدلی با ۳.۱ میلیارد پارامتر که بر پایه مدل بینایی-زبانی LFM2.5-VL-3B آموزش دیده و متن و تصویر را پردازش میکند.
- d1-omni-600M: مدلی کوچکتر با ۵۸۷ میلیون پارامتر که از یک رمزگذار دوطرفه استفاده میکند و از ترکیب متن با تصویر یا تا ۳۰ ثانیه صوت پشتیبانی میکند.
عملکرد و تأخیر
به دلیل حذف تولید متوالی توکنها، تأخیر (Latency) — همان فاصله زمانی بین پرسش و دریافت پاسخ — به میلیثانیه میرسد. طبق دادههای منتشر شده در Hugging Face، مدل d1-3B روی سختافزارهای مختلف سرعتهای زیر را ثبت کرده است:
- NVIDIA RTX 4090: ۸ میلیثانیه برای یک پرسش؛ ۲۱ میلیثانیه برای سه پرسش.
- Jetson AGX Thor: ۱۶ میلیثانیه برای یک پرسش؛ ۲۰ میلیثانیه برای سه پرسش.
- Jetson AGX Orin 64 GB: ۲۶ میلیثانیه برای یک پرسش؛ ۳۵ میلیثانیه برای سه پرسش.
- Jetson Orin Nano: ۵۰ میلیثانیه برای یک پرسش؛ ۷۳ میلیثانیه برای سه پرسش.
در زمینه کیفیت، Liquid AI میانگین امتیاز ۸۲.۹ را در هفت محک عمومی متن گزارش کرده است. با این حال، طبق گزارش ModelSystem.One، دادههای رسمی این شرکت مربوط به بازه زمانی پیش از کارتهای مدل فعلی است و کاربران باید تا رسیدن ارزیابیهای مستقل، با احتیاط با این اعداد برخورد کنند.
مکانیزمهای فنی و پیادهسازی
استفاده از این مدلها نیازمند تغییر در تعریف وظایف است. بهجای پرامپتهای متنی طولانی، پرسشها بهعنوان داده تعریف میشوند. این مدلها از سه نوع خروجی پشتیبانی میکنند:
- noul: پاسخهای بله/خیر.
- choice: انتخاب از بین چندین گزینه.
- score: امتیازدهی در یک مقیاس مشخص.
از آنجا که فضای خروجی توسط پرسش ثابت شده است، مدل نمیتواند دست به توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه تعریف میکند — بزند یا دستهبندی جدیدی اختراع کند.
قدرت احتمالات
این مدلها بهجای یک برچسب قطعی، یک توزیع احتمالی برمیگردانند. مثلاً بهجای عبارت «حسابداری»، خروجی به این شکل است: «حسابداری ۰.۹۱، کلاهبرداری ۰.۰۷، فنی ۰.۰۲». این قابلیت به توسعهدهندگان اجازه میدهد «مسیریابهای اطمینان» بسازند.
در محیط عملیاتی، اگر احتمال بالای ۰.۹۰ باشد، اقدام بهصورت خودکار انجام میشود؛ اگر بین ۰.۶۰ تا ۰.۹۰ باشد، تیکت برای بررسی انسانی ارسال میشود و در موارد سخت، درخواست به یک مدل زبانی بزرگ و گرانقیمت ارجاع داده میشود. این رویکرد شباهت زیادی به متدهای امتیازدهی اعتماد داده برای شناسایی ریسکهای عملیاتی دارد که دقت نظارت بر مدلها را افزایش میدهد.
موارد استفاده ایدهآل
این معماری برای تصمیمات حجیم با تأخیر کم عالی است:
- نظارت بر محتوا: فیلترهای ایمنی که باید روی تکتک پیامها اجرا شوند.
- مسیریابی قصد کاربر: ارسال تیکتها به تیم مربوطه بر اساس نیاز مشتری.
- ارزیابی مرتبط بودن در RAG: بررسی اینکه آیا تکه متن بازیابیشده واقعاً پاسخ سوال است یا خیر.
- حفاظهای عاملها: تأیید ایمنی یک فراخوانی ابزار در یک حلقه عاملمحور (Agentic).
- هوش مصنوعی لبه: بازرسی بصری در رباتها یا کیوسکها بدون دسترسی به شبکه.
این مدل برای کارهای باز مانند خلاصهسازی یا استدلالهای پیچیده چندمرحلهای مناسب نیست، زیرا در آنجا فرآیند «تفکر» مدلهای بزرگتر واقعاً اثرگذار است.
چرخش اقتصادی
برای یک صاحب کسبوکار، این یک استراتژی کاهش هزینه است. با سپردن تصمیمات ساده و مطمئن به یک مدل کوچک و سریع در لبه، بودجه مدلهای پیشرو و گرانقیمت را برای موارد واقعاً دشوار ذخیره میکنید.
بر اساس گزارش MarkTechPost، مدلهای باز d1 تحت لایسنس LFM Open v1.0 هستند و برای شرکتهایی با درآمد سالانه زیر ۱۰ میلیون دلار رایگاناند. البته باید توجه داشت که مدل d1-omni-600M هنوز در مراحل اولیه پژوهشی است و بنچمارکهای صوتی آن هنوز یک «مسئله باز» است.
این عرضه نشاندهنده یک روند کلی در صنعت است: فاصله گرفتن از رابطهای چت «یکسایز برای همه». وقتی هدف یک تصمیم است، مدلی که فقط تصمیم میگیرد، سریعتر، ارزانتر و قابلاعتمادتری است.
گام بعدی شما
- فهرستی از تمام فراخوانیهای LLM در محصولتان که خروجی آنها یک برچسب، بله/خیر یا امتیاز است تهیه کنید.
- برای این موارد، مدل d1-3B را جایگزین کنید تا کاهش تأخیر و هزینه را بسنجید.
- آستانه احتمالات (Confidence Threshold) را بر اساس دادههای برچسبگذاریشده خودتان کالیبره کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو