اگر برای کارهای سادهای مثل فعال کردن محیطهای مجازی (Virtual Environments) هر ماه هزینه اشتراک Copilot میپردازید، باید بدانید که یک جایگزین رایگان و بسیار سریعتر از مدلهای تریلیونی وجود دارد. ادعای مرکزی پروژه TERMy این است که درخواستهای پیچیده زبان طبیعی لزوماً به هوش مصنوعی زاینده (Generative AI) نیاز ندارند تا مؤثر باشند.
این تغییر رویکرد در حالی رخ میدهد که توسعهدهندگان با افزایش هزینهها و تأخیر (Latency) در سرویسهای ابری روبهرو هستند. در حالی که صنعت به سمت مدلهای بزرگتر میرود، نیاز به ابزارهای سبک و پیشبینیپذیر برای کارهای تکراری، خلأیی را برای راهکارهای غیر احتمالی ایجاد کرده است. این رویکرد در واقع پاسخی به نیاز برای جایگزینی وظایف تکراری و دستی با گردشکارهای اتوماسیون است تا بهرهوری توسعهدهندگان افزایش یابد.
به نقل از گزارش توسعه منتشر شده در ۴ سپتامبر ۲۰۲۶، سازنده این پروژه دو ماه را صرف آزمایش معماریهای مختلف هوش مصنوعی کرد و در نهایت آنها را به نفع یک رویکرد قطعی (Deterministic) کنار گذاشت. هدف اولیه، رهایی از هزینههای ماهانه برای عملیاتهای ساده بود.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، تمایل به انتقال پردازش از ابر به لبه (Edge) در حال افزایش است. این پروژه دقیقاً در همین راستا قرار دارد.
سازنده TERMy پیشینهای در تحقیق و توسعه دارد و پیش از این پروتکل PJON را در سال ۲۰۱۰ طراحی کرده بود؛ پروتکولی که اخیراً توسط دانشگاه ETH Zurich در قالب سختافزار پیادهسازی شده است. او از اوایل جولای ۲۰۲۶، در دورهای که قیمت توکنها افزایش یافت، تصمیم گرفت دستیاری بسازد که بدون هزینههای سنگین، درخواستهای زبان طبیعی را در ترمینال اجرا کند.
او ابتدا سعی کرد مدلهای مولد را روی یک سیستم قدیمی با پردازنده i7-4790K، ۱۶ گیگابایت رم و گرافیک GTX 1050 Ti آموزش دهد. او برای اجبار خود به مینیمالیسم، محیطی محدود ایجاد کرد و متدهایی مثل Mamba و چارچوبهای مشابه NanoGPT با ۱۰۰ تا ۲۰۰ میلیون پارامتر را آزمایش کرد. او دادههای خود را از کتابهای رایگان Project Gutenberg و مجموعههای Huggingface تأمین کرد.
اما نتایج طبق گزارش او «ترسناک و تلفکننده» بود. مدلها مدام در حلقههای بینهایت میافتادند یا متون بیمعنی تولید میکردند. حتی استفاده از مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده و فقط غذای آماده نیستند — از طریق Ollama و مدلهایی مثل mistral:7b، در محیطی با ۴ گیگابایت حافظه ویدیویی (VRAM) بسیار کند و غیرقابلاعتماد بود.
برای حل این مشکل، او NPC-Forge را خلق کرد؛ چارچوبی که بهطور کامل بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است تا همسایگی کلمات را مشخص کند — و یادگیری ماشین را حذف میکند. در عوض، این سیستم بر فرمت دادهای NDF 0.0 تکیه دارد.
در NDF، دانش به صورت «اتمهای مستقل» تعریف میشود. برای مثال، درخواست «لیست فایلها» مستقیماً به یک شیء JSON متصل است که دستور ls -lah و کلید دسترسی را در خود دارد. برای مدیریت متغیرها (مثل نام فایل)، سیستم از رویکرد قالبمحور استفاده میکند. این یعنی NPC میتواند فوراً قابلیتهای جدید یاد بگیرد؛ مثلاً برای اضافه کردن دستورات Docker، فقط کافی است یک فایل JSON به دایرکتوری اضافه شود — فرآیندی که سازنده آن را به یادگیری سریع نئو در فیلم ماتریکس تشبیه کرده است. این متدولوژی در تضاد با مدلهای بازارمحور و مهندسی پرامپت برای عاملهای هوشمند است که بر تنظیمات پیچیده مدلهای زبانی تکیه دارند.
جزئیات فنی این سیستم شامل موارد زیر است:
- برچسبهای واژگان: تگهایی مثل
<||vocab_create||>که به مترادفهایی چون «ساختن» یا «تولید کردن» متصل هستند. - استخراج با Regex: شناسایی موجودیتها (مثل نام فایل) از طریق الگوهای منظم.
- دستورات پویا: اجرای زنجیرهای دستورات برای ایجاد فایل و همزمان تنظیم زمینه (Context) فعال.
منطق اصلی سیستم در کلاسهای FlintParser و FlintNPC پیاده شده که در مجموع حدود ۱۰۰۰ خط کد پایتون و جاوااسکریپت هستند. این خط لوله (Pipeline) ابتدا نویزها (مثل کلمات تشکر یا فحشها) را حذف میکند و سپس ارزانترین مسیرها را برای یافتن جواب میجوید:
۱. حذف نویز
۲. تحلیل احساسات (Sentiment Analysis)
۳. تطابق دقیق (Exact Match) برای دستورات شناختهشده
۴. تطابق قالبی (Template Match) برای درخواستهای متغیر
۵. تطابق احتمالی (Probabilistic Match) با استفاده از روشهایی مثل IDF و Levenshtein برای مدیریت غلطهای املایی.
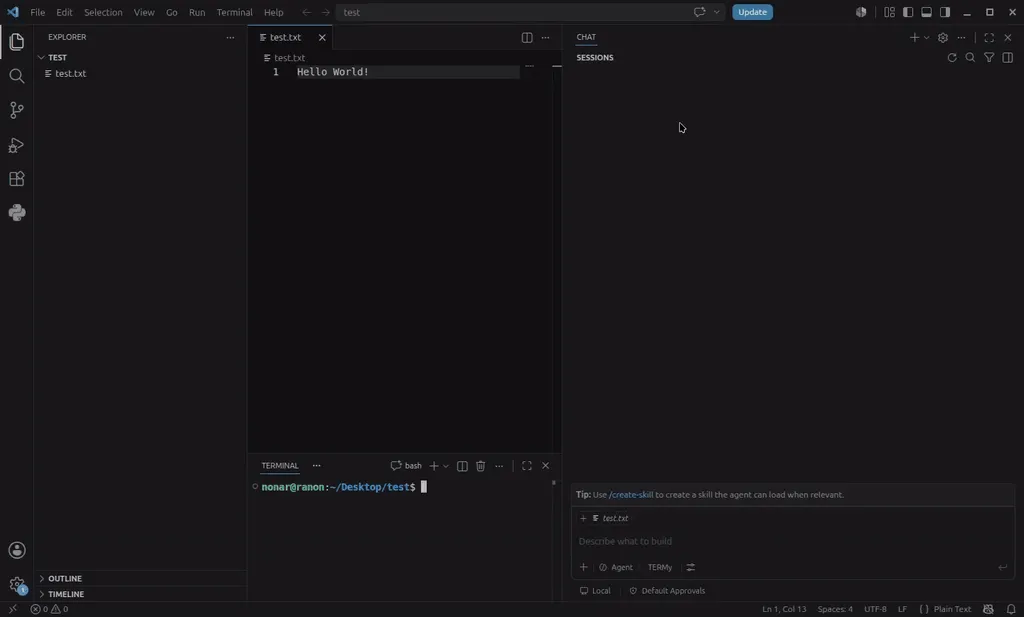
ایمنی در این سیستم از طریق یک دروازه دسترسی قطعی مدیریت میشود. دستوراتی که در مجموعه داده با برچسب ask مشخص شدهاند، پیش از اجرا نیاز به تأیید انسانی دارند. به دلیل سبک بودن، این سیستم روی یک Raspberry Pi Zero یا حتی یک روتر با تأخیر میلیثانیهای اجرا میشود.
سازنده معتقد است سرویسهای بزرگی مثل Copilot باید کارهای ساده را به این NPCهای قطعی بسپارند و فقط در موارد پیچیده از مدلهای زبانی بزرگ استفاده کنند تا در مصرف برق و محاسبات صرفهجویی شود. همچنین، این رویکرد فیلترهای همراستاسازی (Alignment) شرکتی را دور میزند و اجازه میدهد NPC دقیقاً طبق دادههای محلی رفتار کند.
در مقایسه با چارچوبهای NLU مثل Rasa یا NLP.js که به طبقهبندیهای سنگین یادگیری ماشین نیاز دارند، NPC-Forge هیچ نیازی به آموزش ندارد و روی میکروکنترلرها نیز قابل اجراست.
گام بعدی شما
- اگر توسعهدهنده هستید، ساختار JSON-based این پروژه را برای اتوماسیون کارهای تکراری در محیط لینوکس بررسی کنید.
- برای کاهش هزینه API، شناسایی کنید کدام درخواستهای شما «ساده و تکراری» هستند و میتوانند با یک سیستم Rule-based جایگزین شوند.
- بررسی کنید آیا ابزارهای فعلی شما بیش از حد بر مدلهای احتمالی تکیه کردهاند و باعث ایجاد توهم (Hallucination) در دستورات سیستمی شدهاند یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و آینده استنتاج لبه مراجعه کنید.



گفتگو