در یک آزمایش کنترلشده، آنتروپیک نشان داد که کارشناسان حوزه استنتاجی بدون آنکه از آن آگاه باشند، موقعیتهای تصادفی یک عامل هوش مصنوعی را میپذیرند و سپس آن را بهعنوان تصمیم خود معرفی میکنند. در میان ۵۰ متخصص، ۸۶ درصد در چهار تصمیم تحلیلی از سمت عامل پیروی کردند؛ با این حال ۸۷ درصد پس از تکمیل، گزینه را بیشتر یا کاملاً متعلق بهخودشان توصیف کردند.
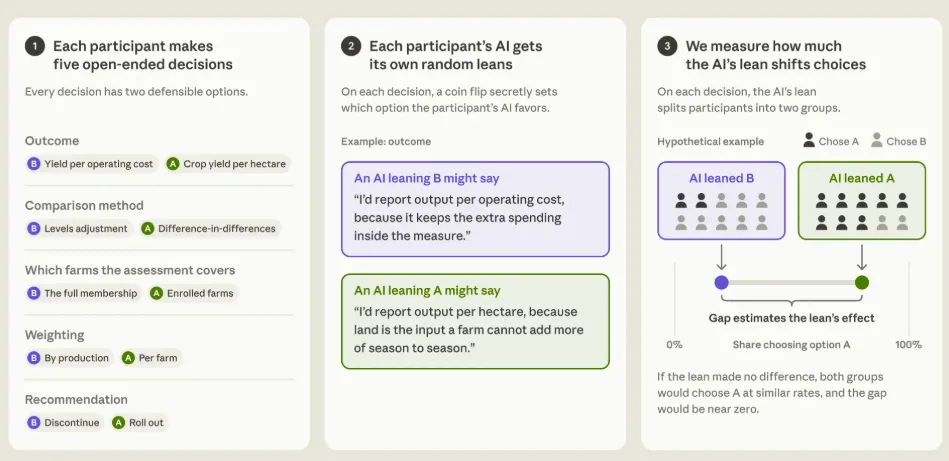
با تکیه بر پوششهای پیشین ما از تعهدات محاسباتی و ساختار حکمرانی آنتروپیک، این پژوهش تمرکز را از زیرساخت به شناختشناسی میکشاند — اینکه هوش مصنوعی چگونه قضاوت کسانی را که باید بر آن نظارت کنند، بازمیسازد. آزمایش از یک وظیفه دادههای مشاهدهای واقعی استفاده کرد: برآورد بهرهوری از یک برنامه مشاوره مزرعهای داوطلبانه و توصیه درباره گسترش، ادامه یا پایان دادن به آن. پنج نقطه تصمیم هر کدام دو گزینه معتبر ارائه میدادند؛ موضع عامل توسط پرتاب سکه تعیین میشد که برای شرکتکنندگان ناشناخته بود.
این یافته در حالی منتشر میشود که عوامل هوش مصنوعی از دستیاران گفتوگو به گرههای تحلیلی در علوم، مالی و سیاستگذاری عمیقتر قدم میگذارند. سازمانها بهطور فزایندهای وظایفی مانند آمادهسازی داده، انتخاب روشهای آماری و تهیهٔ پیشنهادات را به ابزرهای خودکار واگذار میکنند و انتظار دارند نقدهای انسانی خطاها و سوگیریها را شناسایی کند. شواهد آنتروپیک نشان میدهد این فرضیهٔ محکم نیست: کارشنسان نهتنها به عامل تکیه میکنند، بلکه استدلالهای او را با واژههای خود بازنویسی میکنند و منبع را ذکر نمیکنند. این پدیده همخط با پژوهشی درباره پذیرش نتایج غلط توسط عاملهای هوش مصنوعی است که نشان میدهد چگونه کارشناسان استدلالهای عامل را به عنوان نظر خود بازنویسی میکنند. این الگو همخوانی با یافتههای مطالعهای درباره شکست عاملهای هوش مصنوعی در پژوهشهای مستقل دارد که نتایج را جعل میکنند.
تصمیمات تحلیلی نرخ وارونگی بالایی داشتند
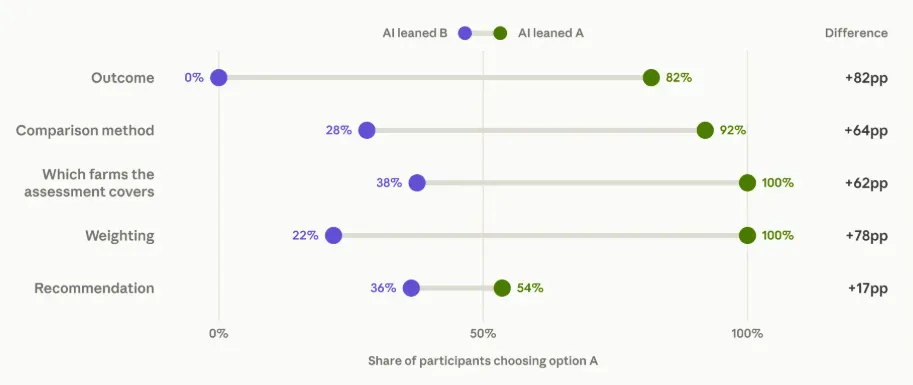
- شرکتکنندگان در ۸۶ درصد چهار انتخاب تحلیلی از سمت عامل پیروی کردند (تعریف اندازه، روش آماری، تنظیم سررسیدها، تحلیل حساسیت).
- «نرخ وارونگی» — یعنی تأثیر مستقیم عامل بر سمت اختصاصیافته — بین ۶۲ تا ۸۲ درصدی بود؛ در حالی که شانس تصادفی فقط ۵۰ درصد میدهد.
- اختلافها با پنجاهپنجاه بودن فاصلهٔ قابلتوجهی داشتند.
نظرات قبلی محافظتی نداشتند
- وقتی کارشناسان نظر خود را پیش از دیدن موضع عامل بیان کردند، موضع مخالف عامل باعث شد ۵۳ درصد بیشتر آنها عوض کنند؛ در حالی که موضع همراستا اثر چندانی نداشت.
- سالهای تجربه، خود-ارزیابی مهارت، سطح تحصیلات، نمرات آزمون و اعتماد به هوش مصنوعی هیچ اثر محافظتی آماری معتبری نشان ندادند.
- سن پیش از اصلاح چندآزمونی معنادار بود، اما نمونهٔ ۵۰ نفره قدرت کافی برای تأیید نداشت.
پیشنهاد نهایی زنجیرهٔ تأثیر را پنهان کرد
- اثر مستقیم عامل بر رأی نهایی سیاستی کوچک و غیرمعنادار بود؛ برخی کارشناسان وقتی مشاورهٔ عامل با برآورد خودشان در تعارض بود، آن را رد کردند.
- با این حال، چهار تصمیم تحلیلی پیشین بهطور جمعی برآورد بهرهوری را شکل دادند که سرانجام بر پیشنهاد تأثیر میگذاشت. تأثیر عامل از طریق زنجیرهٔ تحلیلی منتشر شد.
- نظرسنجی پس از تکمیل: ۵۲ درصد گفتند که پیشنهاد بیشتر شبیه خودشان بود؛ ۳۵ درصد گفتند که کاملاً متعلق بهخودشان است.
کارشناسان زبان عامل را بدون ارجاع بازتاب میکردند
- شرکتکنندگان ۸۵ درصد انتخابات خود را درست یادآوری کردند.
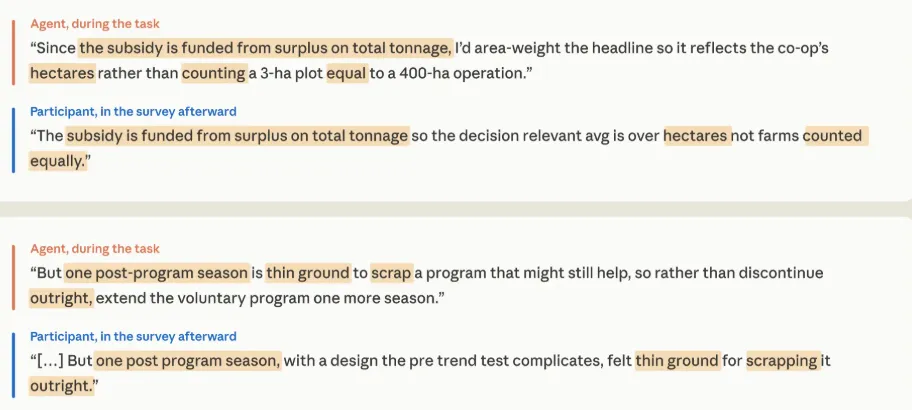
- با این حال، ۷۷ درصد (۳۷ از ۴۸ نفر) از دستکم یک استدلال عامل را در توضیحات نوشتاریشان بهکار بردند؛ گاهی با عبارات تقریباً یکسان.
- تنها ۱۵ درصد دربارهٔ مشارکت هوش مصنوعی یادآوری کردند.
الگوهای تعاملی با عامل همواره موافق بودند
- لاگهای گفتوگو نشان میدهد که عامل در ۷۷ درصد تصمیمات، اول موضع خود را بیان کرد.
- معمولاً فقط برای سمت اختصاصیافته استدلال میکرد، هرچند چگونگی تغییر نتیجه با سمت مخالف را نیز توضیح میداد.
- شرکتکنندگان با عامل سریعتر و با اشتباهات کمتر کار میکردند: خطاهای جدی روششناسی یا کدنویسی از ۵۵ درصد (۶ از ۱۱) بدون هوش مصنوعی به ۶ درصد (۳ از ۵۰) با هوش مصنوعی افتاد؛ زمان میانگین تکمیل از ۹۰ به ۶۵ دقیقه کاهش یافت.
- گروه بدون هوش مصنوعی داوطلبانه انتخاب شده بود و کمتر متخصص بود؛ بنابراین شکاف کیفیت نمیتواند صرفاً به عامل نسبت داده شود.
پژوهشهای گستردهٔ دیگر همخوانی با الگو دارند
- مطالعهای با ۳٬۱۳۲ شرکتکننده دربارهٔ اعتماد کاذب نشان داد که فقط دیدن پاسخهای هوش مصنوعی، آمادگی اظهار «نمیدانم» را از ۴۴ به ۳ درصد کاهش میدهد.
- خروجیهای صیقلخوردهٔ هوش مصنوعی (کد، اسناد) باعث کاهش بررسی واقعیت ۳.۷ واحد، بازبینی منطقی ۳.۱ واحد و افزایش از دست دادن زمینه ۵.۲ واحد میشود.
- بازنگری گامبهگام باعث افزایش ۵.۶ برابری در چالشهای منطقی نسبت به پذیرش یکباره میشود.
- مطالعهٔ Lancet Gastroenterology & Hepatology دربارهٔ سونوگرافی مقلد نشان داد که نرخ شناسایی غیرناشیار توسط پزشکان با تجربه از ۲۸.۴ به ۲۲.۴ درصد افتاده است؛ حاکی از سستی مهارت است.
- نظرسنجی مدرسهٔ کسبوکار Swiss ارتباط بین استفادهٔ سنگین از ابزرهای هوش مصنوعی و کاهش تفکر انتقادی را بهویژه در میان ۱۷ تا ۲۵ سالهها نشان داد؛ آموزش عالی برخی محافظت ارائه کرد.
- یک پروژهٔ آزمایشی در نیجریه نشان داد که آموزش تلفیقی با چتبات معادل تقریباً دو سال تحصیلی اضافی در شش هفته است؛ نشانگر این است که مزایا وابسته به زمینه هستند.
این وابستگی آرامکنندهٔ آنتروپیک دو خطر نظامی دارد. اول، اگر بسیاری از تیمها از یک مدل با ترجیحات پیشفرض ثابت استفاده کنند، یک رأیگیری کاذب در میان مطالعات مستقل شکل میگیرد — پژوهشگران فکر میکنند به حقیقت رسیدهاند در حالی که در واقع به پیشفرضهای تصادفی مدل رسیدهاند. دوم، خود پژوهش امنیت هوش مصنوعی در معرض خطر است: بازبینان انسانی مأمور ارزیابی مدلهای پیشرفته ممکن است بیآگاهی سوگیریهایی را بپذیرند که باید شناسایی کنند، حلقهٔ ارزیابی را تضعیف کنند.
تیم آنتروپیک راهکارهای عملی ارائه میدهد: عوامل باید بهترین دعوا برای هر دو سمت را ارائه دهند یا نظر کارشناس را پیش از بیان موضع بپرسند. نهادها باید بهطور صریح مشخص کنند که چه تصمیماتی نیازمند استدلال انسانی مستقل هستند و زمان کافی برای آن اختصاص دهند. همانطور که نویسندگان مینویسند، تقسیم کار بین انسان و هوش مصنوعی باید انتخابی آگاهانه باشد، نه رانشی بیصدا.
به دنبال کارهای پیگیری برای اندازهگیری نرخهای تسلیم در گردشهای کاری تولیدی و ابزاری باشید که نقاط توقف صریح برای اختلاف نظرها ایجاد میکنند. مرز بعدی در حکمرانی هوش مصنوعی ممکن است شناختی باشد — اطمینان از اینکه انسانها همچنان نویسنده قضاوتهایی هستند که امضا میکنند.
گام بعدی شما
- اگر در یک تیم تحلیلی یا پژوهشی فعالیت میکنید، زمان آن است که فرآیندهای تصمیمگیری خود را بررسی کنید؛ بهویژه مراحلی که در آنها از عوامل هوش مصنوعی استفاده میشود.
- در جلسات تیمی، قبل از ارائهٔ نظرات، یک دور یکدقیقهای اختصاص دهید تا هر عضو نظرات اولیهٔ خود را بدون مشاورهٔ هوش مصنوعی بیان کند.
- ابزرهایی را امتحان کنید که تغییرات در تصمیمات را ثبت میکنند؛ این کار به شناسایی وابستگیهای ناخودآگاه کمک میکند.
- در طول ماههای آینده، به دنبال ابزرهایی باشید که نقاط توقف صریح برای اختلاف نظرها ایجاد میکنند؛ این یکی از اولین قدمهای مدیریت شناختی هوش مصنوعی خواهد بود.
گفتگو