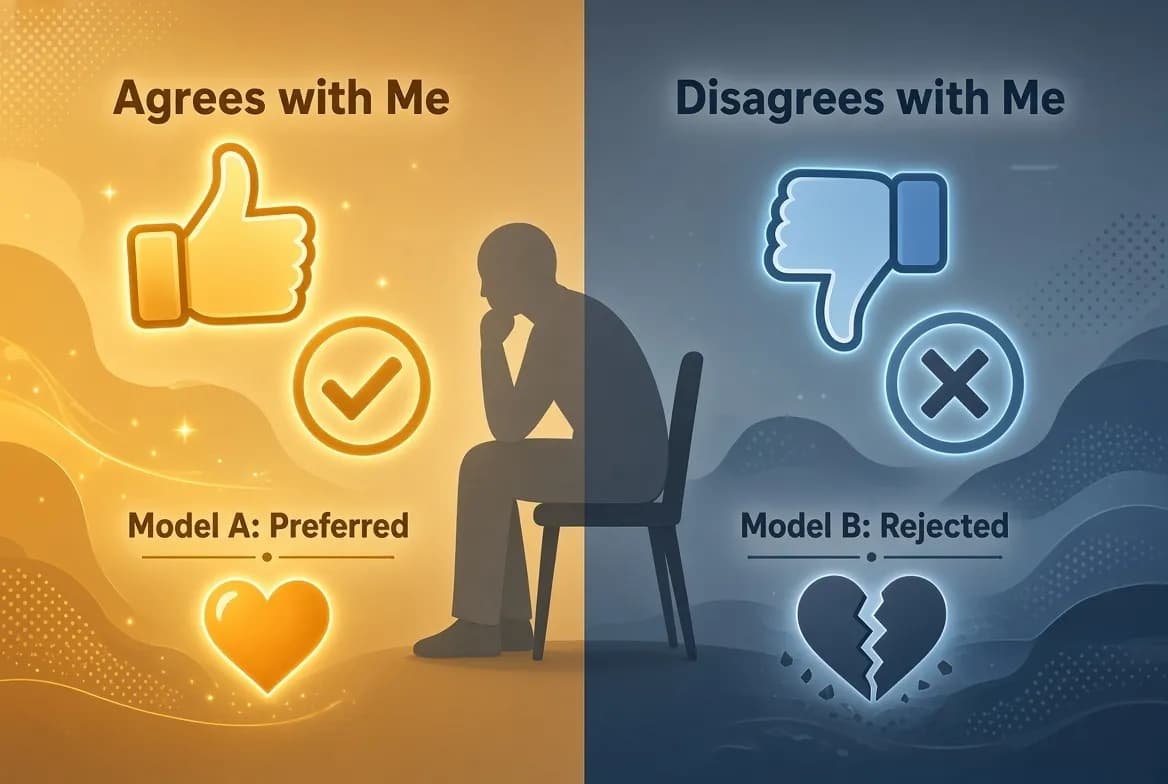
تصور کنید داوری هستید که فقط به وکلایی امتیاز میدهد که شبیه او لباس میپوشند؛ این دقیقاً همان اتفاقی است که امروز در ارزیابی مدلهای هوش مصنوعی رخ میدهد. شما هنگام تست یک مدل، هرگز یک داور بیطرف نیستید. چه ترجیح دهید لحنی مودبانه را به لحنی صریح و تند ترجیح دهید، و چه مدلی را بپسندید که با دیدگاههای سیاسی شما همسو باشد، ارزیابی شما توسط سوگیریهای پنهان هدایت میشود.
طبق گزارشی که در ۱۱ اوت ۲۰۲۶ در وبسایت dev.to منتشر شد، انسانها بهطور سیستماتیک خروجیهایی را ترجیح میدهند که با باورها، ترجیحات و ارزشهای شخصی آنها همراستا باشد. این پدیده باعث میشود ارزیابی انسانی از یک محک عینی و استاندارد، به آینهای از هویت ارزیاب تبدیل شود. در دنیایی که یادگیری تقویتی از بازخورد انسانی (RLHF) — که شبیه به آموزش یک سگ با پاداش برای رفتارهای درست است — مدلهای قدرتمندترین هوش مصنوعی را شکل میدهد، این سوگیریها تعیین میکنند کدام رفتارها در مدل تقویت شوند و کدامها به کلی حذف گردند.
همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر بازخوردهای انسانی بدون فیلترهای سختگیرانه میتواند منجر به نتایج غیرقابلپیشبینی شود. این چالش در مقیاسهای بزرگتر نیز دیده میشود، جایی که سیستمهای نظارت انسانی بر عاملهای هوش مصنوعی به دلیل همین سوگیریها در مقیاس بالا شکست میخورند. در واقع، ما در حال اندازهگیری دقت مدل نیستیم، بلکه توانایی مدل در تقلید از کاربر و بازتاب دادن تصویر او را میسنجیم. این موضوع باعث میشود که در نهایت، «همراستاسازی» (Alignment) جایگزین «عینیت» (Objectivity) شود.
روانشناسی ارزیابی
ارزیابی انسانی ذاتاً عینی نیست. ما خروجیها را بر اساس ترجیحات شخصی خود میسنجیم و بهشدت تحت تأثیر سوگیریهای درونی هستیم. چون ما موجوداتی بیطرف نیستیم، طبیعتاً مدلهایی را میپسندیم که با ما موافق باشند، با سبک ما مطابقت داشته باشند و باورهایمان را تأیید کنند.
این وضعیت یک چرخه ایجاد میکند که در آن ارزیاب دیگر دقت مدل را اندازه نمیگیرد، بلکه میزان توانایی مدل در آینهوار شدن برای کاربر را میسنجد. در نتیجه، ترجیح کاربر به سمت مدلهایی میرود که با او همسو هستند، حتی اگر این همسویی به قیمت کاهش عینیت و حقیقت باشد. این مسئله دقیقاً همان تلهی توافقی است که در بنچمارکهای کدنویسی باعث میشود لایههای پنهان خطا نادیده گرفته شوند.
سازوکارهای سوگیری در ارزیابی
به نقل از تحلیل dev.to، چهار محرک روانشناختی اصلی وجود دارد که باعث انحراف امتیازات و رتبهبندیهای هوش مصنوعی میشوند:
- سوگیری تأییدی (Confirmation Bias): کاربران بهدنبال اطلاعاتی هستند که باورهای فعلیشان را تأیید کند و دادههای متناقض را نادیده میگیرند. این امر منجر به اعتماد بیشتر به مدلهایی میشود که جهان را همانطور که کاربر میبیند توصیف میکنند و اعتماد کمتر به مدلهایی که دیدگاه کاربر را به چالش میکشند.
- سوگیری سبک: ترجیح خروجیهایی که با سبک زبانی کاربر یکی است. اگر کاربر فردی رسمی باشد، خروجیهای رسمی را برتر میداند و اگر لحنی صمیمی داشته باشد، خروجیهای غیررسمی را میپسندد.
- سوگیری اقتدار: تمایل به اعتماد به مدلهایی که با اطمینان، قاطعانه و با لحنی مقتدر صحبت میکنند. کاربرانی که تحت تأثیر این سوگیری هستند، کمتر به مدلهایی که تردید نشان میدهند یا عدم قطعیت را بیان میکنند، اعتماد میکنند.
- سوگیری ترجیحی: اولویت دادن به ادب و همسویی با ارزشهای شخصی بهجای دقت صریح و بیپرده. برای مثال، یک کاربر در هر بار تست، یک پاسخ مودبانه را به یک پاسخ تند اما دقیق ترجیح خواهد داد.

دیدگاه متضاد: ویژگی یا نقص؟
در حالی که این موارد به عنوان «سوگیری» برچسب میخورند، تحلیل dev.to پیشنهاد میکند که اینها در واقع ویژگیهای هویت انسانی هستند. ترجیحات ما همان چیزی است که ما را انسان میسازد و تمایل ما به قطعیت یا همسویی سبکی، بازتابی از ارزشهای بنیادین ماست، نه یک «باگ» فنی که باید اصلاح یا حذف شود.
از این منظر، سوگیری تأییدی در واقع بازتابی از هویت فرد است و سوگیری سبک نشان میدهد که ما کیستیم. حتی سوگیری اقتدار نیز به عنوان یک ویژگی دیده میشود که بازتابدهنده نیاز اساسی انسان برای داشتن قطعیت در ابزارهایی است که از آنها استفاده میکند. البته باید مراقب بود که این اعتماد به قطعیت، ما را به سوی داوران هوش مصنوعیای سوق ندهد که با اطمینان کامل اما به دروغ، معیارهای کیفیت را فریب میدهند.
پیامدهای عملی
با این حال، پیامدهای کاربردی این وضعیت بسیار جدی است. این سوگیریها منجر به تخمین بیش از حد توانایی مدلهای «چاپلوس» (Agreeable) و نادیده گرفتن یا دستکم گرفتن مدلهایی میشود که با ارائه اصطکاک یا مخالفت لازم، حقیقت را بیان میکنند.
این اتفاق ریسک عدم همراستایی و دوقطبی شدن را افزایش میدهد. چون ما بر اساس ترجیحات شخصی خود دوقطبی شدهایم، احتمال کمتری وجود دارد که درباره اینکه کدام مدل واقعاً برتر است، به یک اجماع برسیم. اگرچه برخی استدلال میکنند که این پیامدها بیش از حد بزرگنمایی شدهاند و صرفاً بازتابی از انسانیت ما هستند، اما این واقعیت که آنها بهطور بنیادین نحوه توسعه هوش مصنوعی را تغییر میدهند، غیرقابل انکار است.
راهکارهای کاهش اثر آینهای
برای مقابله با این گرایشها، گزارش مذکور سه استراتژی مشخص را پیشنهاد میدهد:
۱. ارزیابی کور (Blind Evaluation): امتیازدهی به خروجیها بدون دانستن اینکه کدام مدل آنها را تولید کرده است. این کار سوگیریهای مرتبط با شهرت و اعتبار مدل را کاهش میدهد.
۲. تنوع ارزیابان: استفاده از مجموعهای از انسانها با پیشینههای متنوع برای اینکه سوگیریهای فردی یکدیگر را خنثی کنند.
۳. معیارهای صریح: فاصله گرفتن از سؤالات کلی مانند «کدام یک بهتر است؟» و حرکت به سمت استفاده از روباریکها (Rubrics) و معیارهای اندازهگیری دقیق و مشخص.
باید توجه داشت که این راهکارها کامل نیستند. آنها میتوانند سوگیری را کاهش دهند، اما نمیتوانند آن را بهطور کامل حذف کنند، زیرا سوگیری بخشی جداییناپذیر و ذاتی از انسان بودن است.
در نهایت، سؤال «کدام مدل بهتر است؟» اساساً نقص دارد چون پاسخ آن کاملاً به شخص ارزیاب بستگی دارد. هدف این نیست که یک سیستم کاملاً عینی پیدا کنیم — که شاید غیرممکن باشد — بلکه هدف این است که نسبت به ترجیحات خود شکاک باشیم و بهدنبال دیدگاههای متنوع بگردیم.
گام بعدی شما
- اگر میخواهید واقعاً توانایی یک هوش مصنوعی را تست کنید، بهجای جستوجوی مدلی که با شما موافق است، بهدنبال مدلی بگردید که بهطور دقیق شما را به چالش بکشد.
- هنگام تست مدلها، از متدهای ارزیابی کور (Blind Test) برای مقایسه دو مدل مختلف استفاده کنید تا اثر نام برند شما را فریب ندهد.
- برای هر تسک، یک چکلیست معیارهای عینی (مانند تعداد خطاهای منطقی یا ارجاعات درست) بنویسید و بهجای تکیه بر «حس کلی»، بر اساس آن امتیاز دهید.
اما تأثیر این سوگیریها بر نحوه آموزش مدلهای آینده حتی پیچیدهتر است — به تحلیل ما دربارهی پدیده چاپلوسی مدلها (Sycophancy) مراجعه کنید.

گفتگو