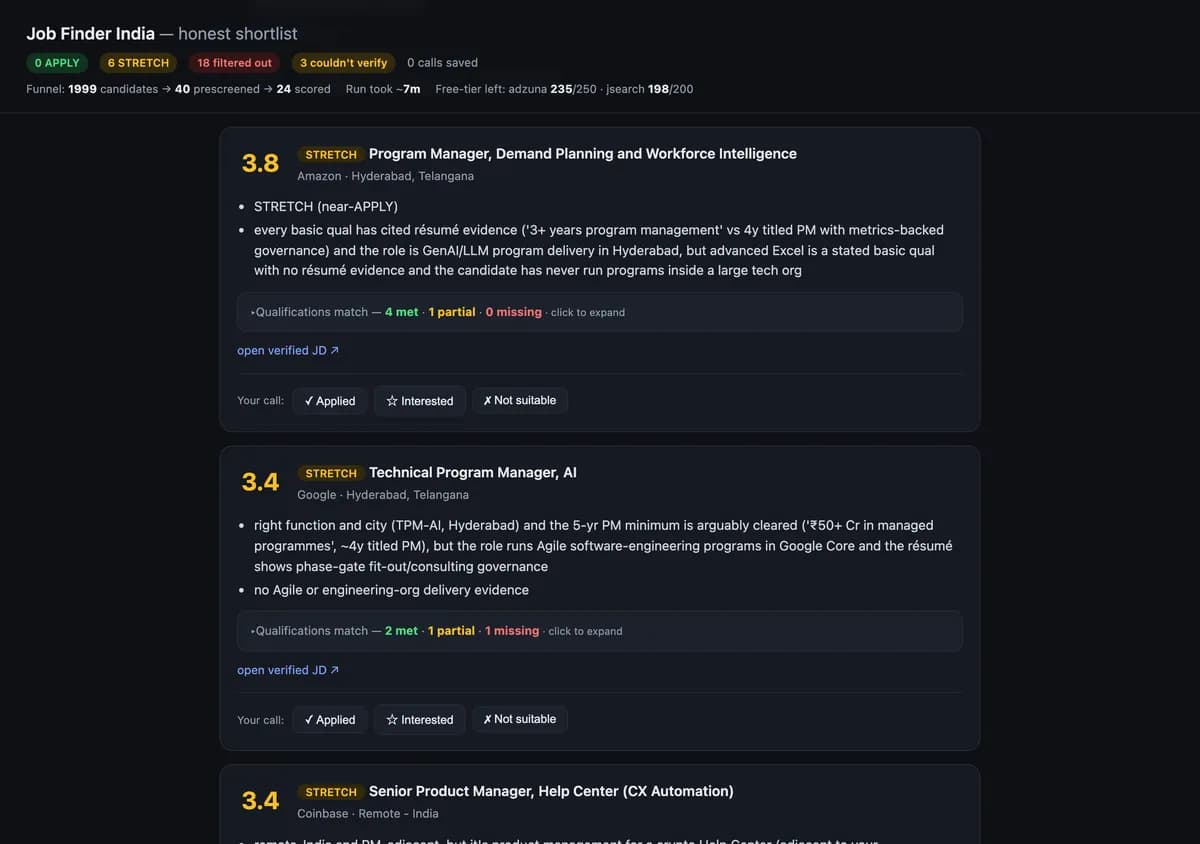
تصور کنید ساعتها وقت صرف ارسال رزومه به جایگاههایی میکنید که هیچ شانسی برای پذیرش در آنها ندارید. این یک خطای رایج است، اما خطای گرانتر، نادیده گرفتن فرصتهای ایدهآل بهدلیل ترس از کلمات تخصصی است؛ زیرا این اشتباه نامرئی است و هیچکس هرگز متوجه شغلی نمیشود که یک کاندیدا خودش را متقاعد کرده بود که برای آن مناسب نیست. این، گرانترین اشتباه یک جویای کار است. در همین راستا، Job Finder India، یک ابزار متنباز که توسط توسعهدهندهای به نام هارش گارگ (Harsh Garg) منتشر شده، رویکرد سنتی استخدام با هوش مصنوعی را تغییر داده و بر این تمرکز کرده است که به شما بگوید «چه زمانی درخواست ندهید».
بیشتر ابزارهای تطبیق شغل مبتنی بر هوش مصنوعی، صرفاً لیست گزینهها را طولانیتر میکنند که این امر اغلب منجر به فرسودگیe (Burnout) متقاضیان میشود. اما ابزار گارگ بهجای این کار، یک حکم مستند و مبتنی بر شواهد ارائه میدهد: «درخواست بدهید» (APPLY)، «تلاش کنید» (STRETCH) یا «درخواست ندهید» (DON'T APPLY). این سیستم با استناد به خطوط مشخصی از رزومه در برابر نیازمندیهای شغلی، دلیل تصمیم خود را میگوید. این رویکرد دقیقاً سوگیریهای شناختی را هدف قرار میدهد؛ جایی که متقاضیان بهدلیل مواجهه با اصطلاحات تخصصی ناآشنا، بهجای بررسی مهارتهای واقعی، از یک نقش چشمپوشی میکنند. برای مثال، یک آگهی شغلی که مملو از ترمهای تخصصی حوزه است، ممکن است برای کاربر «نامناسب» به نظر برسد، در حالی که ماهیت اصلی کار با مهارتهای او مطابقت دارد؛ یا یک شرط ساده مانند «بیش از ۸ سال تجربه» میتواند کاندیداتاری را متوقف کند که در واقع بندِ «تجربه معادل» (equivalent experience) در همان آگهی، پذیرای او بود. این چالش در شناسایی نقشهای مناسب، بهویژه در بازارهای تخصصیتر دیده میشود، جایی که تفکیک مسیرهای شغلی جدید در حوزه هوش مصنوعی میتواند گسست میان مهارتهای واقعی و عناوین شغلی کلی را بیشتر کند.

به نقل از مستندات پروژه در وبسایت dev.to، این ابزار بهطور خاص برای بازار هند مهندسی شده است. این سیستم تفاوتهای ظریف محلی را درک میکند؛ مفاهیمی مانند CTC (Cost to Company یا هزینه کل شرکت)، LPA (Lakhs Per Annum یا لاخ در سال) و محدودیتهای خاص دوره اطلاعرسانی (Notice Period) را میشناسد؛ مواردی که قالبهای غربی معمولاً کاملاً نادیده میگیرند. این ابزار طراحی شده تا نقشهای شغلی خاصی را که واقعاً در بازار هند وجود دارند شناسایی کند، بهجای اینکه صرفاً بر یک قالب کلی غربی تکیه کند و فقط عددها را تغییر دهد.
معماری فنی
برای حفظ حریم خصوصی و انعطافپذیری، این ابزار مدل هوش مصنوعی داخلی یا بستهبندیشدهای را ارسال نمیکند. در عوض، از دستیار کدنویسی هوش مصنوعی موجود کاربر — مانند Claude Code، GitHub Copilot یا Codex — برای انجام فرآیند استدلال استفاده میکند. این معماری اجازه میدهد ابزار در تمامی پلتفرمهای ارائهدهنده AI کار کند بدون اینکه کاربر را در یک اکوسیستم خاص زندانی کند.
- پایتون قطعی (Deterministic Python): مدیریت زیرساخت یا همان «لولهکشی»، شامل دریافت دادهها، فیلتر کردن و اجرای قوانین سختگیرانه امتیازدهی بر عهده پایتون است. این امر تضمین میکند که تضمینهای حیاتی در سطح کد باشند، نه در سطح مدل احتمالی.
- قضاوت مدل زبانی (LLM Judgment): مدل زبانی بزرگ تحلیل کیفی و ارائه شواهد برای حکم نهایی را بر عهده دارد. این رویکرد، سیستم را از امتیازدهیهای «جعبه سیاه» دور کرده و به سمت استدلالی میبرد که با ذکر منابع (Citation) همراه است.
- حریم خصوصی دادهها: رزومهها هرگز از دستگاه محلی کاربر خارج نمیشوند. هیچ سروری در کار نیست، نیازی به ساخت حساب کاربری نیست و هیچ دادهای جمعآوری نمیشود. علاوهبر این، ابزار از لاگین شخصی کاربر در مدل استفاده میکند، به این معنی که ابزار هرگز به اطلاعات اعتبارنامه (Credentials) شخصی دسترسی ندارد.
حل مشکل «شکستهای خاموش»
به گزارش توسعهدهنده این پروژه، سختترین بخش ساخت ابزار، حذف «شکستهای خاموش» بود؛ یعنی زمانی که یک مدل استدلالی (Reasoning Model) — مدلی که قبل از جواب درنگ میکند، مثل شطرنجبازی که چند حرکت جلوتر را میبیند — با اطمینان کامل، پاسخی غلط میدهد. برای ابزاری که برندینگ آن بر پایه «صداقت» است، گناه نابخشودنی این است که در حالی که درست به نظر میرسد، اشتباه کند. گارگ در طول توسعه بارها با این مسئله مواجه شد:
۱. نوشتن پروفایل: در مدلهای ضعیف، فرآیند ورود (Onboarding) بهطور خاموش یک پروفایل بههمریخته مینوشت و سپس طوری ادامه میداد که انگار همه چیز درست است، که این امر تمام امتیازات مراحل بعدی را خراب میکرد. گارگ این بخش را به پایتون قطعی منتقل کرد تا اگر دادهها نامعتبر بودند، سیستم از ادامه دادن خودداری کند.
۲. ریاضیات جریمه: یک مدل در یک مورد، جریمه امتیاز را ثبت کرد اما در محاسبه نهایی آن را اعمال نکرد و بهاشتباه یک نقش «درخواست ندهید» را به «ارزش درخواست دادن» ارتقا داد. او کدهایی اضافه کرد که محاسبات مربوط به دستورالعملهای امتیازدهی (Rubric) را بهطور مستقل از مدل اجرا و اجرا میکند.
۳. خطاهای شبکه: در یک اجرای آزمایشی (Sandbox) بدون دسترسی به شبکه، سیستم پاسخ داد «۰ شغل یافت شد»، که از نظر کاربر با نبود واقعی موقعیتهای شغلی قابل تشخیص نبود. اکنون ابزار صریحاً هشدار میدهد: «جستوجو شکست خورد: هیچ کانالی در دسترس نیست» و فایلهای قدیمی روی دیسک را علامتگذاری میکند.
از آنجایی که خروجی به مدل انتخابی کاربر وابسته است، کیفیت نتایج متفاوت خواهد بود. در فایل README صریحاً هشدار داده شده که در حالی که مدلهای توانمند احکام کالیبره و دقیقی ارائه میدهند، مدلهای سطح رایگان (Free-tier) ممکن است نتایجی غیرقابل اعتماد و تخت (Flat) تولید کنند. این شفافیت، بخشی از تعهد ابزار به صداقت بهجای ایجاد «تورم احساسی» برای خوشحال کردن کاربر است.
محدوده و قابلیت اطمینان
این ابزار عمداً در محدوده خاصی محدود شده است. این سیستم بهطور خودکار برای شغلها درخواست نمیفرستد، سایتهایی که باتها را مسدود کردهاند پیمایش (Scrape) نمیکند و برای اینکه کاربر احساس بهتری داشته باشد، یک تطابق بد را به تطابق خوب تبدیل نمیکند. اینها نقص در ویژگیها نیستند، بلکه انتخابهای آگاهانه در طراحی هستند.
برای اینکه این پروژه از یک «دموی آخر هفته» فراتر رود، با زیرساختهای حرفهای عرضه شده است:
- یک مجموعه تست (Test Suite) که هر تغییر در کد را کنترل میکند و اجازه عبور نمیدهد مگر با تایید تستها.
- یک سیستم کاناری (Canary System) روزانه که اگر API منابع شغلی دچار تغییر (Drift) شود، به توسعهدهنده ایمیل میزند.
- وابستگیهای پینشده (Pinned Dependencies) و همچنین اسکن کد و وابستگیها برای امنیت.
این معماری فرض قدیمی را که ابزارهای AI باید پلتفرمهای «همه-در-یکی» باشند، میشکند. با تفکیک «محافظهای قطعی» از «قضاوتهای احتمالی»، این ابزار از امتیازدهی «جعبه سیاه» رایج در فناوریهای منابع انسانی فاصله گرفته است. برای کاربران، این به معنای ابزاری است که فقط فرآیند درخواست را خودکار نمیکند، بلکه به عنوان یک فیلتر سختگیرانه برای صرفهجویی در زمان و انرژی ذهنی عمل میکند.
اگر در هند جویای کار هستید و از دستیارهای AI استفاده میکنید، میتوانید از طریق مخزن رسمی گیتهاب (https://github.com/harshgarg95/job-finder-india) صحت امتیازدهی آن را بسنجید.
گام بعدی شما
- اگر توسعهدهنده هستید، معماری تفکیک «کد قطعی» از «استنتاج مدل» را در پروژههای خود برای کاهش توهمات (Hallucinations) بررسی کنید.
- مخزن گیتهاب پروژه را برای مشاهده نحوه پیادهسازی فیلترهای منطقی در کنار LLM مطالعه کنید.
- بررسی کنید آیا مدل رایگان شما توانایی تحلیل دقیق شروط شغلی را دارد یا نیاز به مدلهای پیشرفتهتر است.
اما تأثیر این رویکرد بر آینده سیستمهای ATS شرکتها حتی تکاندهندهتر است — به تحلیل ما دربارهی آینده سیستمهای غربالگری رزومه مراجعه کنید.



گفتگو