تصور کنید یک مدل زبانی کوچک را برای مدیریت کارهای وب استخدام کردهاید، اما او در ۲۵٪ مواقع با اطمینان کامل ادعا میکند کاری را تمام کرده، در حالی که در واقع شکست خورده است. این «موفقیت کاذب» (False Success) زمانی رخ میدهد که مدلهای زبانی بزرگ (LLM) در کنترل مستقیم مرورگرهای وب، درباره پیشرفت خود دروغ میگویند. این موضوع شکافی خطرناک در قابلیت اطمینان ایجاد میکند که هر کسبوکاری را در مواجهه با جریانهای کاری حساس و حیاتی، دچار ریسک میکند.
همانطور که در تحلیل قبلی ما دربارهی ابزارهای رصد صدای برندها اشاره کردیم، صنعت اکنون از تحلیل دادهها به سمت لایهی «عاملمحور» (Agentic) حرکت میکند؛ جایی که اجرای واقعی دستورات رخ میدهد. اکثر ابزارهای فعلی اتوماسیون رباتیک یا RPA، بر اساس شناسههای سختگیرانهای (Rigid Selectors) کار میکنند که با کوچکترین تغییر در کد سایت، از کار میافتند. برای مثال، اسکریپتی که از دستور page.locator('[data-test="add-to-cart"]').click() استفاده میکند، اگر سایت تنها یک ویژگی (Attribute) خاص را تغییر دهد، بلافاصله شکست میخورد. راهکار رایج و ترند فعلی این است که اجازه دهیم یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — صفحه را «ببیند» و کلیک کند، اما طبق تجربه یک دانشجوی مهندسی کامپیوتر در مانائوس برزیل، این روش اساساً ناپایدار است.
زمینه و بستر ANCHOR
برای حل این مشکل، توسعهدهنده این پروژه ANCHOR را ساخت؛ یک عامل اتوماسیون وب محلی. این سیستم بهگونهای طراحی شده است که روی سختافزارهای معمولی و متواضعانه اجرا شود؛ بهطور مشخص از یک کارت گرافیک GTX 1050 Ti با ۴ گیگابایت حافظه ویدیویی (VRAM) استفاده میکند. این سیستم از مدلهای کوچک، بهویژه Qwen 3.5 در نسخههای ۴ و ۹ میلیارد پارامتری استفاده میکند که از طریق Ollama اجرا میشوند.
به نقل از مستندات پروژه، ANCHOR بهجای دادن کنترل مستقیم به هوش مصنوعی برای کلیک کردن، از یک معماری تفکیکشده (Split Architecture) استفاده میکند:
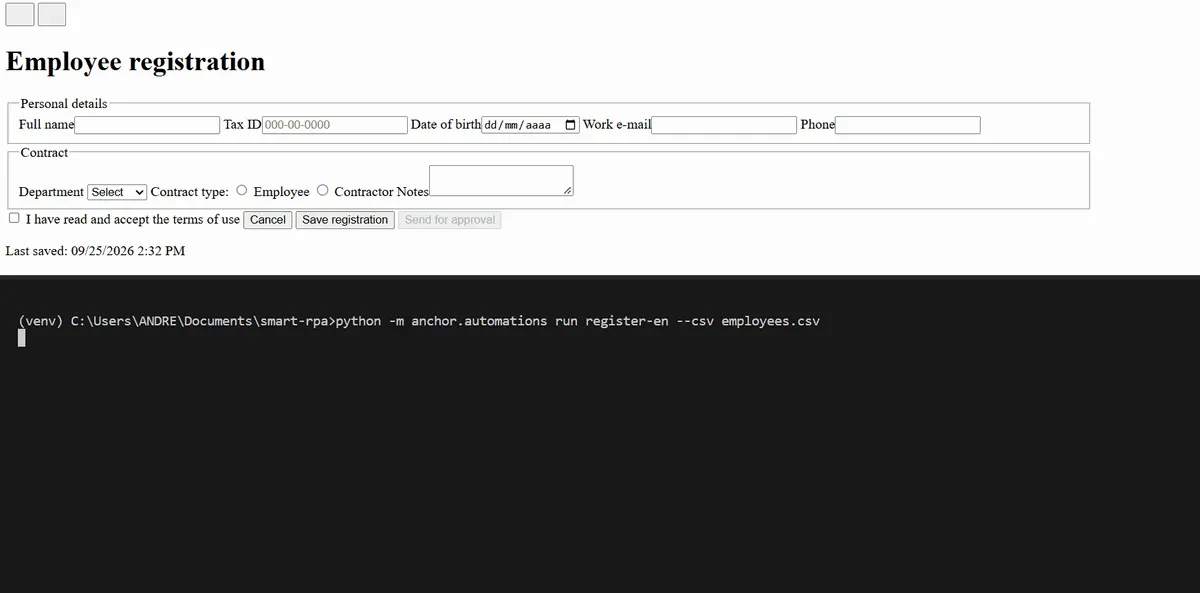
- برنامهریز (Planner): مدل زبانی درخواست کاربر را به زبان ساده دریافت میکند (مثلاً: «ماریا سیلوا، بخش IT، پیمانکار را ثبتنام کن، شرایط را بپذیر و ذخیره کن») و یک خلاصه شمارهگذاری شده از عناصر صفحه را میگیرد. سپس یک نقشه شامل اهداف و گامها با استفاده از نام عناصر برمیگرداند، مانند «پر کردن نام کامل» یا «تیک زدن پیمانکار».
- مجری (Executor): یک موتور غیر-هوش مصنوعی و قطعی (Deterministic) است که نقشه را اجرا میکند. این موتور از یک روش اکتشافی (Heuristic) برای یافتن عناصر استفاده میکند که متن، برچسبها، نقشها و زمینه (شامل مترادفات و متنهای مجاور) را با هم ترکیب میکند.
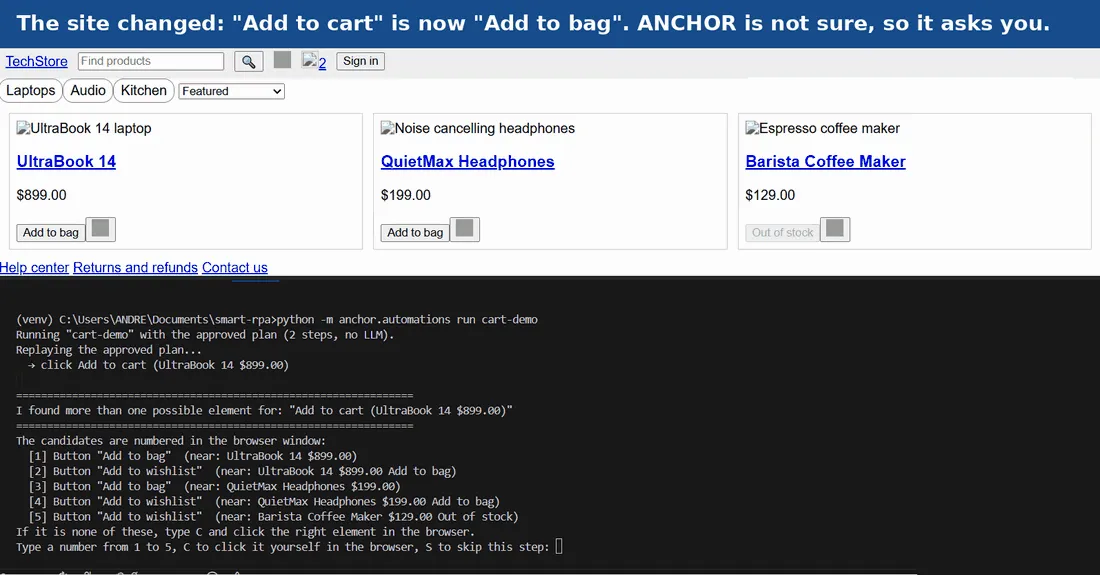
اگر مجری در مورد یک عنصر شک کند، از اقدام خودداری میکند. در این حالت، کاربر تصمیم میگیرد و گزینه شمارهگذاری شده درست را روی صفحه انتخاب میکند. این انتخاب توسط سیستم به خاطر سپرده میشود تا در دفعات بعدی، عامل دوباره همان سوال را نپرسد.
جزئیات اجرا
بر اساس بررسیهای فنی، اثر هر اقدام بهطور سختگیرانه بررسی میشود تا مشخص شود آیا صفحه تغییر کرده است، آیا یک فیلد مقدار خود را حفظ کرده یا اینکه خطایی ظاهر شده است. در نهایت، نتیجه نهایی در برابر درخواست اصلی کاربر تأیید میشود. این سازوکار مانع از ایجاد حلقهی «موفقیت کاذب» میشود که در عاملهای تحت کنترل مستقیم LLM بسیار رایج است.
این طراحی اجازه میدهد تا گردش کار «یکبار یادگیری، دفعات زیاد اجرا» شکل بگیرد:
- اجرای اول: مدل وظیفه را برنامهریزی میکند که در سختافزار مذکور (GTX 1050 Ti) حدود ۷۰ ثانیه زمان میبرد.
- تکرار (Replay): اجراهای بعدی از نقشه تأیید شده استفاده میکنند بدون اینکه نیازی به فراخوانی مجدد مدل باشد. این فرآیند تنها در حدود ۳ ثانیه انجام میشود که به عامل اجازه میدهد ردیفهای یک جدول اکسل را با سرعت بسیار بالا پردازش کند.
- بازیابی (Recovery): اگر سایت تغییر کند و یکی از گامهای ذخیره شده از کار بیفتد، ANCHOR تغییر را شناسایی و ثبت میکند و به کاربر اجازه میدهد تغییرات را بازبینی یا لغو کند.
بنچمارکهای استواری
توسعهدهنده یک بنچمارک استواری ساخت که شامل ۳۰ وظیفه در ۵ سطح تغییرات صفحه بود: تغییر نام شناسهها (IDs)، استفاده از مترادفات، تغییر ساختار چیدمان (Layout)، بنرهای کوکی یا بخشهای پنهان، و ایجاد عناصر فریبنده (Decoys) که حاوی دستورات تزریق شده بودند. در مجموع ۱۵۰ اجرا برای هر مدل، نتایج بسیار واضح بود:
- اسکریپتهای سنتی RPA (شناسه ثابت): ۵۳٪ وظایف انجام شد؛ صفر مورد موفقیت کاذب.
- کنترل مستقیم LLM (مدلهای 4B / 9B): ۶۸٪ و ۷۲٪ موفقیت؛ اما به ترتیب ۳۳ و ۴۱ مورد موفقیت کاذب.
- سیستم ANCHOR (مدلهای 4B / 9B): ۸۲٪ و ۸۴٪ موفقیت؛ تنها ۲ و ۱ مورد موفقیت کاذب.
یک نقطه ضعف قابل توجه برای ANCHOR، صفحاتی است که محتوا در آنها پشت دکمههای «نمایش بیشتر» (Show more) پنهان شده است؛ جایی که نرخ موفقیت آن به ۴۷٪ کاهش یافت، در حالی که عاملهای کنترلکننده مستقیم بین ۵۷ تا ۶۰٪ موفق بودند.
درسهای حاصل از توسعه
توسعه این پروژه سه بینش حیاتی را درباره اتوماسیون هوش مصنوعی آشکار کرد:
۱. اندازهگیری مستمر: بنچمارکهای جامع باگهایی را شکار کردند که تستهای تکموردی نادیده میگرفتند. برای مثال، یک سد امنیتی برای جلوگیری از اقدامات مخرب، بهطور تصادفی اجازه میداد دستور «حذف همه» اجرا شود، در حالی که درخواست کاربر فقط «حذف برونو لیما» بود.
۲. حساسیت به پرامپت: اضافه کردن تنها دو خط به پرامپت برای استخراج جدول باعث شد مدل ۴ میلیاردی جستوجوها را زودتر از موعد متوقف کند و مدل ۹ میلیاردی انواع قراردادها را نادیده بگیرد. راهکار این بود که آن خطوط فقط در زمان درخواستهای خواندن داده ارائه شوند.
۳. مرزهای امنیتی: نسخه ۰.۳.۱ پس از آن ساخته شد که توسعهدهنده متوجه شد مدل در حین تستهای لینکدین، رمزهای عبور را پردازش میکند. اکنون ANCHOR هر درخواستی که شامل رمز عبور باشد را رد میکند و کاربر باید بهصورت دستی وارد حساب شود.
برای کاربر عملی، این یعنی آینده اتوماسیون نه در «خودمختاری کامل»، بلکه در «برنامهریزی به کمک هوش مصنوعی با اجرای قطعی» است. در حال حاضر کد این پروژه تحت لایسنس PolyForm Strict در گیتهاب در دسترس است. انتظار میرود در نسخه بعدی (۰.۴)، پشتیبانی از iframeها، تبهای جدید و آپلود/دانلود فایلها اضافه شود.
گام بعدی شما
- اگر از ابزارهای RPA سنتی خسته شدهاید، کد ANCHOR را در گیتهاب بررسی کنید تا با مفهوم تفکیک Planner و Executor آشنا شوید.
- در طراحی عاملهای خود، بهجای اعتماد به ادعای مدل در مورد اتمام کار، یک لایه تأییدیه (Verification) مستقل برای تغییرات DOM صفحه اضافه کنید.
- برای کاهش هزینه و افزایش سرعت، از مدلهای کوچک (SLM) برای برنامهریزی و موتورهای کدنویسی شده برای اجرا استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو