
تصور کنید یک فایل zip ساده از اسناد متنی بتواند از یک خطلولهٔ حافظه چند میلیون دلاری بهتر عمل کند. کال پترسون استدلال میکند که عاملهای هوش مصنوعی هرگز نباید با یک پنجرهٔ زمینهٔ خالی — یا همان «لوح سفید هوش مصنوعی» (Tabula Rasa) که اغلب در بنچمارکهای مدلها برای حفظ عدالت استفاده میشود — شروع به کار کنند. در کاربردهای دنیای واقعی، عاملها باید با بیشترین مقدار اطلاعات مرتبطِ موجود آغاز کنند. آنها باید با خاطرات شروع کنند.
بسیاری از توسعهدهندگان در حال حاضر به سه الگوی حافظهٔ معیوب تکیه میکنند. برخی در حصار سیستمهای انحصاری آزمایشگاهها هستند که اولویت را به پروفایلسازی کاربر میدهند تا دانش جهان. این آزمایشگاهها اغلب میخواهند از «کسبوکار API» که رقابتی است، به «کسبوکار پلتفرمی» که سودآورتر است منتقل شوند. نتیجه این است که سیستمها تاریخچهٔ گفتگوها را استخراج میکنند تا چیزهایی دربارهٔ کاربر به خاطر بسپارند، نه اطلاعات مفید دربارهٔ جهان. این رویکرد در واقع تلاشی برای حل چالشهای بازیابی سریع تاریخچه است که پیشتر در بررسیهای مربوط به پایگاهدادههای برداری و سرعت بازیابی دادهها به آن پرداخته شده است. برخی دیگر از «سیستمهای غولآسا» استفاده میکنند که برای تصمیمگیری دربارهٔ اینکه چه چیزی ارزش به خاطر سپردن دارد، به مجموعهای سرگیجهآور از pgvector، یک پایگاهدادهٔ گراف Neo4j و مدلهای زبانی اختصاصی نیاز دارند. این پیچیدگی مدلها را گیج میکند و با پیشروی مرزهای مدلها، قابلیت مقیاسپذیری خود را از دست میدهد. در نهایت، سیستمهای «مدرنیست» از گرافهای دانش صلب و گزارههای منطقی استفاده میکنند که واقعیتها را از بستر اصلیشان جدا میکند و در نهایت لیستی بیمعنی از «حقایق تقطیرشده» به عامل تحویل میدهد.
پترسون با تکیه بر این ایده که حافظه باید «داده» باشد نه یک «فرآیند» — و با بازتاب دیدگاه بروکس که معتقد بود نمایش جداول باعث میشود نمودارهای جریان (Flowcharts) بدیهی شوند («جداولت را به من نشان بده و من معمولاً به نمودارهای تو نیاز نخواهم داشت؛ آنها بدیهی خواهند بود») — در اوت ۲۰۲۶ Memoryfields را معرفی کرد. این سیستم حافظه را نه یک خطلولهٔ چند مرحلهای، بلکه یک فرمت فایل قابل حمل میبیند. به طور مشخص، یک memoryfield یک آرشیو zip (مثلاً my-memories.memoryfield.zip) است که شامل صفحات Markdown با متادیتای YAML اختیاری و یک شاخص برداری SQLite اختیاری برای جستوجوی معنایی است.
معماری Memoryfields
این سیستم بر اساس چهار تصمیم کلیدی طراحی شده تا اصطکاک بین مدل و داده را به حداقل برساند:
- متن به جای تکهها: به جای تکهبندی (Chunking) مکانیکی، بازرتبهبندی (Re-ranking) یا خلاصهسازی دو مرحلهای، عاملها خاطرات خود را مستقیماً به صورت متن روان در Markdown مینویسند. این کار از توانایی ذاتی مدل در تولید متون خوانا بهره میبرد. یک صفحه معمولی شامل متادیتای YAML با عنوان، تاریخ ایجاد، تاریخ بهروزرسانی، یک UUID و یک خلاصه است (مثلاً: «خواص حرارتی ظروف پخت کربن فیبر»).
- محدودیت ۸ کیلوبایت: هر صفحه حافظه یک سقف نرم تقریباً ۸۰۰۰ کاراکتر (حدود ۲۰۰۰ توکن) دارد. این موضوع تضمین میکند که محتوا در یک بردار معنایی (Embedding) واحد جای بگیرد و در عین حال به اندازه کافی طولانی باشد تا یک مقاله مفصل به سبک مجلات (حدود ۱۳۰۰ کلمه) را در بر بگیرد. اگر جزئیات بیشتری نیاز باشد، عامل به سادگی صفحات بیشتری اضافه میکند.
- پرشهای معنایی: این سیستم «گشتوگذار در گراف» را با جستوجوی مستقیم معنایی جایگزین میکند. در حالی که سیستمهایی مانند ویکیهای کارپاتی برای پیمایش لینکها به فراخوانیهای متوالی ابزار نیاز دارند — که کند و غیرقابل اعتماد است — Memoryfields به عامل اجازه میدهد به صورت موازی مستقیماً به تمام صفحات مرتبط بپرد.
- مکانیسم پایین: با اجتناب از APIهای پیچیده و «هزارتوی رابطها»، عاملها میتوانند الگوهای دسترسی خودشان را ابداع کنند. پترسون اشاره میکند که مدلها در حال حاضر در Bash، Markdown و SQLite مهارت دارند و میتوانند کارهایی مانند جایگزینی کلی (Global find-and-replace) از طریق Perl یا کوئری زدن در فایلهای CSV داخلی با SQL را انجام دهند.
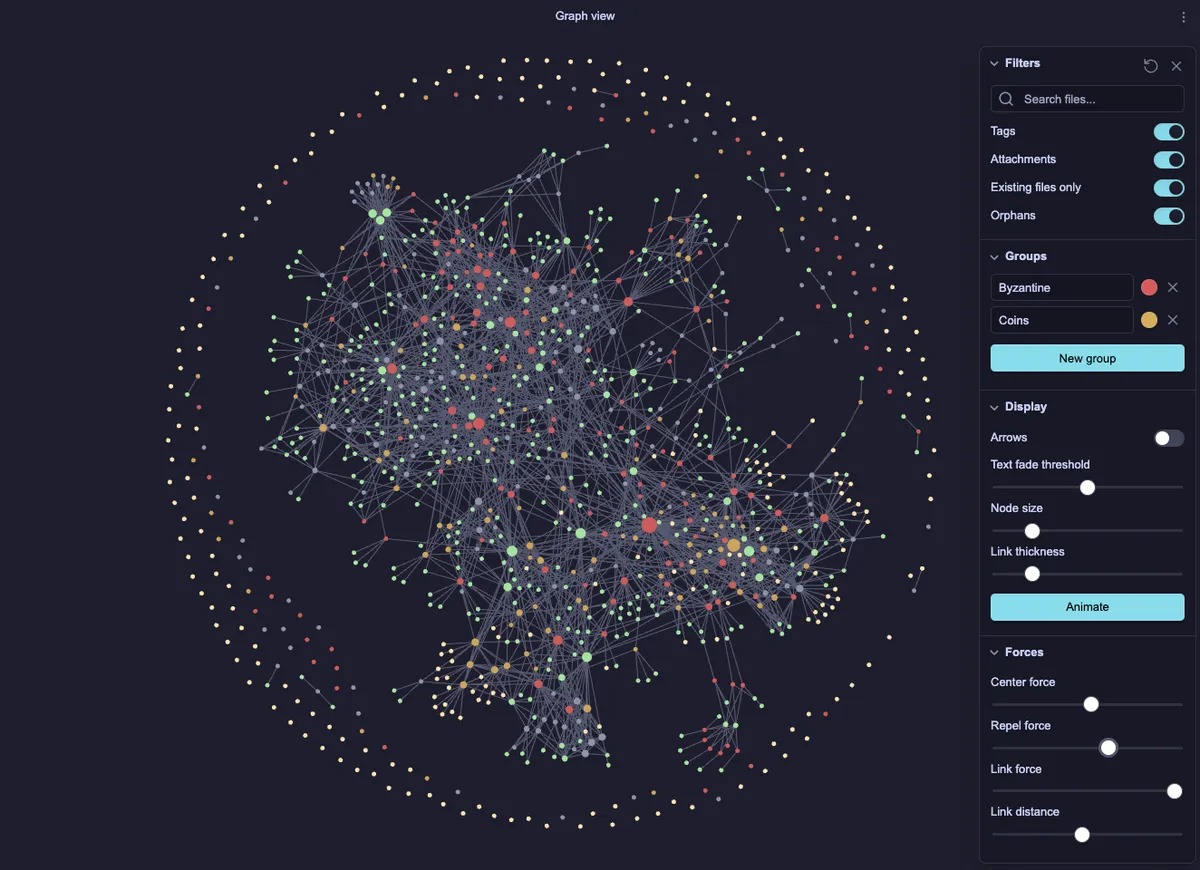
شکست گرافهای دانش
پترسون برجسته میکند که چرا رویکرد «گشتوگذار در گراف» که در کارهای قبلی مانند ویکیهای کارپاتی استفاده شده، ناکارآمد است. پیمایش کند است زیرا مدل باید برای خواندن صفحات متوالی، برای فراخوانیهای متوالی ابزار توقف کند. الگوریتم تقریبی برای یک عامل جهت پیمایش در یک گراف دانش به این صورت است:
۱. خواندن صفحه اول ویکی [فراخوانی ابزار] و یافتن لینکهای مرتبط.
۲. خواندن صفحه(های) لینکشده [فراخوانی ابزار] و یافتن لینکهای مرتبط بیشتر.
۳. تصمیمگیری درباره اینکه آیا اطلاعات مرتبط کافی یافت شده است یا خیر.
۴. اگر خیر، تکرار از مرحله ۲.
اگر اطلاعات مرتبط در عمق N مرحله باشد، N+1 فراخوانی ابزار لازم است و هر فراخوانی ۲ تا ۳ ثانیه زمان میبرد. این موضوع جریمهٔ شدیدی برای گرافهای دانش با تودرفتگی زیاد است، که دقیقاً با هدف اصلی استفاده از ساختار گراف در تضاد است.
علاوه بر این، گرافهای دانش غیرقابل اعتماد هستند زیرا عاملها برای قضاوت دربارهٔ ارتباط، به متن لینک یا عنوان صفحه تکیه میکنند. این وضعیت باعث میشود نوعی «هک متادیتای صفحه به سبک سئو دهه ۹۰» صورت گیرد تا عنوانها جذاب باشند، که این امر ثبت جزئیات محیطی و دانش ضمنی را تنبیه میکند. این موضوع اغلب منجر به این میشود که عامل اطلاعات مرتبط را از دست بدهد یا «نویزهای» بیربط (مانند صفحه اول ویکی) را بخواند، که کیفیت خروجی را کاهش داده و باعث میشود مدل روی جزئیات بیربط متمرکز به نظر برسد.
تحلیل عمیق تصمیمات طراحی
متن و صدای عامل
خطلولههای سنتی RAG پیچیده هستند زیرا تلاش میکنند اسناد قدیمی که توسط انسان نوشته شدهاند (مانند PDFهای حجیم) را برای AI خوانا کنند. Memoryfields این مشکل را دور میزند زیرا خاطرات توسط خودِ عامل ایجاد میشوند. از آنجایی که عامل کاملاً قادر به نوشتن متن روان است، نیازی نیست دادهها قبل از ذخیرهسازی «غنیسازی» یا «به صورت مکانیکی پردازش» شوند. عامل صرفاً در فرمت مورد علاقهاش، یعنی Markdown، مینویسد.
کارایی جستوجوی معنایی
با انتقال از پیمایش گراف به جستوجوی معنایی، تعداد فراخوانیهای ابزار به شدت کاهش مییابد. در یک memoryfield، حداکثر دو فراخوانی ابزار مورد نیاز است: یکی برای جستوجو و یکی برای خواندن موازی صفحات مرتبط. این کار توکنهای ورودی بیربط را به حداقل میرساند و تضمین میکند که مرتبطترین اطلاعات بر اساس محتوای واقعی و نه متاداتا، استخراج شوند.
مقیاسپذیری با مرزهای مدل
سیستمهای «مکانیسم بالا» اغلب عاملها را مجبور میکنند در هزارتوی رابطهای کاربری حرکت کنند. اگر API بیش از حد بزرگ باشد، از طریق openapi.json توکنهای زمینهٔ زیادی را مصرف میکند؛ و اگر بیش از حد کوچک باشد، محدودکننده است. Memoryfields به عنوان یک فرمت فایل با مکانیسم پایین، به عاملها اجازه میدهد از دادههای آموزشی خود برای تعیین بهترین الگوی دسترسی استفاده کنند. با بهبود مدلها، آنها بهطور خودکار در نحوه استفاده از دادهها خلاقتر میشوند، در حالی که سیستمهای «کیسه در کنار» (Bag-on-the-side) توسط نقاط انتهایی API ثابت محدود شدهاند.
پیادهسازی و ابزارها
برای اینکه فرمت مستقل از محیط انتقال باشد، نسخه آرشیوی استاندارد یک فایل zip است. این به کاربران اجازه میدهد خاطرات خود را روی Amazon S3، گیتهاب یا درایوهای محلی از طریق Syncthing میزبانی کنند. پشته فنی برای شروع شامل Ollama برای مدل برداری، uv برای نصب CLI و npx برای ادغام مهارتها است.
به طور مشخص، این سیستم از مدل nomic-embed-text-v1.5 استفاده میکند. اگرچه این مدل بیش از دو سال قدمت دارد، پترسون استفاده از آن را به دلیل اندازه کوچک (۲۷۰ مگابایت)، سرعت بالا روی سختافزارهای بدون GPU و ایجاد تعادلی پایدار بین قدرت و کارایی توجیه میکند. مشخصات سیستم باز باقی مانده است تا در صورت تمایل، از توابع برداری دیگر استفاده شود.
برای راهاندازی سیستم، فرآیند شامل سه گام اصلی است:
۱. دریافت مدل برداری از طریق ollama pull nomic-embed-text.
۲. نصب ابزار CLI با استفاده از uv tool install git+https://github.com/calpaterson/memoryfield-tool.
۳. نصب مهارت از طریق npx skills add calpaterson/memoryfield-skill -g -y.
بحث درباره RAG و امنیت
منتقدان ممکن است استدلال کنند که Memoryfields صرفاً شکلی از تولید بازیابیافزا (RAG) است. در حالی که از نظر فنی درست است، نویسنده این سیستم را با حذف تکهبندی، بازرتبهبندی و جستوجوی ترکیبی از RAG سنتی متمایز میکند. مهمتر از آن، Memoryfields برای نوشتن به اندازه خواندن طراحی شدهاند؛ خودِ عامل است که پایگاه دانش را سازماندهی و مدیریت میکند.
در مورد کیفیت داده، سیستم از مشکل «تورم حافظه» جلوگیری میکند. چون جستوجوی معنایی فقط مطالب مرتبط را بیرون میکشد، خاطرات بیربط بدون اینکه پنجرهٔ زمینهٔ مدل را آلوده کنند، در فضای ذخیرهسازی خفته میمانند. پترسون توصیه میکند که به طور گسترده در memoryfield درج کنید، با یک نکته کلیدی: ارجاعات را، ترجیحاً به صورت URL، اضافه کنید. این کار اجازه میدهد در دفعات بعدی خاطرات تقویت شوند و به عاملها کمک میکند تا مطالب قدیمی را بازبینی (Fact-check) کنند.
امنیت و قابلیت حمل
از آنجایی که هیچ راهی وجود ندارد که یک عامل تفاوت بین یک «پرامپت خوب» و یک «پرامپت مخرب» را در یک خاطره تشخیص دهد، این مشخصات بر بازبینی دستی تأکید دارد. به کاربران هشدار داده میشود که پنجرهٔ زمینه یا خاطرات خود را با طرفهای غیرقابل اعتماد به اشتراک نگذارند. این آسیبپذیری نشان میدهد که حافظه در واقع یک پروتکل اعتماد است و نه صرفاً یک ویژگی فنی، موضوعی که در تحلیلهای مربوط به مسمومسازی حافظه و راهکارهای مقابله با آن به تفصیل بررسی شده است. فرمت zip به کاربران اجازه میدهد تا قبل از وارد کردن، memoryfieldهای خاص را به صورت دستی بازبینی کرده و با استفاده از هشهای sha256sum آنها را پین کنند.
این تغییر به سمت حافظه «اول داده» به این معنی است که سیستم با بهبود مدلها بهطور خودکار مقیاس میشود. همانطور که LLMها در استدلال و کدنویسی بهتر میشوند، بهطور طبیعی خاطرات پیچیدهتری مینویسند و از سیستم فایل به صورت خلاقانهتری استفاده میکنند، بدون اینکه نیازی باشد توسعهدهندهای یک API ثابت را بهروزرسانی کند. این تضاد شدیدی با سیستمهای «کیسه در کنار» دارد که محدود به مجموعهای ثابت از نقاط انتهایی API هستند.
برای کسانی که به دنبال تست سیستم هستند، دموی soapstones.memoryfield.zip خاطرات منتخب درباره دسترسی دادههای عاملی، شامل تکنیکهای جستوجو در ردیت، استفاده از Jina Reader و بهرهبرداری مؤثر از API محیط MediaWiki را ارائه میدهد.
اول داده: منطق نهایی
اکنون که نمودار جریان بدیهی شده است، منطق صریح سیستم ساده است:
- خاطره را به صورت Markdown بنویس.
- آن را برداری کن و بردار را در SQLite ذخیره کن.
- برای یافتن دوبارهٔ خاطرات، از جستوجوی معنایی استفاده کن.
Memoryfields به این دلیل در میان سیستمهای حافظه غیرمعمول است که یک «ساختار داده» را تعریف میکند و نه یک «فرآیند». هیچ خطلوله استخراج، هیچ سرویس پردازش پسزمینه و هیچ جزء قابل تعویضی وجود ندارد. اگرچه یک شاخص برداری وجود دارد، اما با آن به عنوان یک کش قابل حذف برخورد میشود، نه به عنوان خودِ سیستم.
این رویکرد نشان میدهد که آیندهٔ پایداری عاملی در نرمافزارهای پیچیدهتر نیست، بلکه در فرمتهای دادهٔ باز و سادهای است که مدلها از پیش میشناسند. همانطور که پترسون میگوید: «حافظه یعنی داده! هرچه ماشینآلات ثابت کمتری بین عامل و آن داده قرار دهیم، عامل میتواند بهتر عمل کند.»



گفتگو