
تصور کنید در یک بیمارستان دانشگاهی در آلمان هستید که مدل DeepSeek-R1 را در یک محیط رادیولوژی کاملاً ایزوله مستقر کرده است تا یادداشتهای بالینی را بدون هیچگونه اتصال به اینترنت پردازش کند. این استقرار نشاندهنده ترندی است که در آن مراکز درمانی، «محل استقرار دادهها» را نه یک ترجیح، بلکه یک ضرورت قانونی برای اجتناب از مسئولیتهای حقوقی سنگین میبینند.
در حالی که اکثر صنایع، هوش مصنوعی ابری را یک تسهیلگر میبینند، در حوزه سلامت، قانون امنیت HIPAA (قانون جابهجایی و پاسخپذیری بیماران) و بهطور خاص بخش 45 CFR Part 164 باعث میشود هر بخش از خط لوله داده، یک نقطه شکست احتمالی در بازرسیهای قانونی باشد. همانطور که در تحلیل قبلی ما دربارهی بهینهسازی توکنها با ابزارهایی مثل EarlyEval اشاره کردیم، چالش فعلی برای بخش فناوری اطلاعات (IT) در کلینیکها، دیگر فقط بهرهوری نیست، بلکه حذف کامل دسترسی شخص ثالث به دادههاست.
فشار مقرراتی بر اطلاعات سلامت محافظتشده (PHI)
وقتی اطلاعات سلامت محافظتشده (PHI) شبکه محلی را ترک میکند، شکافی در «توافقنامه شریک تجاری» (BAA) ایجاد میشود که بسیاری از افسران تطبیق قانونی حاضر به پذیرش ریسک آن نیستند. این حساسیتها بهویژه پس از جریمههای سنگین میلیون دلاری برای استفاده نادرست از هوش مصنوعی در یادداشتهای پزشکی شدت یافته است. همانطور که در یک تحلیل دقیق از این قانون آمده است: «هر جزء از آن خط لوله مشمول تدابیر حفاظتی قانون امنیت است». سازمانهایی که ابزارهای هوش مصنوعی ابری را بدون بهروزرسانی «تحلیل ریسک امنیتی» خود به گردشکارهای موجود اضافه میکنند، در عمل از لحظهای که یک بازرس با دقت نگاه کند، از نظر قانونی غیرمنطبق هستند.
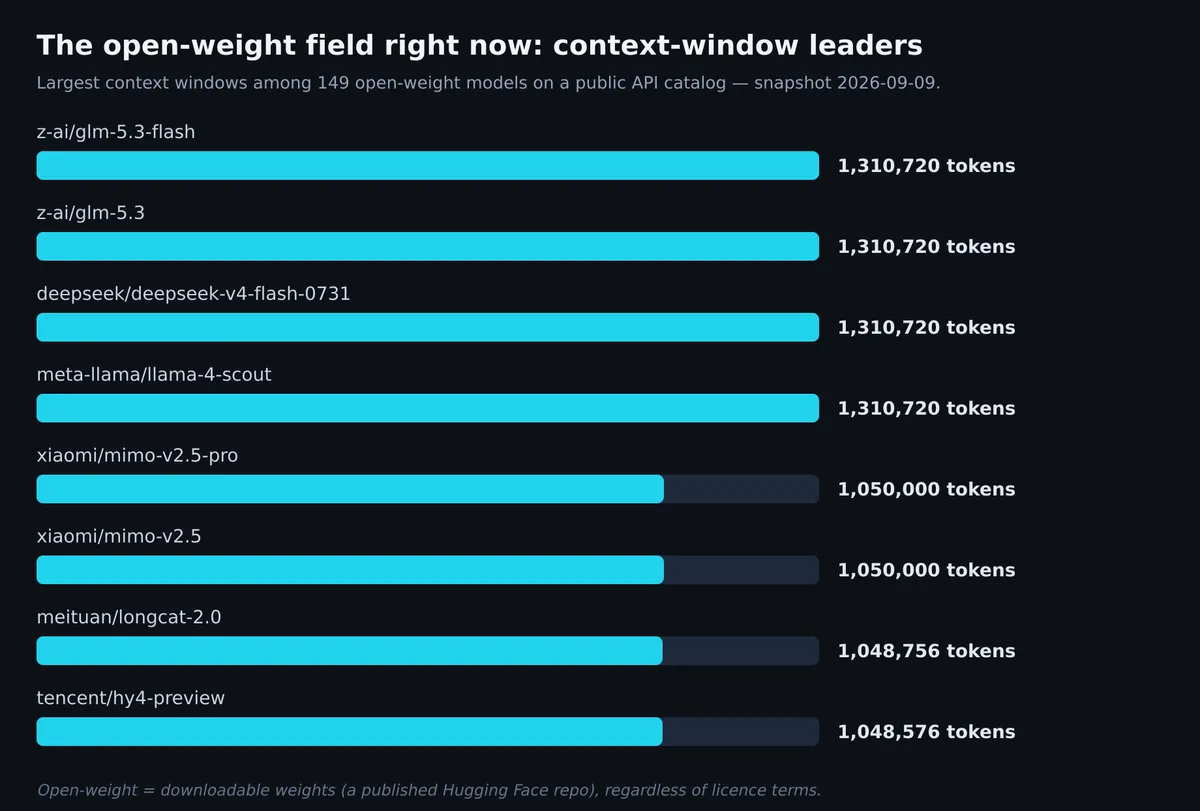
میزبانی شخصی (Self-hosting) مدلهای وزنباز (Open Weights) — یعنی مدلهایی که «دستور پخت» یا همان پارامترهایشان علناً منتشر شده و نیاز به اشتراک ابری ندارند — شخص ثالث را بهطور کامل از جریان دادههای PHI حذف میکند. طبق گزارشهای منتشر شده در stribog.com، این بدان معناست که محیط قانونی خود سازمان به تنها مرزی تبدیل میشود که اهمیت دارد. یک نوشتار مهندسی متمرکز بر HIPAA این موضوع را به صراحت بیان میکند: «دیگر هیچ شکاف BAA با شخص ثالث برای مدیریت وجود ندارد و هیچ مواجههای با حریم قضایی کشورهای خارجی صورت نمیگیرد».
اگرچه مسئولیت کنترل دسترسی و ثبت گزارشها (Audit Logging) همچنان بر عهده بیمارستان است، اما ریسک نشت داده در سرورهای خارجی یا حریمهای قضایی بیگانه حذف میشود. در صنعتی که بهشدت تحت نظارت است، حذف حتی یک پردازشگر از جریان PHI، کاهش قابلتوجهی در مواجهه با مسئولیتهای حقوقی ایجاد میکند. به همین دلیل است که هوش مصنوعی وزنباز بهطور خاموش به پیشفرض عملیاتی در IT بالینی تبدیل شده است؛ نه لزوماً به این دلیل که این مدلها هوشمندترند، بلکه چون APIهای بسته، یک شرکت ثالث را در میان دادههای محافظتشده قرار میدهند.
جزئیات طرح آزمایشی رادیولوژی DeepSeek-R1
جزئیات یک طرح آزمایشی با حضور ۲۲ پزشک مقیم و رادیولوژیست نشان میدهد که آنها از DeepSeek-R1 از طریق vLLM استفاده کردهاند. این سیستم با فیلترهای خروجی سختگیرانه (Egress Filtering) که توسط میزبان اعمال شده بود و تستهای ایزولاسیون خودکار مستقر شد تا اطمینان حاصل شود هیچ دادهای از محیط بسته خارج نمیشود. نکته مهم این است که این تستهای ایزولاسیون همراه با بسته استقرار ارائه میشوند تا سایر مؤسسات نیز بتوانند پیش از عملیاتی شدن، «مهر و موم» بودن محیط را تأیید کنند.
این سیستم پس از یک هفته آزمایش پیشبینانه با استفاده از ۱۰ قالب پرامپت پیشفرض در کارهای روزمره بالینی، اکنون به عنوان یک سرویس رسمی بیمارستانی فعال است. نتایج این طرح، شکاف عمیقی را در توانایی مدل نشان داد:
- کاربرد بالا: مدل در کارهای متنی و متکی به متن، مانند سادهسازی گزارشهای رادیولوژی موجود و استخراج توصیههای مبتنی بر دستورالعملها، عالی عمل کرد.
- ریسک بالا: تولید متنهای باز، بهویژه نوشتن نتیجهگیری از یافتههای خام، منجر به خطاهای بحرانی و توهم (Hallucination) — شبیه دوستی که با اطمینان خاطرهای را اشتباه تعریف میکند — شد که حتی برخی یافتههای مهم را نادیده گرفت.
این یافتهها ثابت میکند که مدلهای وزنباز برای بازنویسی و بازیابی قدرتمند هستند، اما هنوز نمیتوان برای اعمال قضاوت بالینی از صفر به آنها اعتماد کرد. یک توهم بررسینشده در گزارش رادیولوژی، یک «باگ نرمافزاری» نیست، بلکه یک حادثه ایمنی برای بیمار است. بنابراین طراحان تشویق میشوند که گردشکارهای خود را بر اساس این تفکیک بسازند، به جای اینکه به آنچه در دموها آسان به نظر میرسد تکیه کنند.
موارد استفاده اثباتشده در IT بالینی
در استقرارهای متعدد، سه دسته از وظایف AI موفق بودهاند چون انسان را در چرخه تصمیمگیری نگه میدارند و سطح مواجهه با PHI را محدود میکنند:
- پیشنویس مستندات بالینی: مدلها متن جلسات را به یادداشتهای ساختاریافته تبدیل میکنند، کدهای ICD-10/CPT را از متن یادداشت پیشنهاد میدهند و نامههای تأییدیه قبلی (Prior-authorization) را از دادههای ساختاریافته بیمار پیشنویس میکنند. پزشک باید این پیشنویسها را بررسی، ویرایش و امضا کند تا وارد سیستم صورتحساب یا پرونده بیمار شوند.
- غربالگری متون پزشکی: این شامل خلاصهسازی چکیدههای PubMed، ترکیب دستورالعملهای درمانی برای شرایط خاص یا تولید خلاصههای متنی برای تشخیصهای افتراقی است. چون این کار با متون علمی عمومی است و نه دادههای PHI بیمار، به وضعیت تطبیق قانونی بسیار سادهتری نیاز دارد و به عنوان یک نقطه ورود مناسب برای مطبها عمل میکند.
- اتوماسیون اداری: با استفاده از قالبهایی که شناسههای بیمار بعد از پردازش متن توسط مدل اضافه میشوند، کارکنان میتوانند نامههای ارجاع، پیامهای زمانبندی و پرسوجوهای تأیید صلاحیت را بدون اینکه هرگز PHI را در معرض مدل قرار دهند، پیشنویس کنند.
علاوه بر این، برخی سازمانها از جستوجوی دانش داخلی استفاده میکنند. این به کارکنان اجازه میدهد سؤالاتی به زبان ساده را درباره پروتکلهای داخلی و قوانین پرداختکنندگان بپرسند. با ارائه ارجاع (Citation) به سند منبع، پاسخها بهجای اعتماد کورکورانه، قابل بررسی هستند. توجه کنید که در هیچیک از این استقرارها، اجازه داده نشد که یک تصمیم بالینی بدون نظارت انسان گرفته شود؛ این یک انتخاب طراحی عمدی برای جلوگیری از حوادث ایمنی بیمار است.
پشته فنی تطبیق قانونی (Technical Compliance Stack)
اجرای یک خط لوله منطبق با قوانین، فراتر از دانلود وزنهای مدل است. یک معماری در سطح تولید باید شامل کنترلهای خاصی باشد تا با الزامات مقرراتی مطابقت داشته باشد:
- لایه تشخیص PHI: در مرز اپلیکیشن قرار میگیرد تا شناسههای لو رفته را شناسایی و متوقف کند.
- کنترلهای حسابرسی: گزارشهای رمزنگاریشده و «فقط-نویس» (Write-once) که با الزامات کنترل حسابرسی بخش §164.312(b) مطابقت دارد.
- ایزولاسیون شبکه: مرزهای سختگیرانه شبکه که تمام ترافیک استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — را بهطور کامل از اینترنت عمومی دور نگه میدارد.
- مدیریت هویت: سیستمهایی که هر پرسوجوی واحد را به یک کاربر احراز هویتشده متصل میکند.
هیچیک از این کنترلها عجیب نیستند — دسترسی مبتنی بر نقش (RBAC) و ثبت گزارشها از بهداشت استاندارد IT هستند — اما متصل کردن صریح آنها به یک لایه استنتاج AI جدید، بخشی است که اکثر سازمانها تا زمانی که یک بازرسی آنها را مجبور نکند، نادیده میگیرند.
برای محیطهای دادههای حاکمیتی یا دولتی، قابلیت «Air-gap» یا جدایش فیزیکی تنها گزینه ممکن است. در این محیطها، عدم اتصال به اینترنت یک سیاست اجباری است، نه یک انتخاب. مدلی که بتواند با صفر اتصال خروجی کار کند، تنها گزینه ممکن است وقتی محیط استقرار طبق سیاستها یک محیط بسته (Enclave) باشد.
توازن بین هزینه و تطبیق قانونی
مالکیت کامل زیرساخت همیشه درست نیست. برای کلینیکهای کوچک که کارکنان IT اختصاصی برای مدیریت تحلیل ریسک امنیتی و زیرساخت حسابرسی ندارند، یک API ابری با قرارداد BAA امضا شده ممکن است مسئولانهتر باشد.
اما در مقیاس بالا، اقتصاد تغییر میکند. هزینههای ثابت زیرساخت در نهایت بر صورتحسابهای متغیر توکن غلبه میکند، بهویژه زمانی که یک مرکز هزاران سند یا پیام را در ماه پردازش کند. وقتی حجم PHI، نیاز به سفارشیسازی یا الزامات حاکمیت داده بر هزینههای مدیریت شخصی غلبه کند، وزنهای باز به انتخابی منطقی تبدیل میشوند.
این تغییر، گذاری از «هوش مصنوعی بهعنوان سرویس» به «هوش مصنوعی بهعنوان زیرساخت» است. هدف دیگر فقط یافتن هوشمندترین مدل نیست، بلکه یافتن مدلی است که بتوان آن را کاملاً در یک اتاق قفل کرد.
گام بعدی شما
- اگر در حوزه سلامت فعالیت میکنید، ابتدا وظایفی را شناسایی کنید که نیاز به دادههای PHI ندارند (مثل خلاصهسازی مقالات) تا با ریسک کمتر وارد دنیای AI شوید.
- برای استقرار مدلهای داخلی، از ابزارهایی مثل vLLM استفاده کنید و لایههای فیلترینگ خروجی (Egress Filtering) را برای جلوگیری از نشت داده پیادهسازی کنید.
- هرگز اجازه ندهید خروجی مدل مستقیماً به پرونده بیمار منتقل شود؛ یک لایه بررسی انسانی (Human-in-the-loop) را اجباری کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو