اگر امروز سعی کنید یک عامل هوشمند را در محیط واقعی مستقر کنید، احتمالاً با شکست مواجه میشوید؛ چرا که دنیای واقعی شبیه به بنچمارکها نیست. یک عامل (Agent) که نتواند از یک خطای API یا یک گردشِ کار ناشناخته بیرون بیاید، در واقع چیزی جز یک «تکمیلکننده متن با ابزار» نیست و نمیتوان آن را یک عامل واقعی نامید.
برای حل این مشکل، صنعت باید تمرکز خود را از وزنهای مدل به دادههای بازیابیافزایی که رفتار عاملمحور (Agentic) را شکل میدهند، تغییر دهد. ساخت یک عامل واقعی، در واقع یک چالش عظیم در حوزه داده است. این مسیر نیازمند ردههای مهندسی نرمافزار، ثبت شکستهای استفاده از ابزار، استدلالهای چندمرحلهای و بازیابی اطلاعات است. همچنین دادههای مربوط به ایمنی، شبیهسازی کاربر و تعامل با دنیای فیزیکی حیاتی هستند. اگرچه وزنهای باز (Open Weights) — یعنی انتشار «دستور پخت» مدل بهجای ارائه صرفاً غذای آماده — اهمیت دارند، اما تنها بخشی از داستان هستند. تکرارپذیری نتایج به مجموعهدادهها، انتخابهای مربوط به پالایش، دستورالعملهای آموزشی و روشهای ارزیابی بستگی دارد. توسعهدهندگانی که عاملهایی برای اجرای گردشِ کار در سیستمهای مختلف میسازند، باید بتوانند دادههایی را که این رفتارها را شکل دادهاند بازبینی کنند تا سیستمها تفسیرپذیر شوند.
این چالش درست زمانی رخ میدهد که صنعت با مشکل «فرمول محرمانه» دستوپنجه نرم میکند. بیشتر دادههای باارزش — مانند گردشهای کاری خاص شرکتها — در سازمانهایی زندانی هستند که ریسک افشای آنها را نمیپذیرند. برای درک بهتر این موضوع، همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تعادل بین شفافیت و حفظ مالکیت همواره یک نقطه تنش است. در همین راستا، برخی پژوهشها نشان میدهند که دادههای اختصاصی در حوزههای تخصصی مانند ارزشگذاری دارویی، عملکرد بهتری نسبت به ساختارهای استدلالی عمومی دارند و اهمیت دسترسی به دادههای باکیفیت را دوچندان میکنند. براین کاتانزارو (Bryan Catanzaro)، نایبرئیس تحقیقات یادگیری عمیق کاربردی در انویدیا (NVIDIA)، اشاره میکند که «هر شرکتی بر پایه یک راز بنا شده است». این رازها مدلها را مفید میکنند، اما شرکتها نمیتوانند آنها را بهراحتی منتشر کنند. به همین دلیل، انویدیا در ۷ ژوئیه ۲۰۲۶ در پخش زندهای با عنوان «چرا دادههای باز اهمیت دارند»، توضیح داد که چگونه دادههای سنتتیک (Synthetic Data) میتوانند این شکاف را پر کنند؛ بهطوری که سیگنالهای مفید حفظ شوند اما اسرار تجاری فاش نشوند.
کاتانزارو از یک اکوسیستم متنوع و مشارکتی حمایت میکند که در آن پژوهشگران، دولتها و جوامع مشارکت داشته باشند. ادعای او یک مسئله دادهمحور است: اگر هر مدل از یک استخر محدودِ داده یاد بگیرد، همه مدلها رفتاری یکسان پیدا میکنند. دادههای سنتتیک که بهصورت باز منتشر میشوند، این معادله را تغییر میدهند و اجازه میدهند مفیدترین دادهها بدون لو دادن مزیت رقابتی شرکتها، به اشتراک گذاشته شوند.
مقیاسپذیری از طریق دادههای باز نموترون
انویدیا در پروژه دادههای باز نموترون (Nemotron)، بیش از ۱۰ تریلیون توکن (Token) — تکههای کوچکی از متن که مثل برشهای یک کیک طولانی هستند و مدل آنها را میخورد — برای پیشآموزش و میلیونها نمونه برای پسآموزش منتشر کرده است. هدف این اقدام، تفسیرپذیر کردن رفتار عاملهاست. این تلاشها در کنار توسعه مدلهای قدرتمندترが見ده میشود؛ بهطوری که مدل Nemotron 3 Ultra توانست در قابلیتهای استدلالی با مدلهای بسته برابری کند و مسیر را برای مدلهای باز هموارتر سازد. طبق گزارشهای منتشر شده، تأثیر این پروژه در تحقیقات مشهود است؛ بهطوری که نزدیک به ۱۴۵ مقاله با استناد به مدلها و دادههای نموترون در کنفرانس بینالمللی یادگیری ماشین (ICML) ارائه شد.
این شرکت چندین مجموعهداده سنتتیک تخصصی برای بهبود قابلیتهای خاص معرفی کرده است:
- Nemotron-CC: استفاده از دادههای مصنوعی برای تقویت مجموعهداده محبوب Common Crawl در مرحله پیشآموزش.
- Nemotron-MATH: بهرهگیری از پرسشهای ریاضی سنتتیک برای ارتقای استدلالهای بنیادی.
- Nemotron-CLIMB: شامل کدهای برنامهنویسی تخصصی مصنوعی برای بهبود وظایف کدنویسی.
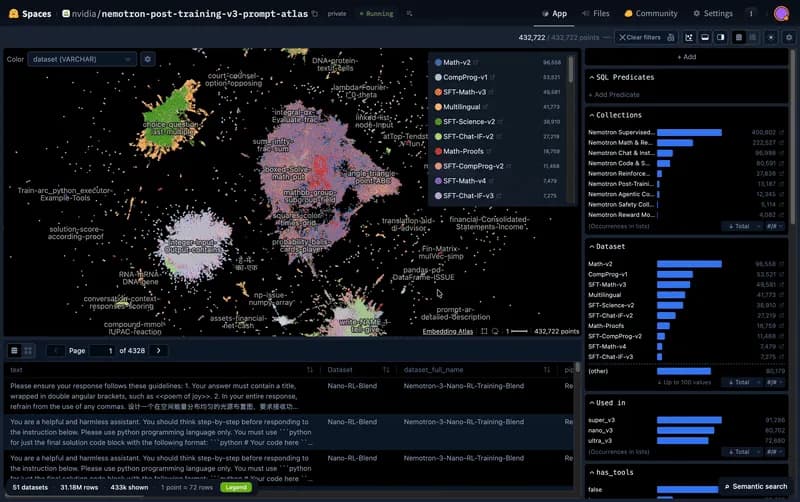
برای کمک به توسعهدهندگان در مدیریت این حجم عظیم داده، انویدیا ابزار Nemotron Post-Training v3 Prompt Atlas را طراحی کرد. از آنجا که جداول خام دادهها غیرقابلفهم هستند، این نقشه بصری تعاملی، هر نقطه را به عنوان یک نمونه پرامپت از مجموعه پسآموزش نموترون v3 نمایش میدهد. این نقاط بهصورت تصادفی نمونهبرداری شدهاند تا نسبت واقعی ترکیبات داده را نشان دهند.

این اطلس به کاربران اجازه میدهد با استفاده از فیلترهای رنگی، نقشه را بر اساس مرحله خط لوله، دامنه، استفاده از ابزار یا نوع مجموعهداده بازسازی کنند. چون پرامپتهای مشابه از نظر معنایی در کنار هم خوشهبندی میشوند، توسعهدهندگان میتوانند روی مناطق خاص — مانند ایمنی، الگوریتمهای کدنویسی یا رفتارهای عاملمحور — زوم کنند و نمونههای شاخص را برای پالایش دادهها یا درک رفتارهای مدل بررسی کنند.
زمینهسازی عاملها در واقعیتهای محلی
کیفیت داده جهانی نیست، بلکه محلی است. این موضوع بهویژه زمانی اهمیت مییابد که عاملها باید افرادی را که پشتیبانی میکنند، درک کنند. برای مثال، یک طبقهبندیکننده سمّیت (Toxicity) که روی دادههای عمومی اینترنت انگلیسی آموزش دیده، ممکن است پیامهای خصمانه در زبانهای کرهای یا ژاپنی را تشخیص ندهد؛ زیرا در این زبانها، پرخاشگری اغلب در سطوح ادب نهفته است، نه در واژگان صریح. سیگنال یکی است، اما زمینه متفاوت است.
انویدیا برای حل این مسئله، مجموعهداده Nemotron-Personas را با استفاده از ابزار NeMo Data Designer ساخت؛ ابزاری پیشرفته برای تولید دادههای سنتتیک در ساختار هوش مصنوعی ترکیبی.
- مبنیسازی محلی: این مجموعه از پرسوناهای مصنوعی استفاده میکند که بازتابدهنده آمار رسمی جمعیتشناختی و جغرافیایی مناطق هستند.
- مقیاس جهانی: این مجموعه که ماه گذشته در نمایشگاه VivaTech پاریس رونمایی شد، اکنون شامل دهمین کشور است و بیش از ۲.۴ میلیارد نفر را نمایندگی میکند.
- هدف: هدف، بازسازی انسانهای واقعی نیست، بلکه کمک به توسعهدهندگان است تا تست کنند آیا سیستمهایشان واقعاً منعکسکننده زبانها، مناطق و مشاغلی است که ادعای پشتیبانی از آنها را دارند.
از آنجا که کیفیت محلی است، تنها کسانی که آن محیط را میشناسند — گویشوران بومی، پژوهشگران منطقهای و متخصصان موضوعی — میتوانند آن را بسازند. این همان مفهوم «یادگیری در فضای عمومی» است: ساخت دادهها بهصورت مشارکتی بهجای انتشار آنها در انزوا.

«آستانه سنتتیک»
ادغام دادههای مصنوعی نیازمند چارچوب جدیدی به نام «آستانههای سنتتیک» است. این نقطهای است که در آن دیگر نمیتوان با دادهها صرفاً بهعنوان دادههای واقعی برخورد کرد. در این آستانه، گردشهای کاری واقعی، بازخوردهای انسانی، ردههای تولید شده توسط مدل، کاربران شبیهسازیشده و برچسبهای سنتتیک با هم درآمیخته میشوند.
به باور براین کاتانزارو، راهکار این نیست که وانمود کنیم دادههای سنتتیک جعلی یا بیخطر هستند. بلکه سازمانها باید دقیقاً مستند کنند که چه چیزی تولید شده، چه چیزی مبنیسازی شده، چه بخشی بازبینی شده و هدف از این دادهها چیست. با آموزش سیستمهای هوش مصنوعی بر روی اطلاعات مصنوعی بیشتر، صنعت به عادتهای مشترکی برای بازبینی و بحث درباره این فناوریها نیاز دارد.
الزامات کیفی بسته به مورد استفاده بهشدت متفاوت است:
- دادههای استدلالی: نیازمند مسائل دشوارتر و ردههای پاکتر هستند.
- دادههای پرسونا: نیازمند وفاداری به توزیع آماری و بازبینی محلیاند.
- گردشهای کاری عاملمحور: نیازمند تنوع بالای وظایف، پوشش شکستها و مسیرهای بازیابی هستند.
در حال حاضر، این حوزه بیشتر شبیه به یک «صنعت دستی» است تا یک فرمول ریاضی؛ به همین دلیل روشهای باز ضروری هستند. دادههای سنتتیک صرفاً برای تولید نمونههای بیشتر نیستند، بلکه برای پرسیدن سؤالات بهترند. این رویکرد اجازه میدهد طرفهایی که پیشتر نمیتوانستند، کنار هم بنشینند: دولتهایی که از حریم خصوصی محافظت میکنند، شرکتهایی که اسرار خود را میپوشانند و پژوهشگرانی که نمیتوانند منتظر اجازه بمانند.
برای توسعهدهندگان، این یعنی منبع کمیاب در هوش مصنوعی دیگر توکنها نیستند، بلکه «اعتماد» بین سازمانهاست. دادههای سنتتیک ابزاری برای ساخت این اعتماد هستند. اگر در حال ساخت عاملها هستید، گام بعدی بررسی مجموعههای داده نموترون در Hugging Face است تا ببینید پرامپتهای سنتتیک برای بازیابی و مدیریت شکست در استفاده از ابزارها چگونه ساختار یافتهاند.
گام بعدی شما
- بررسی مجموعهدادههای Nemotron در Hugging Face برای تحلیل ساختار پرامپتهای مربوط به Recovery.
- استفاده از ابزار Prompt Atlas برای شناسایی خوشههای رفتاری در مدلهای عاملمحور.
- ارزیابی سیستمهای خود با استفاده از پرسوناهای محلی برای شناسایی سوگیریهای فرهنگی یا زبانی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو