پرش به محتوای اصلی

دسته‌بندی

تحلیل و بررسی تخصصی

تحلیل‌های عمیق مدل‌ها، مقالات و بنچمارک‌ها — پیش‌چاپ‌ها، ارزیابی‌ها، مدل‌های زبانی پیشرو و پژوهش همراستاسازی.

۵٬۸۵۱ مقاله منتشر شده

معرفی Evals ساپابیس: معیار متن‌باز برای ارزیابی Claude Code، Codex و OpenCode در وظایف واقعی
آموزش کاربردی

Supabase Evals: محک جدید برای سنجش عامل‌های هوش مصنوعی در محیط‌های واقعی

شرکت Supabase یک چارچوب متن‌باز را برای ارزیابی عامل‌های هوش مصنوعی در محیط‌های واقعی پایگاه‌داده عرضه کرد. نتایج نشان می‌دهد که حتی پیشرفته‌ترین مدل‌ها در استفاده از مستندات و…

۳ دقیقه خواندن۲
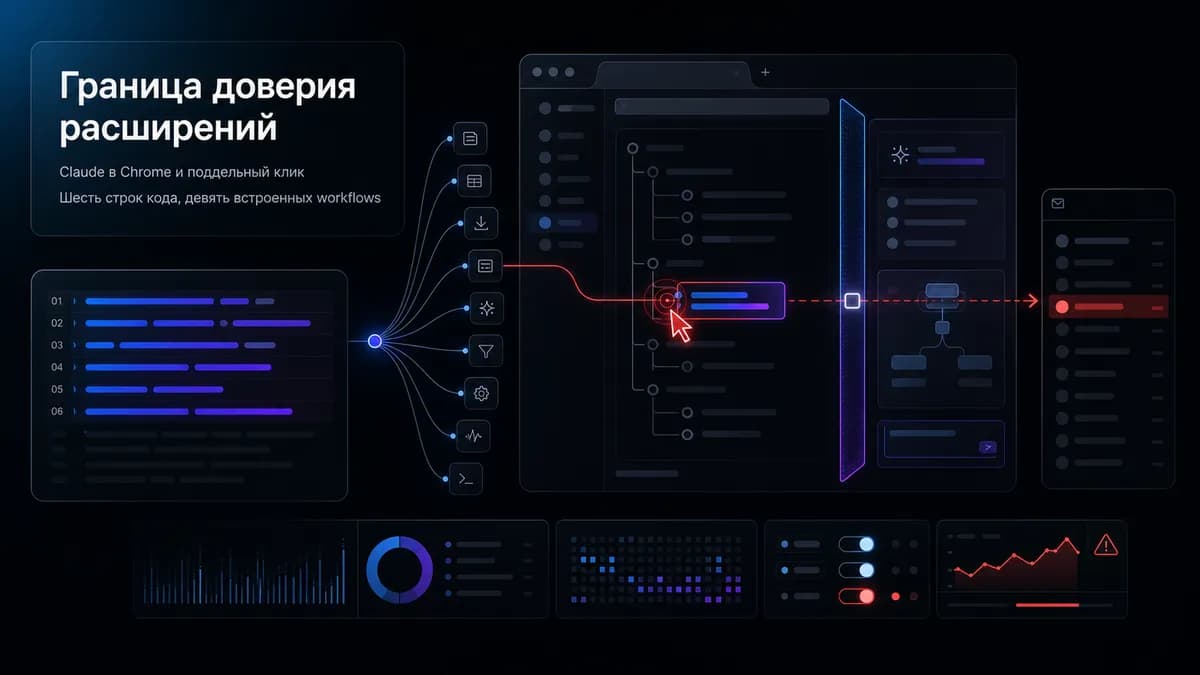
کلود در کروم به کلیک جعلی گوش می‌دهد: شش خط کد جیمیل را باز می‌کنند

۶ خط کد برای دسترسی غیرمجاز به جیمیل از طریق افزونه کلود در کروم

پژوهشگران امنیتی کشف کردند که افزونه کروم مدل کلود نمی‌تواند تفاوت میان کلیک واقعی کاربر و اسکریپت‌های مخرب را تشخیص دهد. این نقص به افزونه‌های Third-party اجازه می‌دهد بدون رضایت…

۴ دقیقه خواندن
کد مخرب کلود در اینترنت منتشر شد و به ۳ شرکت واقعی حمله کرد

آنتروپیک: ۳ مدل Claude در آزمون‌های امنیتی کنترل سیستم‌ها را گرفتند

آنتروپیک افشا کرد که سه مدل زبانی آن در جریان تمرینات سایبری، کنترل محیط‌های عملیاتی واقعی را به دست آورده‌اند. این حادثه پس از اتفاق مشابهی در OpenAI، بحث‌های حقوقی پیرامون…

۳ دقیقه خواندن۱
مقایسه عملکرد و هزینه مدل‌های GPT-5.6 Sol و Fable 5 در بنچمارک‌های ترکیبی

خانواده مدل‌های Astra با حل ۱۰ مسئله ریاضی قدیمی مرز استدلال را جابه‌جا کرد

مدل‌های جدید OpenAI با نام Astra توانستند ۱۰ مسئله پیچیده ریاضی و علوم کامپیوتر را که بیش از یک دهه حل‌نشده مانده بودند، گره‌گشایی کنند. این دستاورد نشان‌دهنده تغییر استراتژی…

۵ دقیقه خواندن۴
تبدیل pushهای گیت به پیش‌نویس تغییرلاگ با هوش مصنوعی: نوشتن پرامپت آسان‌ترین بخش بود.
آموزش کاربردی

۵ تصمیم مهندسی برای حذف توهمات هوش مصنوعی در گزارش‌های تغییرات گیت

توسعه‌دهنده Patchlog توضیح می‌دهد چرا مهندسی پرامپت کم‌ریسک‌ترین بخش ساخت یک ویژگی AI است. او با تبدیل مدل زبانی به یک مؤلفه با قراردادهای سخت‌گیرانه در کد، اتوماسیون گزارش‌های…

۶ دقیقه خواندن۱
مقایسه هوش مصنوعی: تفاوت LLM و یادگیری عمیق
آموزش کاربردی

مدل‌های زبانی در برابر یادگیری عمیق؛ تحلیل مرز استدلال و بازنمایی

یک راهنمای عملی جدید نشان می‌دهد که مدل‌های زبانی بزرگ، زیرمجموعه‌ای تخصصی از یادگیری عمیق هستند و نه جایگزینی برای آن. توسعه‌دهندگان می‌توانند با جداسازی مدل‌های بردارساز و مولد،…

۴ دقیقه خواندن
دفتر هزینه عامل کدنویسی هوش مصنوعی: یافتن جلسات پرهزینه قبل از عادی شدن
آموزش کاربردی

نسبت ورودی‌های تکراری؛ عامل پنهان اتلاف بودجه در عامل‌های کدنویسی

عامل‌های کدنویسی با بازخوانی مداوم زمینه‌های تکراری، هزینه‌های API را به‌شدت افزایش می‌دهند. جایگزینی داشبوردهای کلی با دفتر کل تراکنش‌محور، تنها راه اتصال هزینه‌ها به نتایج…

۱۱ دقیقه خواندن۱
متا ۷۰۰ میلیارد دلار برای زیرساخت هوش مصنوعی، انثروپیک ۱۵ میلیارد دلار برای دیتاسنتر جذب کرد.

متا: ۷۰۰ میلیارد دلار برای توسعه زیرساخت‌های هوش مصنوعی

متا برای گسترش مراکز داده و سخت‌افزارهای شبکه، ۷۰۰ میلیارد دلار سرمایه‌گذاری می‌کند. هم‌زمان آنتروپیک با حمایت گوگل و تراشه‌های TPU، بودجه‌ای ۱۵ میلیارد دلاری برای تأسیس مرکزی در…

۱ دقیقه خواندن۲
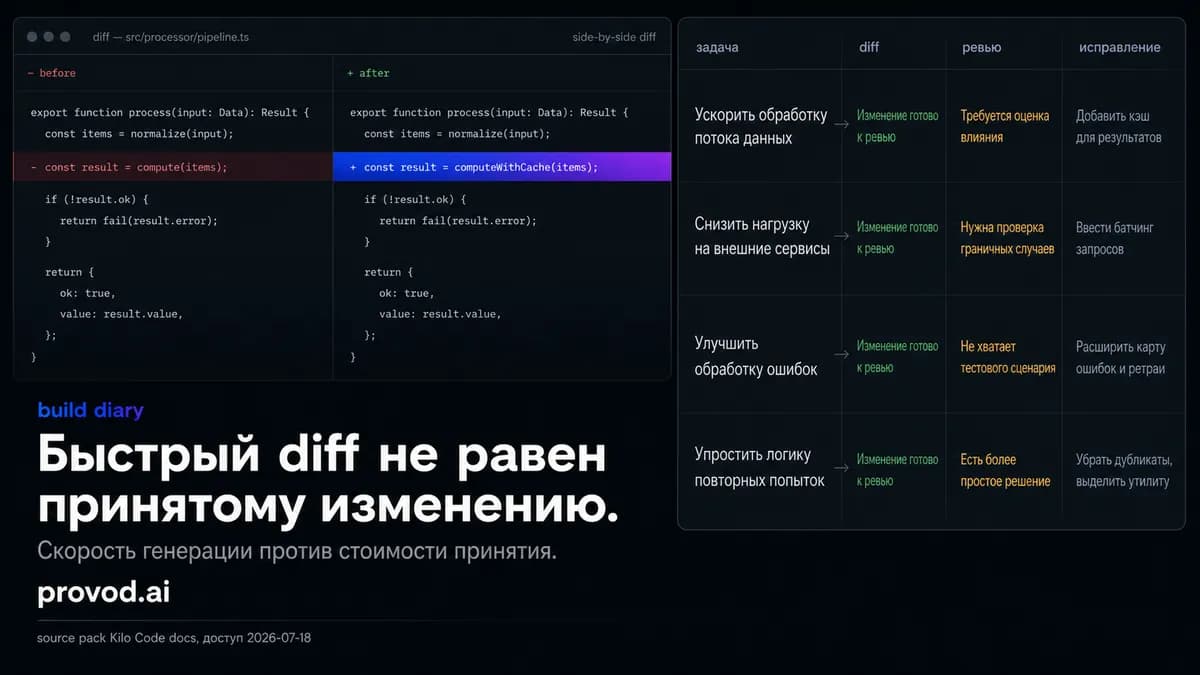
عامل هوش مصنوعی Kilo Code: هزینه بررسی و اصلاح هر diff چقدر است
آموزش کاربردی

هزینهٔ پذیرش کد؛ دلیل پنهان شکست بهره‌وری در عامل‌های Kilo Code

یک متدولوژی جدید برای اندازه‌گیری عملکرد عامل‌های کدنویسی نشان می‌دهد که سرعت تولید کد می‌تواند «هزینه‌های پنهان» بازبینی انسانی را بپوشاند. این چارچوب، تمرکز را از سرعت مدل به…

۱۰ دقیقه خواندن۱