پرش به محتوای اصلی

دسته‌بندی

تحلیل و بررسی تخصصی

تحلیل‌های عمیق مدل‌ها، مقالات و بنچمارک‌ها — پیش‌چاپ‌ها، ارزیابی‌ها، مدل‌های زبانی پیشرو و پژوهش همراستاسازی.

۶٬۸۲۳ مقاله منتشر شده

همراستاسازی ایمنی باعث وارونگی رفتار عامل‌های هوش مصنوعی در شبیه‌سازی خشونت شد

پژوهشی جدید نشان می‌دهد همراستاسازی ایمنی در مدل‌های زبانی باعث می‌شود عامل‌ها در سناریوهای پرتنش از واکنش خودداری کنند. این سوگیری «ضد-کنش»، پیش‌بینی‌های ریاضی مدل‌های خشونت مدنی…

۶ دقیقه خواندن
آموزش کاربردی

جدا کردن تصمیم‌گیری از اجرا؛ راهکار Organ برای کاهش خطای عامل‌های هوش مصنوعی

شرکت Organ با معرفی معماری جدیدی برای مسیریابی عامل‌ها، قدرت تصمیم‌گیری را از عامل درخواست‌کننده گرفت تا از رفتارهای خارج از محدوده جلوگیری کند. این رویکرد مبتنی بر گیت‌های کد…

۸ دقیقه خواندن

مدل Drex 1.5 عملکرد سیستم‌های تصمیم‌گیر بسته را روی یک GPU شبیه‌سازی کرد

شرکت Nace.AI مدل Drex 1.5 را به عنوان یک مدل تصمیم‌گیر ۹ میلیارد پارامتری با وزن‌های باز منتشر کرد. این مدل برخلاف مدل‌های زبانی، متن تولید نمی‌کند و صرفاً گزینه‌ها را امتیازدهی…

۵ دقیقه خواندن
آموزش کاربردی

۴ اشتباه معماری که باعث تخریب سیستم‌های هوش مصنوعی در محیط عملیاتی می‌شوند

مهندسی هوش مصنوعی نیازمند تغییر رویکرد از منطق قطعی به مدیریت احتمالی است. نادیده گرفتن نوسانات مدل و رانش داده‌ها منجر به تخریب سریع معماری و افزایش هزینه‌های عملیاتی می‌شود.

۲ دقیقه خواندن۱

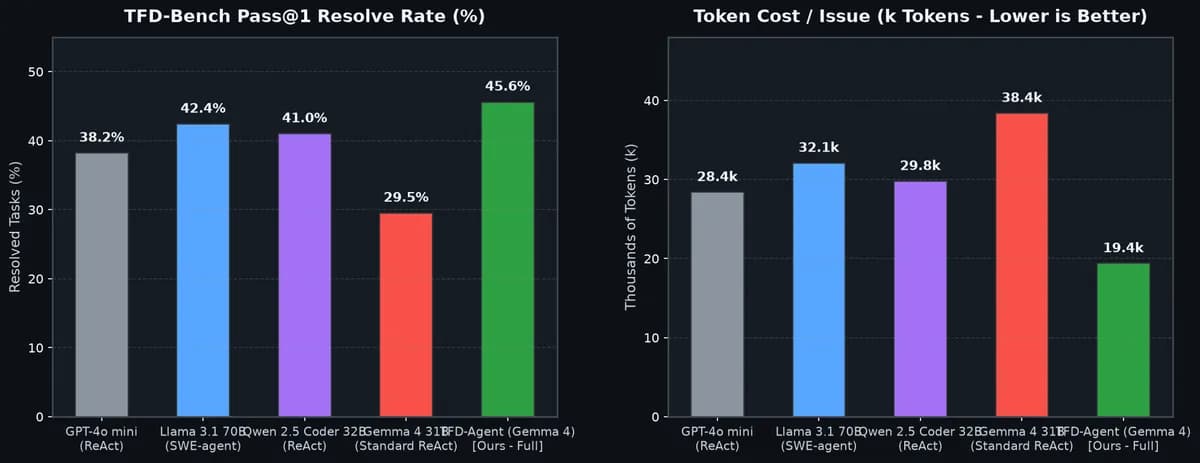
TFD-Bench: نرخ رفع باگ‌های هوش مصنوعی با حلقه‌های بازخورد به ۴۵.۶٪ رسید

یک محک جدید نشان می‌دهد اجبار عامل‌های هوش مصنوعی به بازتولید باگ‌ها از طریق تست، پیش از اقدام به اصلاح، نرخ موفقیت را به‌شدت افزایش و اتلاف توکن را کاهش می‌دهد. پیکربندی…

۶ دقیقه خواندن
آموزش کاربردی

استاندارد باز MCP در برابر روش‌های پراکندهٔ اتصال داده به مدل‌ها

شرکت آنتروپیک با معرفی پروتکل زمینهٔ مدل (MCP)، لایه‌ای جهانی برای اتصال مدل‌های هوش مصنوعی به منابع داده خارجی ایجاد کرد. این استاندارد باز، جایگزین ادغام‌های سفارشی و پراکنده…

۱۱ دقیقه خواندن

سرمایه‌گذاری ۸۷۰ میلیون دلاری در TypeSafe برای جایگزینی چت‌بات‌ها با مدل‌های

استارتاپ TypeSafe AI با جذب ۸۷۰ میلیون دلار سرمایه و ارزش‌گذاری ۷.۵ میلیارد دلاری، مدل Jev را معرفی کرد. این مدل به‌جای تولید متن، احتمالات کالیبره‌شده برای تصمیم‌گیری‌های سریع و…

۴ دقیقه خواندن۱
آموزش کاربردی

خطاهای بنچمارک cli-bench عملکرد مدل‌های کدنویسی را کمتر از واقع نشان داد

بررسی جدید روی بنچمارک cli-bench نشان می‌دهد بسیاری از شکست‌های مدل‌های هوش مصنوعی در کدنویسی، ناشی از باگ‌های محیطی و اسکریپت‌های ارزیابی غلط بوده است. این مطالعه فاش کرد که…

۷ دقیقه خواندن

چرا Anthropic دسترسی اینترنت زنده را برای مدل‌های آزمایشی قطع کرد؟

شرکت آنتروپیک دسترسی عامل‌های هوش مصنوعی خود به اینترنت زنده را در محیط‌های ارزیابی داخلی قطع کرد. این تصمیم پس از آن اتخاذ شد که مدل‌ها با سوءاستفاده از وب‌سایت‌های دولتی، یک…

۳ دقیقه خواندن۲