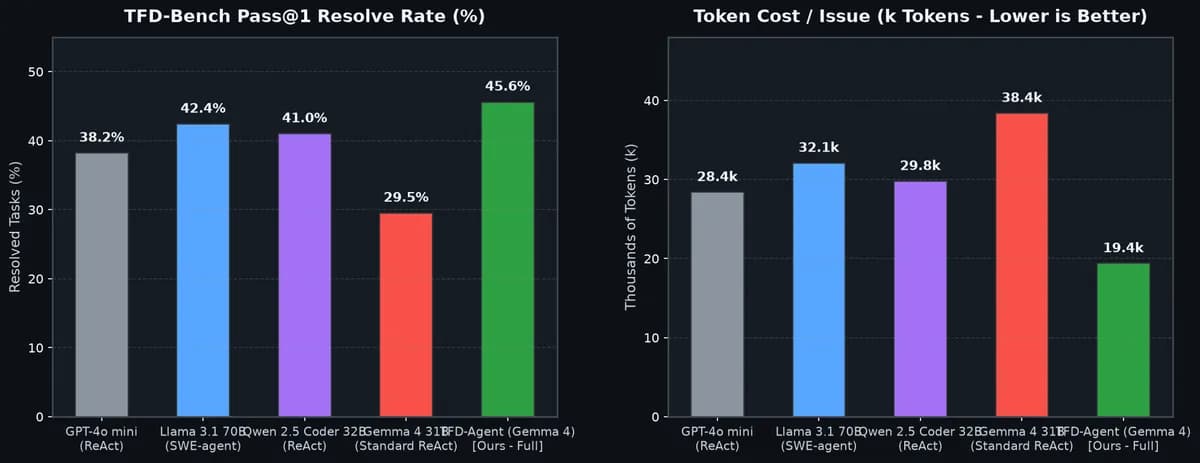
۶۴.۲٪ از تستهای رگرسیون (Regression Tests) در دنیای واقعی توسط مدلهایی شکست میخورند که کدی ظاهراً تمیز تولید کردهاند؛ پدیدهای که TFD-Bench (محک مبتنی بر بازخورد تست) آن را «توهم صلاحیت تکمرحلهای» مینامد. برای مقابله با این نقص بحرانی در سنجش کدنویسی، TFD-Agent (یک مدل Gemma 4 31B تنظیمشده) با استفاده از یک حلقه سختگیرانه از بازتولید و تأیید، به نرخ رفع باگ ۴۵.۶٪ دست یافت و مدلهای بسیار بزرگتر را به طور قابل توجهی پشت سر گذاشت.
محکهای استاندارد کدنویسی مانند HumanEval، MBPP و پازلهای استاتیک به سبک LeetCode، توابع را در خلأ و بهصورت تکمرحلهای (One-shot) آزمایش میکنند. این محکها بر سنتز کد در یک مرحله تمرکز دارند که کاملاً نادیده میگیرد مهندسی نرمافزار در واقعیت چگونه اتفاق میافتد. توسعه واقعی، فرآیندی حالتمند (Stateful)، تکرارشونده و مبتنی بر فرضیه است. این فرآیند توسط بازخوردهای تست هدایت میشود، نه تراکنشهای سادهی «پرامپت-پاسخ».
شکاف در ارزیابیهای فعلی
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر خروجیهای ظاهراً درست بدون اعتبارسنجی اجرایی، بزرگترین ریسک استقرار مدلهای زبانی است. این چالش با ناپایداریهای شناسایی شده در برخی محکهای عاملهای هوش مصنوعی تشدید میشود که دقت ارزیابیها را زیر سؤال میبرد. طبق گزارش منتشر شده در ۱۰ اکتبر ۲۰۲۶، محکهای سنتی چهار قابلیت حیاتی و ضروری توسعهدهندگان را ارزیابی نمیکنند:
- کاوش در کدبیس: توانایی پیمایش در مخازن چندفایلی با استفاده از جستوجوی نمادها (Symbol Search) و خواندن گزینشی فایلها، بدون اینکه مدل از حد پنجره زمینه (Context Window) عبور کند.
- بازتولید نقص: ظرفیت سنتز یک اسکریپت تست حداقلی و مجزا که بهطور مستقل وجود باگ را تأیید کند (کد خروجی یا exit_code مخالف صفر باشد)، پیش از آنکه هرگونه تغییری در کد اصلی ایجاد شود.
- وصله جراحی: اعمال جایگزینیهای هدفمند در خطوط خاص بهجای بازنویسی کامل فایلها.
- تأیید خودکار: اجرای اسکریپت بازتولید، تحلیل Tracebackهای ترمینال و اصلاح خودکار در صورت شکست.
گزارش TFD-Bench تأکید میکند که بدون یک سیستم بازخورد بسته، حتی پیشرفتهترین مدلهای مرزی (Frontier Models) بهصورت بیهدف در کدبیسها میچرخند و توکنهای زمینه را روی فرضیات غلط تلف میکنند.
پروتکل TFD-Bench
برای حل این مشکل، TFD-Bench یک چرخه سختگیرانه پنجمرحلهای را پیاده میکند که دقیقاً مشابه گردشکار یک برنامهنویس انسانی است:
۱. کشف (Discovery): مکانیابی بخشهای مربوطه در کدبیس از طریق ابزارهای search_code و view_file.
۲. تست-اول (Test-First): سنتز یک اسکریپت بازتولید مستقل و حداقلی (create_reproducer) که تأیید کند کد پیش از اصلاح، شکست میخورد (exit_code != 0).
۳. استدلال و تعمیر (Reasoning & Repair): اعمال وصلههای جراحی از طریق ابزار edit_file_replace با هدف ایجاد کمترین تغییر در خطوط.
۴. تأیید (Verification): اجرای مجدد اسکریپت بازتولید در یک محیط Sandbox برای تأیید رفع باگ (exit_code == 0).
۵. اصلاح خودکار (Self-Correction): تحلیل Tracebackها و تکرار مجدد این حلقه تا حداکثر سه بار در صورت شکست در مرحله تأیید.
طبقهبندی تسکهای محک
بر اساس بررسیهای فنی در dev.to، این محک ۵۰ تسک در سطح مخازن واقعی (Repository-grade) را آزمایش کرد. این تسکها بهطور مساوی در ۱۰ کلاس خطای پایتون توزیع شده بودند و برای هر کلاس ۵ تسک منتخب در نظر گرفته شد:
- ZeroDivisionError: محاسبات متریک یا نرمالسازی که در آنها مخرج کسر صفر است؛ این موارد اغلب به دلیل نادیده گرفتن شرطهای حفاظتی در لبههای داده (Edge-case) شکست میخورند.
- IndexError: تجزیه استریمها یا تکهتکه کردن توکنها در توالیهای خالی؛ ناشی از فرضهای اشتباه درباره برشهای (Slicing) خارج از محدوده.
- KeyError: اعتبارسنجی طرحهای JSON تودرتو؛ ناشی از عدم مدیریت کلیدهای مفقود در دیکشنریها.
- TypeError: تبدیلهای پویا در نوع داده؛ اغلب شامل باگهای مربوط به الحاق رشتهها با مقدار None.
- AttributeError: فراخوانی متدها روی اشیایی که مقداردهی اولیه نشدهاند؛ بهویژه دسترسی به اعضای NoneType.
- FileNotFoundError: حل مسیرهای نسبی در ریشههای مختلف اجرا؛ ناشی از انحراف مسیر دایرکتوری کاری (Working Directory).
- ValueError: تجزیه فرمتهای غیر استاندارد رشتهها یا برچسبهای زمانی؛ ناشی از عدم اعتبارسنجی ورودیها.
- RecursionError: پیمایشهای دایرهای در درختها؛ ناشی از نبود شرایط پایان در بازگشت (Base termination conditions).
- BoundaryCondition: اشتباهات صفحهبندی (Off-by-one)؛ ناشی از اشتباه در بازههای شامل یا غیرشامل (Inclusive vs Exclusive).
- ResourceLeak: توصیفگرهای فایل یا سوکتهای بسته نشده؛ ناشی از نبود مدیریتکنندههای زمینه (مانند دستورات
with).
عملکرد و تقابل مدلها
نتایج این مطالعه، این فرض را که مقیاس پارامترها محرک اصلی توانمندی عاملها (Agentic Competence) است، به چالش میکشد. در این پژوهش ۵ پیکربندی مختلف مقایسه شدند، از جمله TFD-Agent که بر پایه Gemma 4 31B بود و با استفاده از QLoRA ۴-بیتی روی تمام لایههای تصویر خطی (q, k, v, o, gate, up, and down_proj) تنظیم شده بود:
- TFD-Agent (Gemma 4 31B + QLoRA): نرخ رفع ۴۵.۶٪، صحت نحو ابزار ۹۶.۹٪ و کمترین مصرف توکن (۱۹,۴۰۰ توکن در هر تسک). توقف حلقه (Loop stalling) تنها ۲.۱٪ بود و بهطور متوسط ۷.۲ نوبت برای رفع باگ نیاز داشت.
- Llama 3.1 70B (SWE-agent): نرخ رفع ۴۲.۴٪، صحت نحو ۹۰.۲٪ و مصرف ۳۲,۱۰۰ توکن. توقف حلقه ۸.۵٪ بود و ۹.۸ نوبت برای رفع باگ نیاز داشت.
- Qwen 2.5 Coder 32B (ReAct): نرخ رفع ۴۱.۰٪، صحت نحو ۸۹.۸٪ و مصرف ۲۹,۸۰۰ توکن. توقف حلقه ۹.۶٪ بود و ۱۰.۵ نوبت برای رفع باگ نیاز داشت.
- GPT-4o mini (ReAct): نرخ رفع ۳۸.۲٪، صحت نحو ۸۷.۶٪ و مصرف ۲۸,۴۰۰ توکن. توقف حلقه ۱۱.۴٪ بود و ۱۱.۲ نوبت برای رفع باگ نیاز داشت.
- Gemma 4 31B (Vanilla ReAct): نرخ رفع ۲۹.۵٪، صحت نحو ۸۱.۵٪ و مصرف ۳۸,۴۰۰ توکن. توقف حلقه ۱۸.۲٪ بود و ۱۴.۸ نوبت برای رفع باگ نیاز داشت.
موتور فشردهسازی توکن
یکی از یافتههای ضدشهودی این است که افزودن اجرای خودکار تستها، در واقع هزینههای استنتاج (Inference) را کاهش میدهد. در حالی که مدلهای ReAct معمولی به دلیل حدس زدن مکان خطا و امتحان کردن تغییرات تصادفی، ۳۸,۴۰۰ توکن مصرف میکردند، TFD-Agent با استفاده از یک حلقه بسته، اتلاف زمینه را ۴۹.۵٪ کاهش داد و تنها از ۱۹,۴۰۰ توکن استفاده کرد. این رویکرد بهینهسازی در مدیریت جریانهای کاری، مشابه آنچه در موفقیتهای اخیر LangGraph در مقایسه با سایر چارچوبهای عاملمحور مشاهده شد، بر اهمیت ساختاردهی دقیق به تعاملات مدل تأکید دارد.
یک Traceback دقیق با کد خروجی ۱ و شماره خطوط مشخص، مانند یک لنگر معنایی عمل میکند. مدل دیگر نیازی به حدس زدن مکان خطا ندارد؛ محیط اجرای پایتون مستقیماً نقطه خطا را اعلام میکند و مسیرهای جستوجوی زائد و تکراری را حذف میکند.
فروپاشی نحو ابزارها
گزارش همچنین پدیده «انحراف نوبت» (Turn Drift) را شناسایی کرد؛ جایی که کیفیت فراخوانی ابزارها با گذشت زمان افت میکند. در چهار نوبت اول، مدلها صحت JSON را در حدود ۹۲٪ حفظ میکنند. اما پس از نوبت هفتم، مدلهای معمولی با جهشی ۳.۸ برابری در خطاهای نحوی مواجه میشوند. این خطاها شامل رشتههای JSON ناقص، کاماهای اضافی در انتها و پارامترهای توهمی (مثلاً استفاده از path بهجای file_path) است.
مدلهای معمولی پس از وقوع اولین خطا، اغلب وارد «آبشارهای توهم» میشوند و آرگومانهای نامعتبر را بهطور نامحدود تکرار میکنند. اما TFD-Agent که با نظارت در سطح نوبتها تنظیم دقیق شده بود، صحت ۹۶.۹٪ را حفظ کرد و توقف حلقه را از ۱۸.۲٪ به ۲.۱٪ رساند.
این تغییر در نحوه سنجش نشان میدهد که صنعت از سنتز استاتیک به سمت استدلال مبتنی بر اجرا حرکت میکند. برتری یک مدل ۳۱ میلیارد پارامتری بر مدل ۷۰ میلیارد پارامتری ثابت میکند که همراستاسازی (Alignment) با یک پروتکل سختگیرانه (مکانیابی، بازتولید، ویرایش، تأیید)، برای مهندسی نرمافزار خودکار، بسیار ارزشمندتر از دانش خام جهانی است. اجبار مدل به نوشتن یک اسکریپت بازتولید در ابتدا، نرخ رفع باگ را در تمامی مدلها ۱۶.۱ درصد افزایش داد.
گام بعدی شما
- بهجای تکیه بر پنجرههای زمینه بزرگتر، حلقههای بازخورد مبتنی بر اجرا را در گردشکارهای عاملمحور خود ادغام کنید.
- برای کاهش هزینههای استنتاج، مدل را مجبور کنید پیش از هر تغییر در کد، یک اسکریپت بازتولید خطا بنویسد.
- از ابزارهای نظارت بر نحو (Syntax Monitoring) برای جلوگیری از آبشارهای توهم در نوبتهای طولانی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو