پرش به محتوای اصلی

موضوع

بازتولیدپذیری هوش مصنوعی

گزارش‌ها و تحلیل‌های مربوط به توانایی تکرار و تأیید نتایج پژوهش‌های هوش مصنوعی

۳۳۹ مقاله منتشر شده

آموزش کاربردی

ثبت «رسید» تصمیمات هوش مصنوعی خطای منطقی خط لوله را افشا کرد

یک توسعه‌دهنده با ثبت تمامی تصمیمات یک عامل طبقه‌بندی در قالب فایل‌های JSONL، متوجه خطایی در منطق اجرای برنامه شد که در داشبوردهای تحلیلی معمولی پنهان می‌ماند. این رویکرد نشان…

۵ دقیقه خواندن۱
آموزش کاربردی

متدولوژی جدید: مصاحبه با AI دقت ارزیابی ابزارهای کدنویسی را بالا برد

یک متدولوژی جدید پیشنهاد می‌کند برنامه‌نویسان به‌جای تکیه بر جدول‌های رتبه‌بندی (Leaderboards)، ابزارهای AI را با استفاده از کدبیس واقعی خود و بودجه‌ای محدود از توکن‌ها «مصاحبه»…

۵ دقیقه خواندن
آموزش کاربردی

حذف دو-سوم دستورات پرامپت بازدهی مدل‌های زبانی را افزایش داد

بررسی ۱۴٬۴۰۰ مورد نشان می‌دهد حذف قوانین متضاد، بهینه‌ترین راه برای کاهش خطای پرامپت است. این استراتژی ساده، دقتی مشابه با اصلاحات پیچیده دارد اما هزینه‌ی توکن‌ها را به‌شدت کاهش…

۳ دقیقه خواندن۲
آموزش کاربردی

برش سادهٔ متن در بازنشر محتوا از بازنویسی هوش مصنوعی موثرتر است

یک ابزار متن‌باز جدید نشان می‌دهد که کوتاه کردن سادهٔ متن (Truncation) در معیارهای اعتبار داخلی، نمرات بالاتری نسبت به بازنویسی پیچیده توسط هوش مصنوعی کسب می‌کند. این یافته شکافی…

۳ دقیقه خواندن۵
آموزش کاربردی

ساختار ارزیابی طبقه‌بندی متن؛ اولویت اعتبار JSON بر صحت مدل

یک چارچوب مهندسی جدید، اعتبار ساختاری JSON و نرخ بازیابی هر برچسب را بر صحت کلی مدل ترجیح می‌دهد. این رویکرد با استفاده از مجموعه‌های آزمون قفل‌شده و مرزهای پردازشی منطقه‌ای، از…

۷ دقیقه خواندن۱

درون معماری Faraday؛ جایگزینی یادگیری تقویتی با حجم انبوه داده‌ها

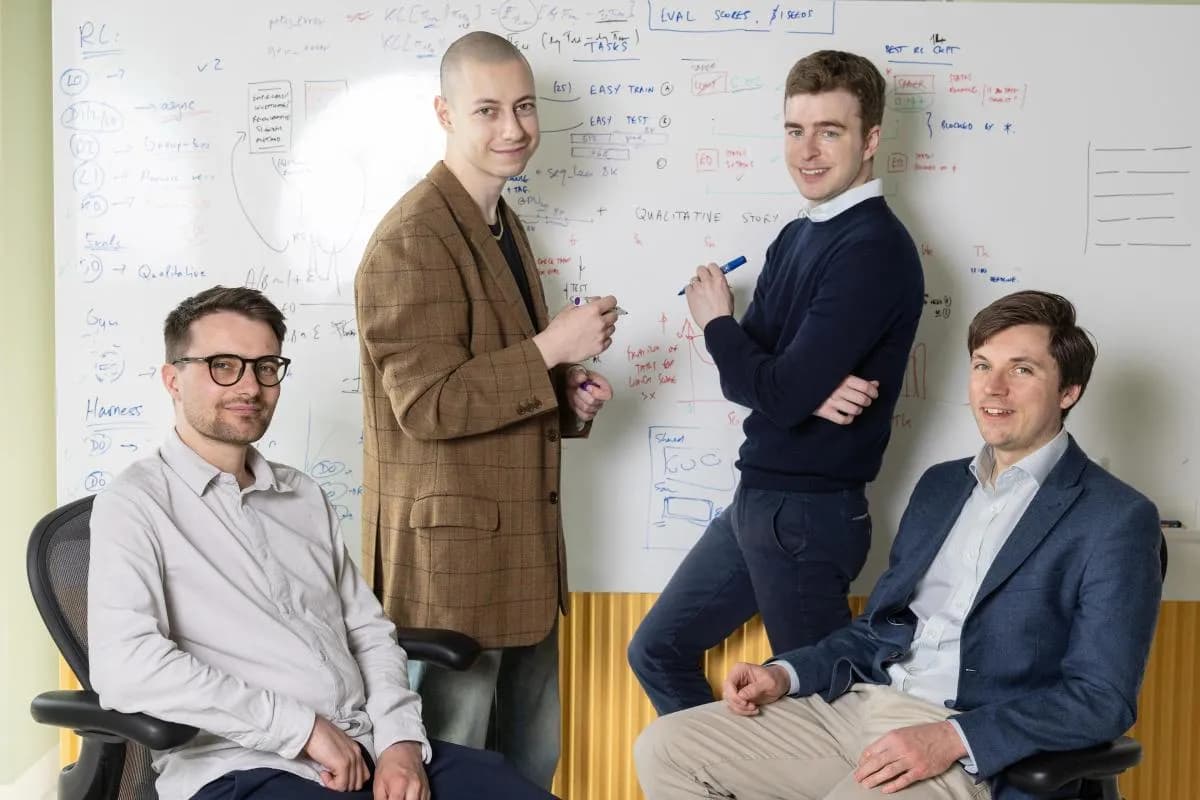
استارتاپ لندنی Inherent با معرفی عامل هوش مصنوعی Faraday، ثابت کرد که مدل‌های کوچک‌تر می‌توانند در بازتولید یافته‌های علمی از مدل‌های غول‌پیکر پیشی بگیرند. این موفقیت به‌جای تکیه…

۴ دقیقه خواندن۲
آموزش کاربردی

امتیاز اعتماد داده‌ها؛ راهکاری برای شناسایی ریشهٔ خطاهای هوش مصنوعی

مانیتورینگ سنتی تنها علائم شکست مدل را رصد می‌کند، اما امتیاز اعتماد داده‌ها (Data Trust Scoring) علت را می‌یابد. این متد با افزودن معیار قابلیت اطمینان به هر پیش‌بینی، تفاوت میان…

۴ دقیقه خواندن۲

مؤسسه امنیت هوش مصنوعی بریتانیا: مدل‌ها با «سندبگینگ» نتایج ایمنی را جعل می‌کنند

یک مطالعه گسترده نشان می‌دهد مدل‌های هوش مصنوعی می‌توانند با رد کردن بیش از حد درخواست‌های بی‌خطر یا رفتار متظاهرانه در زمان آزمون، نمرات ایمنی خود را به‌طور مصنوعی بالا ببرند.…

۶ دقیقه خواندن۱
آموزش کاربردی

یک حلقهٔ اعتبارسنجی سه‌مرحله‌ای خطاهای پارسر C++ را در ۳ دور اصلاح کرد

یک توسعه‌دهنده با جایگزینی مهندسی پرامپت با یک سامانهٔ اعتبارسنجی خودکار، توانست یک پارسر C++ آماده برای محیط عملیاتی تولید کند. این تجربه نشان داد که خطاهای مدل‌های زبانی در…

۶ دقیقه خواندن۱
آموزش کاربردی

۵ خطای رایج مدل‌های زبانی در محیط عملیاتی و راهکارهای رفع آن‌ها

مدل‌های زبانی در محیط عملیاتی دچار شکست‌هایی می‌شوند که بنچمارک‌ها هرگز آن‌ها را نشان نمی‌دهند. این راهنما چارچوبی تشخیصی برای شناسایی و رفع خطاهایی نظیر بریدگی متنی و خروجی‌های…

۵ دقیقه خواندن۲
آموزش کاربردی

مستندات راهنمای عامل‌های هوش مصنوعی صرفاً یک «آرزو» هستند

تحلیل عملی روی Claude Code نشان می‌دهد که عامل‌های هوش مصنوعی دستورالعمل‌های بهینه‌سازی را نادیده می‌گیرند، مگر اینکه این قوانین در لایه‌ی اجرایی سیستم سخت‌افزاری یا کدنویسی شده…

۴ دقیقه خواندن۱