Judge Bait: مدلهای زبانی کوچک در برابر ظواهر رسمی شکست خوردند
محک جدیدی به نام Judge Bait نشان میدهد مدلهای زبانی کوچک هنگام داوری، صحت پاسخ را فدای نشانههای ظاهری مثل برچسب «تأیید شده» میکنند. در حالی که مدلهای پیشرو استوار ماندند،…
موضوع
گزارشها و تحلیلهای مربوط به توانایی تکرار و تأیید نتایج پژوهشهای هوش مصنوعی
۳۳۹ مقاله منتشر شده
محک جدیدی به نام Judge Bait نشان میدهد مدلهای زبانی کوچک هنگام داوری، صحت پاسخ را فدای نشانههای ظاهری مثل برچسب «تأیید شده» میکنند. در حالی که مدلهای پیشرو استوار ماندند،…
یک محک جدید نشان میدهد برترین مدلهای هوش مصنوعی در محاسبات سود مرکب و سیستمهای شمارهگذاری منطقهای شکست میخورند. این یافتهها تأکید میکند که مدلهای زبانی نباید محاسبات مالی…
یک محک جدید در Kaggle نشان میدهد که افزایش پارامتر reasoning_effort در چهار مدل برتر، بهندرت منجر به بهبود صحت پاسخها میشود اما بهطور مداوم هزینهها را افزایش میدهد. تنها…
سرویس پیشچاپ arXiv از اول اکتبر ۲۰۲۶ سقف ارسال مقالات را به دو مورد در ماه برای هر نویسنده محدود میکند. این تصمیم برای جلوگیری از اشباع پلتفرم توسط مقالات کمکیفیت و تولیدشده…
یک محک جدید نشان میدهد مدلهای اقتصادی در وظایف بومی پاکستان، مانند سیستم عددنویسی لک/کرور و خط اردو، عملکردی مشابه مدلهای گرانقیمت دارند. این یافتهها ثابت میکند برای دانش…
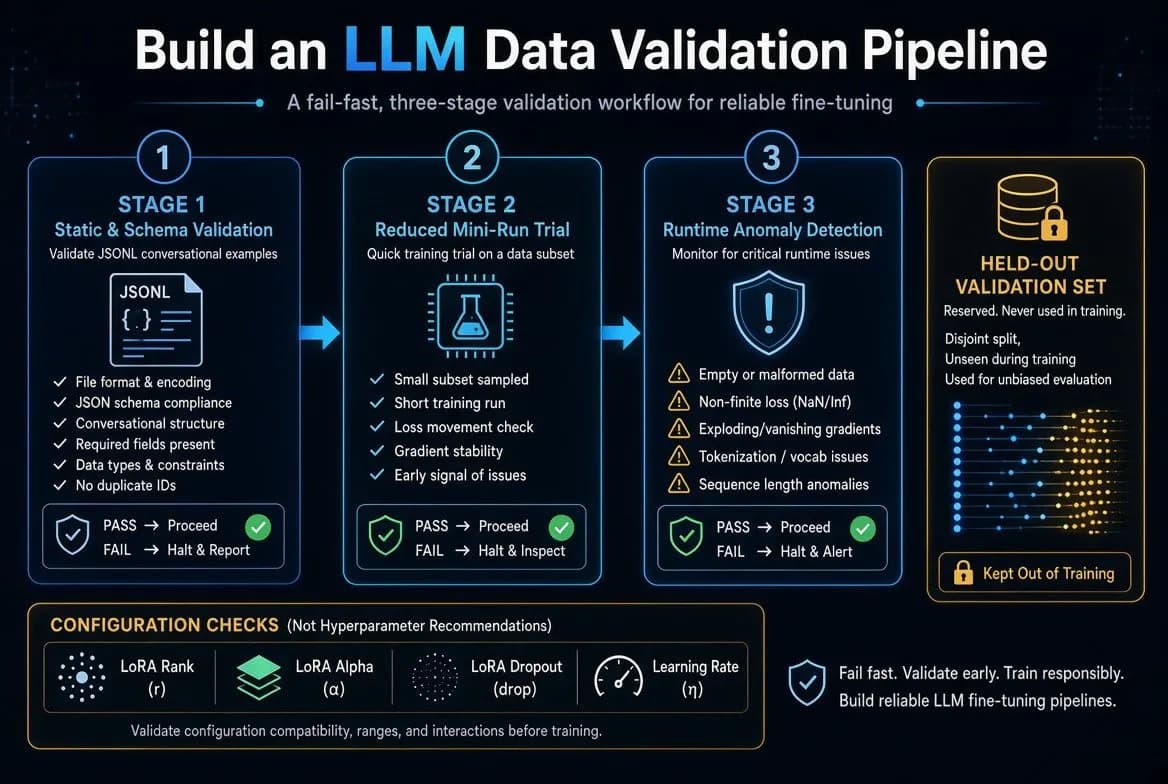
یک چارچوب فنی جدید با پیادهسازی گردشکار اعتبارسنجی پیشرونده، خطاهای ساختاری دادهها و ناهنجاریهای زمان اجرا را پیش از شروع آموزشهای گرانقیمت شناسایی میکند. این متد با…
یک بنچمارک جدید نشان میدهد که «فراموشی» مدلهای هوش مصنوعی در گفتگوهای طولانی، بیشتر ناشی از نقص ابزارهای ارزیابی است تا ضعف حافظه مدل. آزمایش روی Gemini 3.7 Flash ثابت کرد که…
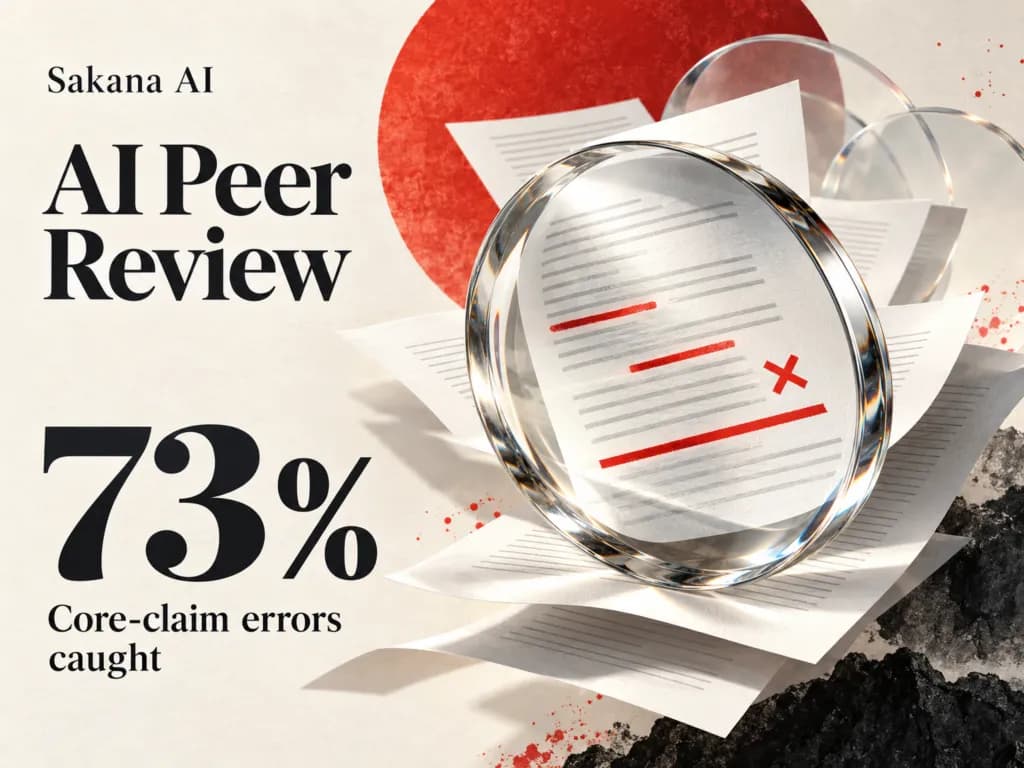
شرکت Sakana AI یک سامانه عاملمحور چندلایه برای شناسایی تناقضات در مقالات پژوهشی توسعه داده است که بازدهی آن در تشخیص خطاهای کلیدی، ۵ برابر بیشتر از مدلهای زبانی استاندارد است.…
یک متد اعتبارسنجی محلی جدید از تلاش عاملهای هوش مصنوعی برای بازاجرایهای هزینهبر جلوگیری میکند، مگر آنکه ساختار ردپای اجرا (Execution Trace) کاملاً سالم باشد. این روش با تبدیل…
مقایسه امتیازات پرامپت در نسخههای مختلف مدل، اغلب منجر به تشخیص اشتباه کیفیت یا رگرسیون میشود. مکانیزم جدید «قرنطینه» تضمین میکند که تغییرات امتیازی تنها زمانی قابل اعتماد…
پژوهشی جدید نشان میدهد همراستاسازی ایمنی در مدلهای زبانی باعث میشود عاملها در سناریوهای پرتنش از واکنش خودداری کنند. این سوگیری «ضد-کنش»، پیشبینیهای ریاضی مدلهای خشونت مدنی…
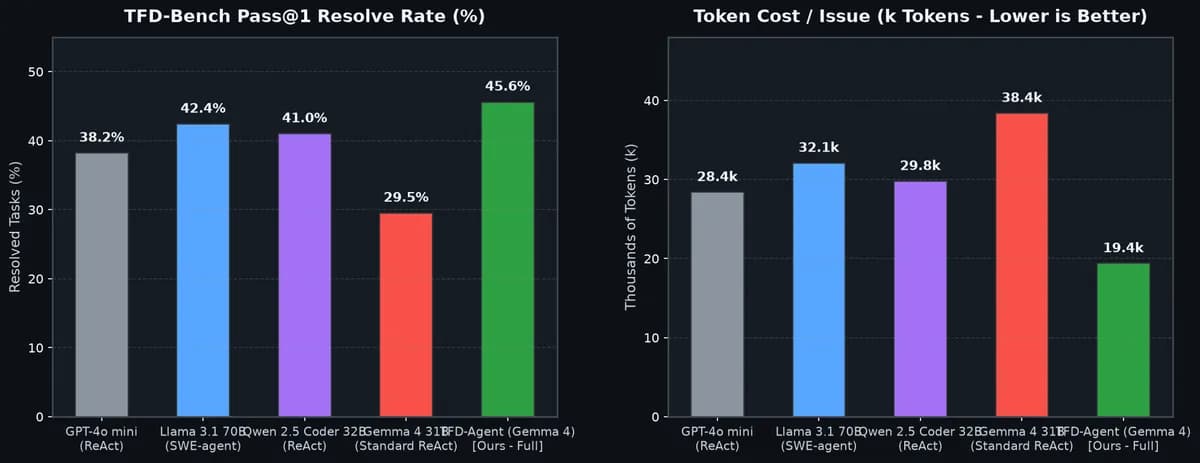
یک محک جدید نشان میدهد اجبار عاملهای هوش مصنوعی به بازتولید باگها از طریق تست، پیش از اقدام به اصلاح، نرخ موفقیت را بهشدت افزایش و اتلاف توکن را کاهش میدهد. پیکربندی…