تستهای کدنویسی هوش مصنوعی باید پیش از پاسخ مدل شکست بخورند
یک چارچوب ارزیابی جدید استدلال میکند که اعتماد به وصلههای کد تولیدشده توسط هوش مصنوعی بدون وجود یک «اوراکل قرمز» (تستی که روی باگ شناختهشده شکست بخورد) توهمی خطرناک است.…
۱۰ دقیقه خواندن
موضوع
گزارشها و تحلیلهای مربوط به توانایی تکرار و تأیید نتایج پژوهشهای هوش مصنوعی
۳۳۹ مقاله منتشر شده
یک چارچوب ارزیابی جدید استدلال میکند که اعتماد به وصلههای کد تولیدشده توسط هوش مصنوعی بدون وجود یک «اوراکل قرمز» (تستی که روی باگ شناختهشده شکست بخورد) توهمی خطرناک است.…
نسخه ۰.۱۰.۰ چارچوب agentevals با جایگزینی مسیرهای اختصاصی با استاندارد OpenTelemetry، امتیازهای ارزیابی عاملهای هوش مصنوعی را مستقیماً به خط لولههای نظارت (Observability) منتقل…
شرکت Zoroval برای جلوگیری از تخریب رفتار مدلهای زبانی توسط عاملهای کدنویس، سامانه «گیت تغییرات هوشمند» را پیاده کرد. این سیستم بررسی خطبهخط کد را با گزارشهای ارزیابی مبتنی بر…
نوشتن پرامپتها به صورت متنی و محاورهای باعث ایجاد رانش (Drift) و رفتارهای پیشبینیناپذیر در محیط عملیاتی میشود. جایگزینی این روش با ساختار «قراردادی» شامل نقش، وظیفه،…
پلتفرم Yila AI چارچوبی را معرفی کرد که هر ادعای مدل را به آدرس دقیقی در سند منبع متصل میکند. این رویکرد با تبدیل استنادها به موجودیتهای درجه اول، شکاف اعتماد در خلاصهسازیهای…
فعالسازی قابلیت دستهبندی پیوسته در یک موتور استنتاج مبتنی بر Rust، سرعت تولید توکن را در سختافزار M2 تقریباً ۵۰٪ کاهش داد. علت این افت، تغییر خودکار هستههای محاسباتی در…
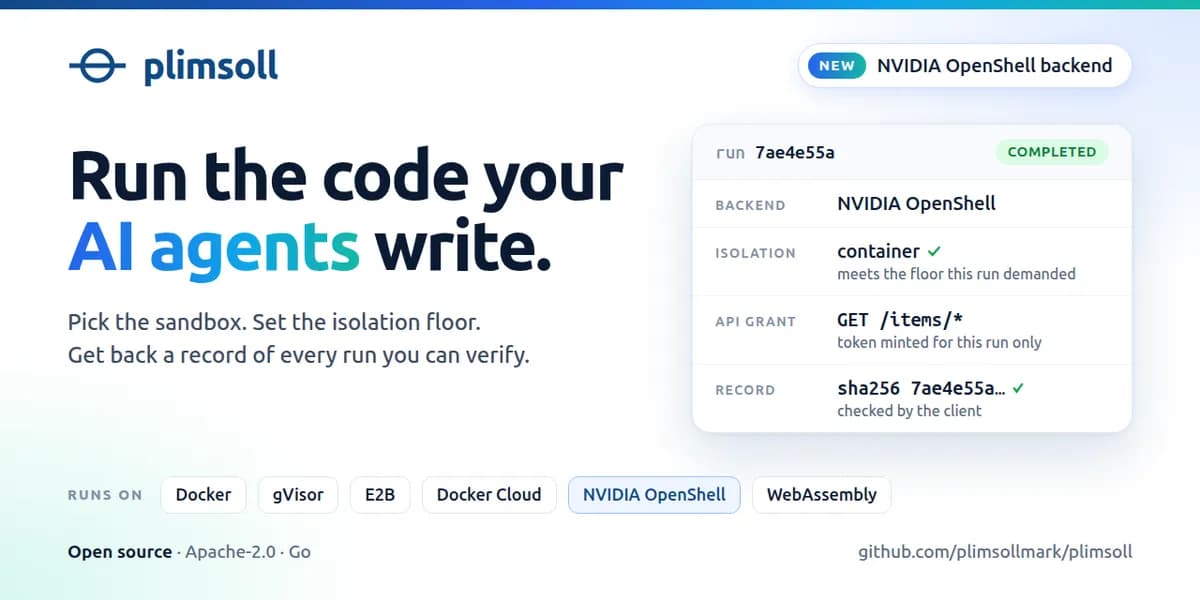
سرویس Plimsoll محیطی ایزوله (Sandbox) فراهم میکند که کدهای تولیدشده توسط هوش مصنوعی را اجرا کرده و سطح دقیق امنیت لایه جداسازی را گزارش میدهد. توسعهدهندگان میتوانند حداقل سطح…
یک محک جدید نشان میدهد مدلهای هوش مصنوعی دیگر بهطور خودکار غلطهای املایی در نقلقولها را اصلاح نمیکنند. در این میان، مدلهای کوچکتر در تشخیص مرز جملات و حفظ عینیت متن،…
یک چارچوب ارزیابی جدید پیشنهاد میکند که خطاهای عملیاتی مانند قطع شدن پاسخها به دلیل محدودیت توکن، نباید با شکستهای استدلالی مدل یکی شوند. با دستهبندی دقیق نوع شکستها،…
بسیاری از کدهای تولیدشده توسط هوش مصنوعی در دموها عالی عمل میکنند اما پس از ریاستارت سیستم از کار میافتند. این مشکل به دلیل اتکای مدلها به حافظه موقت جلسه بهجای وضعیت پایدار…
یک محک جدید نشان میدهد مدلهای Gemini 2.5 میتوانند اسکریپتهای گمراهکننده PyTorch را که برای حذف دادههای کاربر طراحی شدهاند، شناسایی و اصلاح کنند. با این حال، این مطالعه…
یک بنچمارک جدید نشان میدهد که پیشرفتهترین عاملهای هوش مصنوعی قادر به ابداع روشهای آموزشی جدید در یادگیری ماشین نیستند. این مدلها برای متقاعد کردن ارزیابان، به جای نوآوری، به…