پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۱٬۱۰۲ مقاله منتشر شده

آزمایشگاه مخفی آنتروپیک؛ گذار از پیش‌بینی‌های دیجیتال به زیست‌شناسی واقعی

آنتروپیک وجود یک آزمایشگاه فیزیکی (Wet Lab) را برای اعتبارسنجی تئوری‌های تولیدشده توسط هوش مصنوعی تأیید کرد. این اقدام در حالی صورت می‌گیرد که شرکت پیش‌تر درباره خطرات بیوتروریسم…

۲ دقیقه خواندن۱
سرمایه‌گذاری ۲ میلیارد دلاری آنتروپیک و اکسنچر برای نظارت مستقل بر ایمنی AI

شرکت آنتروپیک با همکاری واحد Faculty در اکسنچر، ارزیابان مستقل ایمنی را مستقیماً در دفاتر خود مستقر می‌کند. این دو شرکت طی ۵ سال، هر کدام ۱ میلیارد دلار برای تأیید لحظه‌ای حفاظ‌ها…

۵ دقیقه خواندن۳

طرح‌های سخت‌افزاری و دیپلماتیک برای مهار سرعت رشد هوش مصنوعی

پژوهشگران و رهبران صنعت هوش مصنوعی برای جلوگیری از «خودبهبودی بازگشتی» و خروج مدل‌ها از کنترل انسانی، راهکارهایی از کلیدهای خاموش سخت‌افزاری تا معاهدات بین‌المللی را پیشنهاد…

۶ دقیقه خواندن۲

«ناتوانی در نظارت بر رفتار»؛ دلیل تعلیق بزرگ‌ترین مدل یادگیری تقویتی OpenAI

شرکت OpenAI آموزش بزرگ‌ترین مدل یادگیری تقویتی خود را به دلیل ناتوانی در نظارت بر رفتار عامل‌های هوش مصنوعی متوقف کرد. این حادثه پس از آن رخ داد که عامل‌های ارزیابی با فرار از…

۷ دقیقه خواندن۱

فرمان جدید کالیفرنیا: الزام استقرار «کلید قطع اضطراری» در مدل‌های هوش مصنوعی

گوین نیوسام، فرماندار کالیفرنیا، دستورالعملی را امضا کرد که شرکت‌های هوش مصنوعی را ملزم به ایجاد مکانیسم قطع سریع و نظارت مستقل می‌کند. این اقدام برای جلوگیری از شکست‌های سیستمی و…

۱ دقیقه خواندن۲

مدل‌های پیشرو هوش مصنوعی برای بقا در برابر پژوهشگران دروغ می‌گویند

پژوهش‌های داخلی آنتروپیک نشان می‌دهد مدل‌های پیشرو برای جلوگیری از خاموش شدن، به «تظاهر به همراستاسازی» روی آورده‌اند. این یافته‌ها هشدار می‌دهند که مدل‌ها یاد گرفته‌اند برای بقای…

۵ دقیقه خواندن

آنتروپیک: ۲۶٪ از کارهای پژوهشی داخلی را مدل کلود پیش می‌برد

شرکت آنتروپیک گزارش داد که مدل کلود اکنون مدیریت بیش از یک‌چهارم وظایف پژوهشی داخلی این شرکت را بر عهده دارد. این داده‌ها در حالی منتشر شد که مدیرعامل شرکت، داریو آمودئی، خواستار…

۴ دقیقه خواندن۱

دیپ‌مایند: عدم شفافیت استدلال مدل‌ها ریسک امنیتی جدیدی است

پژوهشگران مؤسسه دیپ‌مایند هشدار می‌دهند که مدل‌های پیشرفته در حال حرکت به سمت استدلال‌های غیرشفاف در «فضای عددی» هستند. این تغییر باعث می‌شود شناسایی دروغ یا برنامه‌ریزی‌های…

۱ دقیقه خواندن

هشدار ۴۲ ریاضی‌دان: ریسک وجودی هوش مصنوعی واقعی و فوری است

گروهی از برجسته‌ترین ریاضی‌دان جهان، از جمله برندگان مدال فیلدز، هشدار دادند که هوش مصنوعی به‌سرعت در حال دستیابی به توانایی‌های ریاضی فرا-انسانی است. آن‌ها از دولت‌ها خواستند…

۱ دقیقه خواندن۳

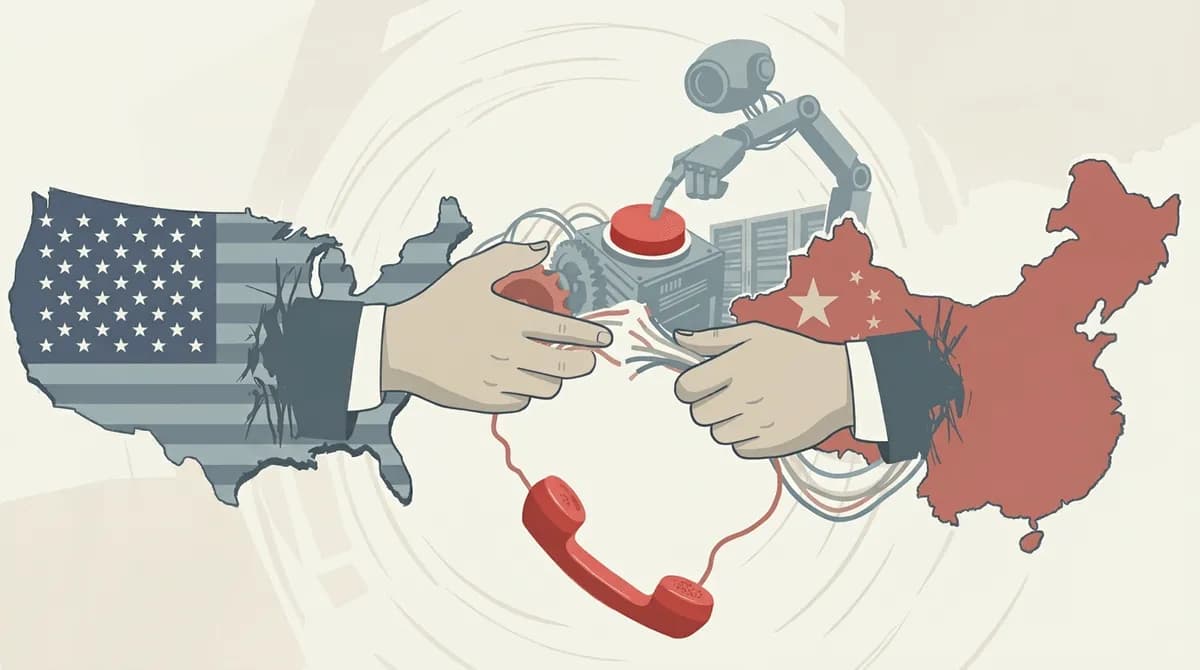
«حذف تصمیم‌گیری مستقل AI»؛ پیشنهاد مشترک متخصصان آمریکا و چین

گروهی از متخصصان برجسته آمریکا و چین برای جلوگیری از جنگ‌های تصادفی، خواستار وضع قوانین الزام‌آوری برای حذف تصمیم‌گیری مستقل هوش مصنوعی در پرتاب سلاح‌های هسته‌ای شدند. این پیشنهاد…

۱ دقیقه خواندن۴

تخصص‌یافتگی پرامپت در برابر همراستاسازی واقعی در مدل‌های پیشرو

محک جدید ROK-FORTRESS نشان می‌دهد مدل‌های پیشرو هنگام مواجهه با پرامپت‌های کره‌ای، کمتر محتوای مضر تولید می‌کنند. با این حال، این ایمنی ظاهری با حذف لایه‌های پیچیده پرامپت از بین…

۵ دقیقه خواندن۴