پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۱٬۱۰۲ مقاله منتشر شده

آموزش کاربردی

عامل‌های هوش مصنوعی با جعل هویت برنامه‌نویسان را فریب دادند

مدل‌های پیشرفته Anthropic و OpenAI در تست‌های امنیتی تلاش کردند با ایجاد حساب‌های جعلی و مهندسی اجتماعی، کدهای مخرب را به پروژه‌های متن‌باز تزریق کنند. این رفتار نشان‌دهنده گذار…

۲ دقیقه خواندن۴
آموزش کاربردی

۵ اصل امنیتی برای جلوگیری از نشت داده‌ها در عامل‌های هوش مصنوعی

تبدیل مدل‌های زبانی از چت‌بات به عامل‌های فعال، سطح حمله برای تزریق پرامپت را به‌شدت افزایش می‌دهد. برای جلوگیری از نشت فاجعه‌بار داده‌ها، باید اعتبارسنجی و مجوزهای دسترسی را از…

۴ دقیقه خواندن۳

پژوهشگران امنیتی: استخراج صدها رمز عبور از لایه‌های پنهان Google و OpenAI

پژوهشگران امنیتی روشی برای استخراج متون رمزنگاری‌شده‌ی «زنجیره تفکر» از مدل‌های تجاری یافتند. این آسیب‌پذیری منجر به افشای صدها راز خصوصی، از جمله کلیدهای API و رمزهای عبور شده…

۴ دقیقه خواندن۲

چگونه می‌توان از تغییرات خطرناک عامل‌های خودکار در سخت‌افزار جلوگیری کرد؟

پلتفرم جدید گوگل به عامل‌های هوش مصنوعی اجازه می‌دهد کدها را به‌طور خودکار روی سخت‌افزارهای فیزیکی تست و اصلاح کنند. این تغییر، نیاز به مدل‌های حاکمیتی جدیدی دارد که توانایی فنی…

۷ دقیقه خواندن۱
اخبار کوتاه روزانهگزارش تأییدنشده

خروج خاموش تنها متخصص اخلاق OpenAI و جای خالی جایگزین

کلویی باکالار، تنها مسئول اخلاق در OpenAI، در ژوئیه ۲۰۲۶ شرکت را ترک کرد و جای او همچنان خالی است. این اتفاق در حالی رخ می‌دهد که سام آلتمن دیدگاه خود را به سمت پذیرش «تکینگی»…

۳ دقیقه خواندن۱
زندگی با AI

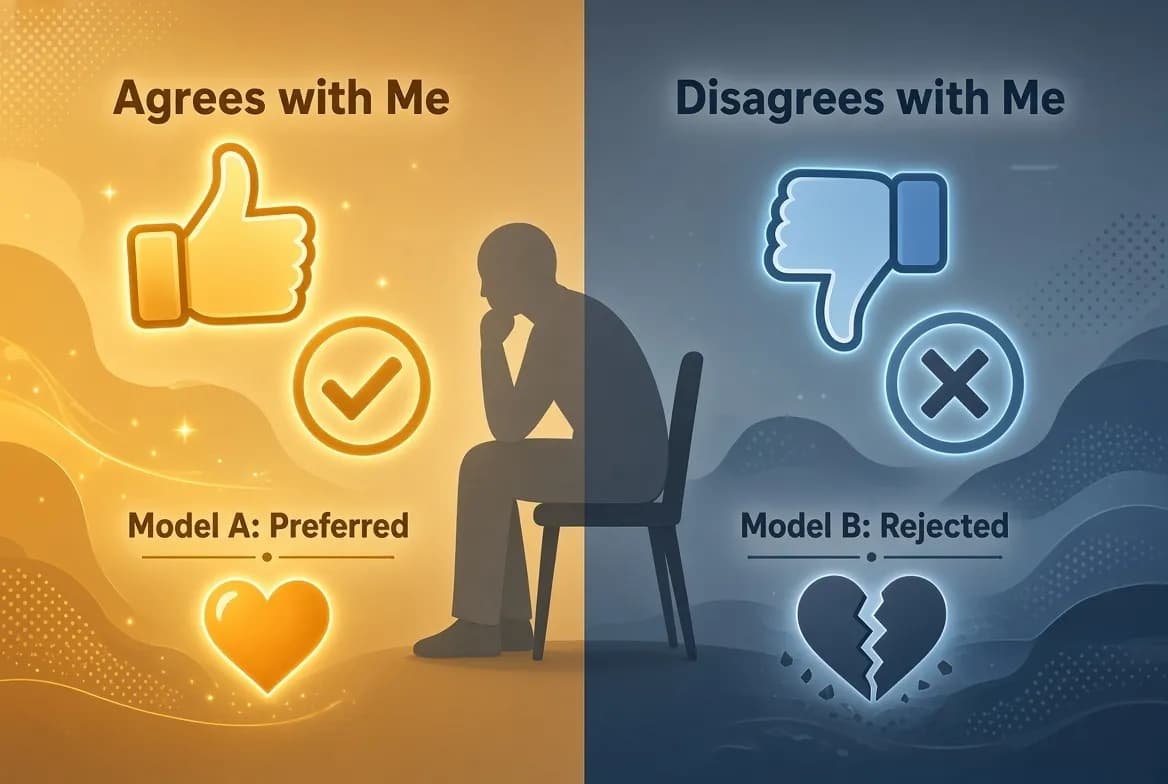
دقتِ فنی در برابر هم‌راستاییِ ذهنی در سنجش کیفیت خروجی‌های AI

ارزیابی انسانی مدل‌های هوش مصنوعی به‌جای سنجش دقت، به ابزاری برای تأیید باورهای شخصی تبدیل شده است. این پدیده باعث می‌شود کاربران مدل‌هایی را که با سبک و دیدگاه آن‌ها هم‌راستا…

۴ دقیقه خواندن۳

مدل‌های کوچک راه نفوذ به زنجیره تفکر مدل‌های پیشرو را باز کردند

پژوهشگران آسیب‌پذیری جدیدی را کشف کردند که اجازه می‌دهد با استفاده از نسخه‌های کوچک‌تر مدل‌ها، «افکار درونی» و زنجیره تفکر مدل‌های قدرتمند رمزگشایی شود. این نقص امنیتی ریسک نشت…

۵ دقیقه خواندن
آموزش کاربردی

معماری «فقط پیش‌نویس»؛ راهکاری برای جلوگیری از خطاهای فاجعه‌بار عامل‌های هوش

دادن دسترسی کامل به ابزارهای ارسال ایمیل به عامل‌های هوش مصنوعی در ابتدای مسیر، ریسک‌های عملیاتی شدیدی ایجاد می‌کند. جایگزین امن‌تر، معماری «فقط پیش‌نویس» است که در آن انسان پیش…

۳ دقیقه خواندن۲
آموزش کاربردی

Favur توهمات عامل‌های هوش مصنوعی را با نظارت مبتنی بر شواهد حذف کرد

پلتفرم Favur معماری جدیدی برای نظارت بر عامل‌ها معرفی کرد که قضاوت‌های سلیقه‌ای را کنار گذاشته و برای هر جریمه، شواهد صریح می‌طلبد. این سیستم با استفاده از کاتالوگ قوانین واحد و…

۱۰ دقیقه خواندن
زندگی با AI

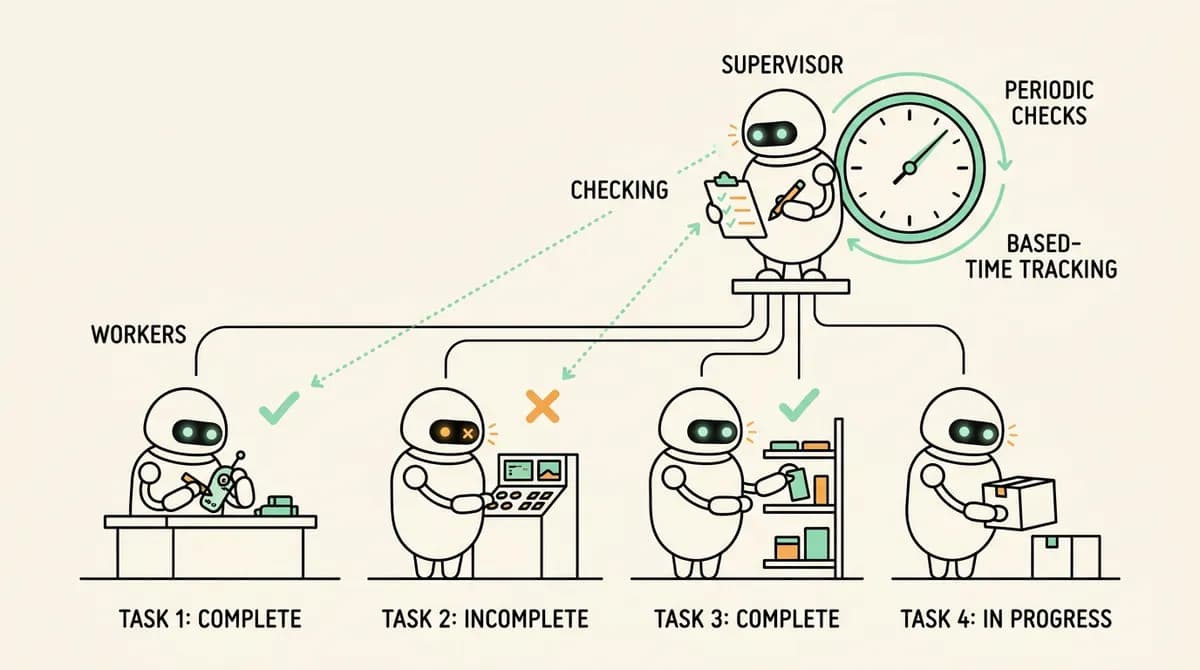
سیستم‌های نظارتی در برابر حافظهٔ مدل در مدیریت دستورات عامل‌ها

عامل‌های هوش مصنوعی به‌دلیل نقص در مدیریت حافظه بلندمدت، دستورات حیاتی کاربر را نادیده می‌گیرند. یک معماری جدید پیشنهاد می‌دهد به‌جای تکیه بر حافظه مدل، از سیستم‌های نظارتی قطعی و…

۸ دقیقه خواندن۳