TencentDB: همگامسازی تجربه تیمی در بستر DeepSeek Harness
تیم پایگاهداده تنسنت با ادغام حافظه عامل در کلاینت DSH، امکان اشتراکگذاری بستر پروژه و محدودیتهای کسبوکار بین عاملهای مختلف را فراهم کرد. این اقدام مانع از تکرار فرآیند…
۵ دقیقه خواندن۲
موضوع
۵٬۱۸۵ مقاله منتشر شده
تیم پایگاهداده تنسنت با ادغام حافظه عامل در کلاینت DSH، امکان اشتراکگذاری بستر پروژه و محدودیتهای کسبوکار بین عاملهای مختلف را فراهم کرد. این اقدام مانع از تکرار فرآیند…
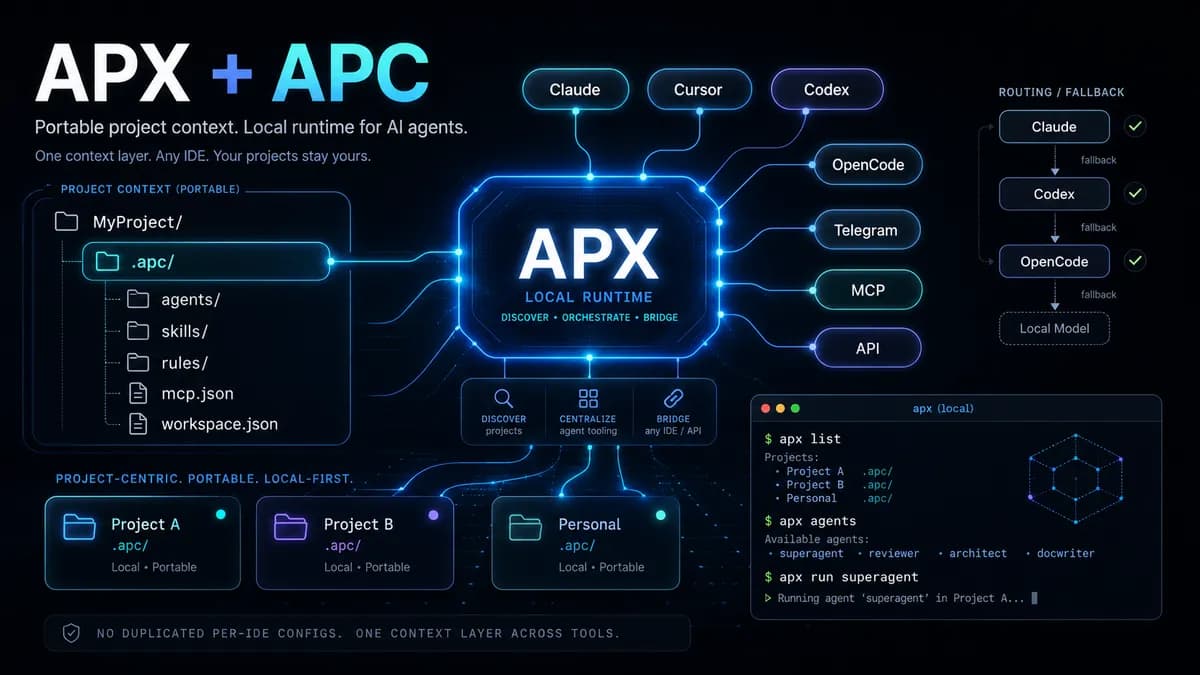
رانتایم APX با ایجاد تمایز بین قالبهای مشترک و تعاریف مالکیت پروژه، امکان نسخهبندی و بازرسی رفتار عاملها را فراهم کرد. این رویکرد اجازه میدهد رفتار هوش مصنوعی به جای تنظیمات…
یک دستورالعمل مهندسی جدید نشان میدهد چگونه میتوان از جهش هزینههای API در ابزارهای کدنویسی جلوگیری کرد. با پیادهسازی هرس زمینه، سلسلهمراتبی مدلها و حافظه معنایی،…
بیشتر شکستهای عاملهای هوش مصنوعی ناشی از طراحی ضعیف ابزارها و نبود کنترل هزینه است، نه خطاهای استدلالی مدل. ساخت عاملهای پایدار نیازمند محدودیتهای سختگیرانه در تکرار، مرزهای…
ابزار جدیدی به نام Codyssey با گیمیفیکیشن (Gamification) تجربه کدنویسی با هوش مصنوعی، محیط خشک ترمینال را به یک ماجراجویی فانتزی تبدیل میکند. این پلاگین با افزودن موسیقی زاینده و…
شبکههای عصبی عمیق هنگام رشد با مشکل محوشدن یا انفجار گرادیان مواجه میشوند. نرمالسازی لایهای و اتصالات باقیمانده با تثبیت جریان داده و ایجاد مسیرهای میانبر، امکان آموزش…
یک ابزار متنباز جدید با نقشهبرداری از گراف لینکهای داخلی، مشکل «صفحات یتیم» در سایتهای تولیدشده توسط هوش مصنوعی را حل میکند. این ابزار به توسعهدهگران اجازه میدهد صفحات…
تیمی از تولیدکنندگان محتوا متوجه شدند که در Vast.ai، توقف (Stop) یک نمونه، هزینههای مربوط به دیسک را متوقف نمیکند. آنها اکنون برای جلوگیری از ضررهای مالی، گردشکار…
پروژه متنباز Laya با ارائه یک موتور تصمیمگیر غیرخودبازگشتی، امکان استنتاج محلی و سریع را بدون نیاز به پرداخت هزینههای API فراهم میکند. این ابزار با تمرکز بر حریم خصوصی،…
اوپنایآی رابط برنامهنویسی Decisions را برای طبقهبندی و امتیازدهی سریع معرفی کرد. این ابزار که توسط مدل gpt-6-luna پشتیبانی میشود، پاسخهای مبتنی بر احتمال را با سرعتی ۱۰…
تکنیک جدید DFlash-2 با استفاده از یک مدل پیشنویس مبتنی بر انتشار، سرعت تولید توکن در مدلهای زبانی را بهویژه در کارهای کدنویسی بهشدت بالا میبرد. آزمایشها روی مدل Muse Glimmer…
ابزار متنباز OpenPilot به توسعهدهندگان اجازه میدهد بدون وابستگی به IDEهای ابری، گردشکارهای کدنویسی عاملمحور را با هر مدل محلی یا API سازگار با OpenAI اجرا کنند. این برنامه…