پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۶۶۴ مقاله منتشر شده

Tenstorrent هزینه استنتاج صوتی را ۴ برابر کمتر از GPUهای انویدیا کرد

شرکت Tenstorrent و Smallest.ai یک پشتهٔ سخت‌افزاری-نرم‌افزاری برای اجرای مدل‌های تبدیل متن به گفتار در محیط‌های درون‌سازمانی معرفی کردند. این راهکار ادعا می‌کند بدون کاهش کیفیت…

۵ دقیقه خواندن۳

نسخه ۲.۵ LlamaIndex استخراج داده‌های پیچیده را ارزان‌تر و دقیق‌تر کرد

آپدیت جدید LlamaIndex با معرفی «استدلال ساختاری»، دقت استخراج داده از اسناد سازمانی را بدون افزایش هزینه افزایش داده است. این نسخه اکنون در لایه‌ی اقتصادی، عملکرد لایه‌های…

۵ دقیقه خواندن۱

۸۳٪ از کاربران با آواتارهای تعاملی Synthesia نمرات آموزشی خود را بهبود دادند

شرکت Synthesia پلتفرم Sessions را برای ایجاد گفتگوهای دوطرفه و بلادرنگ با آواتارهای هوش مصنوعی معرفی کرد. این سیستم آموزش‌های سازمانی را از ویدیوهای ایستا به نقش‌آفرینی‌های تعاملی…

۵ دقیقه خواندن۲

آیا تحلیل اسکن‌های مغزی می‌تواند تصاویر دیده‌شده توسط انسان را بازسازی کند؟

پژوهشگران مؤسسه وایزمن ابزاری ساخته‌اند که با تحلیل اسکن‌های fMRI، تصاویری را که فرد می‌بیند بازسازی می‌کند. این سیستم زمان کالیبراسیون برای کاربران جدید را به‌شدت کاهش داده و راه…

۷ دقیقه خواندن۲
آموزش کاربردی

ابزار جدید Apify فرآیند زیرنویس چندزبانه پادکست‌ها را به یک مرحله رساند

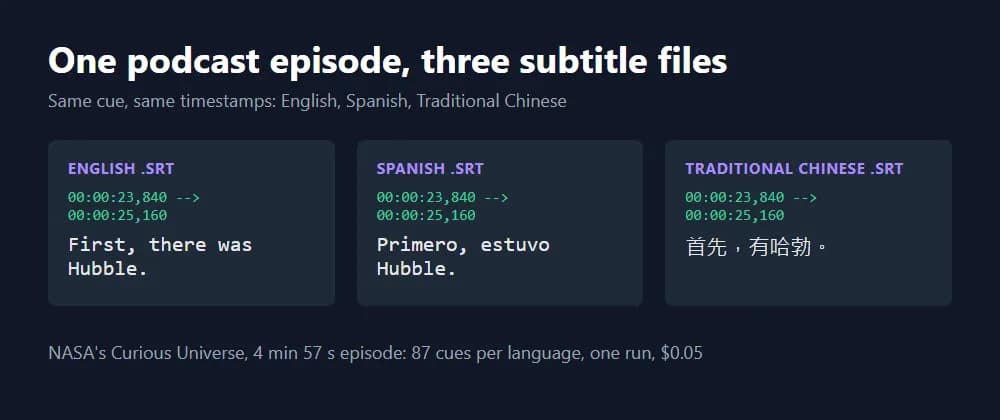
یک ابزار جدید در پلتفرم Apify کل زنجیره تولید زیرنویس، از دریافت RSS پادکست تا تولید فایل‌های SRT چندزبانه را خودکار می‌کند. این سیستم با ادغام لایه ترجمه در زمان بازشناسی گفتار،…

۵ دقیقه خواندن۲
آموزش کاربردی

«جایگزینی ویدیو با ماشین حالت»؛ کلیدِ تعاملِ بصری در ربات‌های AI

پرانیث کاویا تاتسارا با استفاده از ابزار Rive، سیستم‌های انیمیشنی پویا را برای ربات‌های همراه AI طراحی کرده است. این متد با جایگزینی ویدیوهای ثابت با ماشین‌های حالت، اجازه می‌دهد…

۸ دقیقه خواندن۱