پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۶۶۴ مقاله منتشر شده

مدل MAI-Transcribe-2 چگونه پاسخ‌دهی بلادرنگ هوش مصنوعی را ممکن می‌کند؟

مایکروسافت مجموعه‌ای از مدل‌های صوتی بلادرنگ را برای حذف تأخیر در هوش مصنوعی صوتی عرضه کرد. مدل جدید MAI-Transcribe-2-Streaming به عامل‌های هوشمند اجازه می‌دهد هم‌زمان با صحبت…

۴ دقیقه خواندن۲
آموزش کاربردی

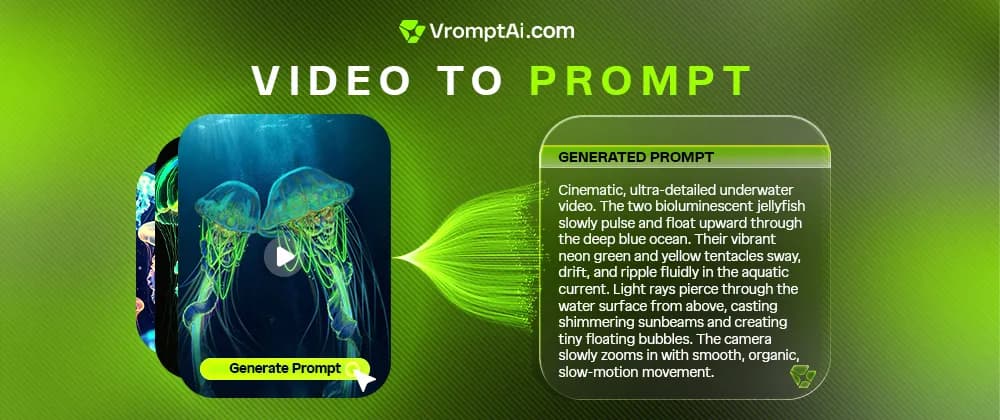
معماری دو لایهٔ پرامپت هزینهٔ پردازشی ویدیوهای هوش مصنوعی را کاهش داد

یک چارچوب جدید برای مهندسی معکوس ویدیو، تولید لوپ‌های سینمایی پیش‌بینی‌پذیر را بدون نیاز به آزمون و خطاهای هزینه‌بر ممکن می‌کند. این روش با تفکیک پرامپت‌ها به دو بخش «گراف صحنه» و…

۳ دقیقه خواندن
آموزش کاربردی

«پر کردن شکاف OCR»؛ دستاورد جدید در استخراج داده‌های محلی

یک مدل تنظیم‌شده‌ی LayoutLM اکنون استخراج داده‌های ساختاریافته از PDFهای مالایالام، هندی و انگلیسی را با دقت بالا و به‌صورت محلی ممکن می‌کند. این دستاورد شکاف موجود در نویسه‌خوانی…

۱۰ دقیقه خواندن۱
آموزش کاربردی

۴ معیار حیاتی برای انتخاب میان APIهای رایگان و پولی تبدیل متن به گفتار

توسعه‌دهندگانی که از نسخه‌های رایگان TTS به مدل‌های پولی مهاجرت می‌کنند، باید تأخیر، شبیه‌سازی صدا و مجوزهای تجاری را بر هزینه اولویت دهند. مدل‌های عصبی برای عبور از سقف کیفیت…

۵ دقیقه خواندن

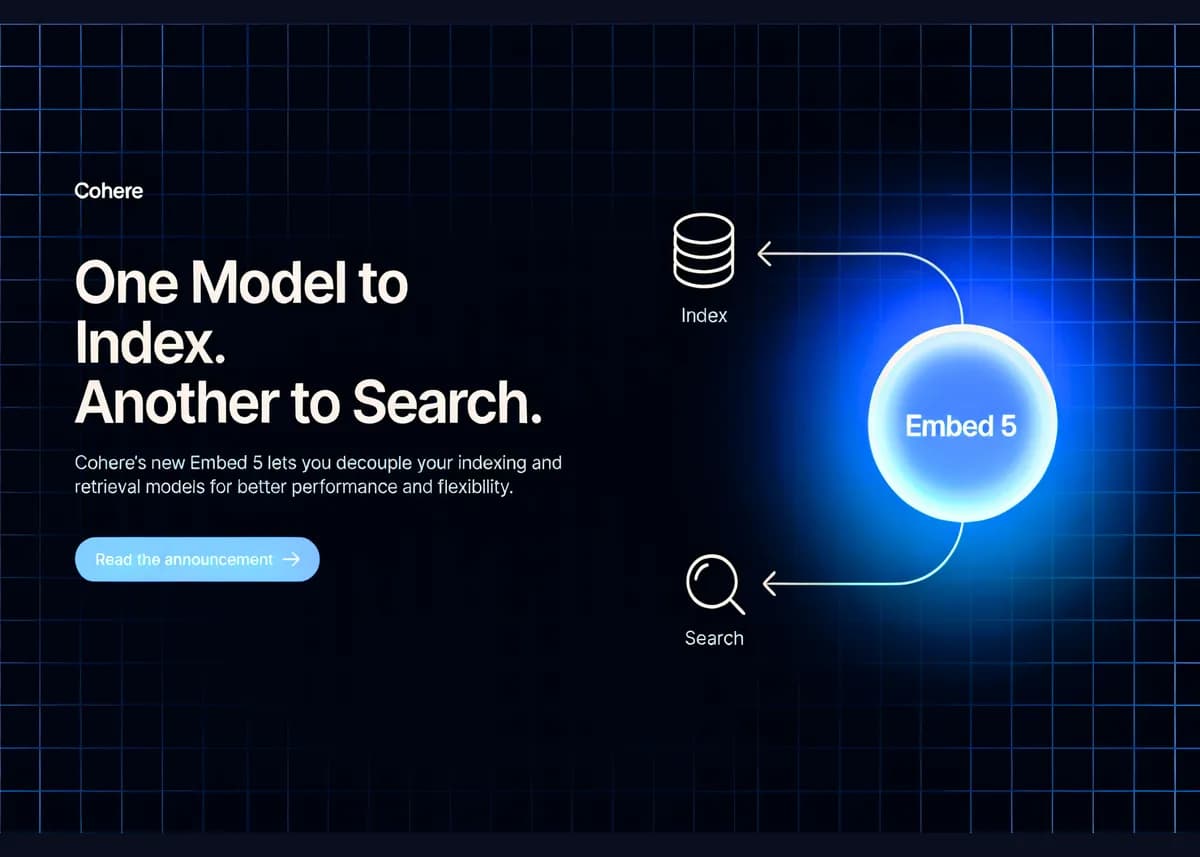
مدل Fast کوهیر چگونه تأخیر در عامل‌های هوش مصنوعی را کاهش می‌دهد؟

شرکت کوهیر خانواده مدل‌های بردار معنایی Embed 5 را با دو سطح Pro و Fast معرفی کرد که از یک فضای برداری مشترک استفاده می‌کنند. مدل Pro در بازیابی داده‌های مالی رکورد جدیدی ثبت کرده…

۶ دقیقه خواندن۱