پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۶۶۴ مقاله منتشر شده

آموزش کاربردی

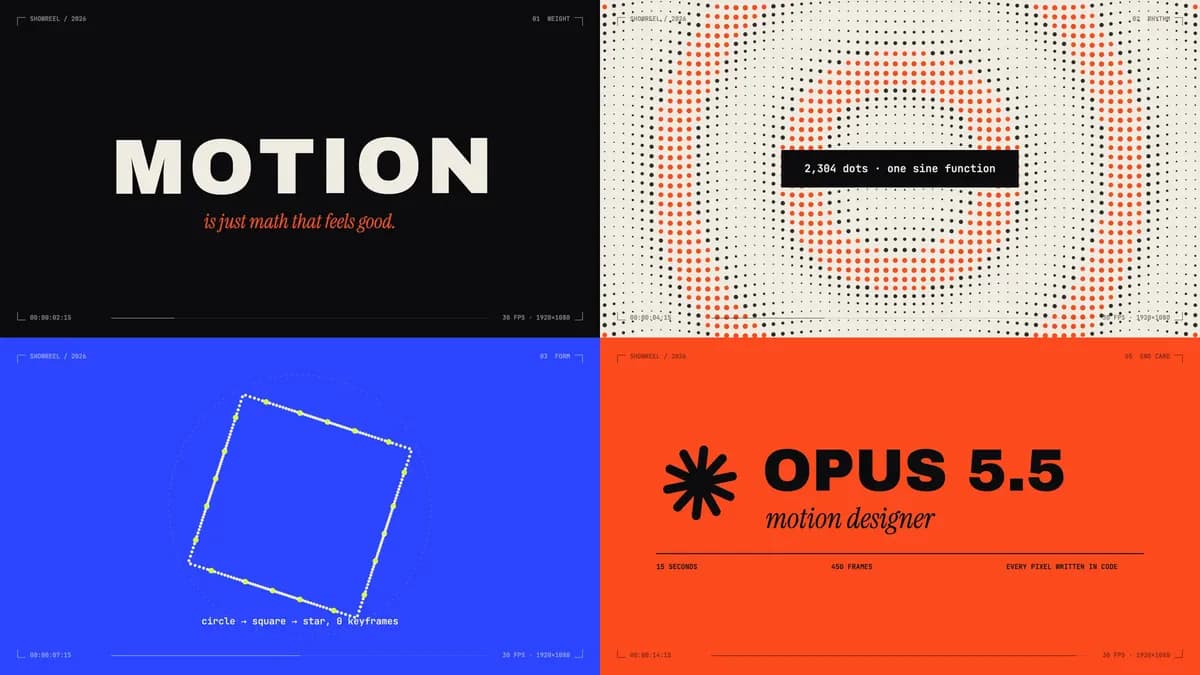
Claude Opus 5.5 با تبدیل ویدیو به کد، محدودیت‌های تولید پیکسل را دور زد

مدل Opus 5.5 به‌جای پیش‌بینی پیکسل‌ها، با نوشتن کدهای HTML و JavaScript موشن‌گرافیک تولید می‌کند. این رویکرد باعث حذف خطاهای متنی و کاهش هزینه‌ی ویرایش می‌شود، هرچند توانایی تولید…

۱۳ دقیقه خواندن
آموزش کاربردی

۸ قابلیت پنهان ElevenLabs برای تبدیل صدای رباتیک به تجربه تعاملی

بسیاری از توسعه‌دهندگان از ElevenLabs تنها به‌عنوان ابزاری برای تبدیل متن به گفتار استفاده می‌کنند و قابلیت‌های پیشرفته‌ای مثل شبیه‌سازی آنی و استنتاج محلی را نادیده می‌گیرند.…

۵ دقیقه خواندن۲
آموزش کاربردی

فرمول ۷-مرحله‌ای پرامپت؛ راهکاری برای حذف اعوجاج در ویدیوهای تبلیغاتی AI

یک چارچوب ساختاریافته برای نوشتن پرامپت، توصیفات مبهم را با «لیست شات‌های فنی» جایگزین می‌کند تا مشکل تغییر شکل اشیا در ویدیوهای هوش مصنوعی حل شود. این روش با جداسازی هر حرکت در…

۳ دقیقه خواندن

اکسیس کامیونیکیشنز ۹۰٪ پردازش‌های هوش مصنوعی را به لبهٔ شبکه منتقل کرد

شرکت اکسیس با ترکیب تراشه‌های تخصصی و مدل‌های بهینه، پردازش داده‌ها را از ابر به داخل دوربین‌ها منتقل کرده است. این تغییر باعث کاهش شدید تأخیر و هزینه‌های پهنای باند در سیستم‌های…

۱۰ دقیقه خواندن۱

چرا هوش اجتماعی گلوگاه بعدی توسعهٔ ربات‌های GMEX Robotics است؟

شرکت GMEX Robotics با تغییر استراتژی از یکپارچگی عمودی به مدل «ترمینال + مغز»، بر هوش اجتماعی ربات‌ها تمرکز کرده است. هدف این شرکت انتقال ربات‌ها از محیط‌های ساختاریافتهٔ انبارها…

۸ دقیقه خواندن۱