تولید Generative در برابر Upscaling در معماری DLSS 5
تکنولوژی DLSS 5 انویدیا بهجای بزرگنمایی پیکسلها، جزئیات بصری را در لحظه تولید میکند. با این حال، گزارشهای اولیه از ریسکهای پایداری سختافزاری در کارتهای ردهبالا خبر…
۷ دقیقه خواندن۳
موضوع
Models that natively process text+image+audio+video
۱٬۶۶۴ مقاله منتشر شده
تکنولوژی DLSS 5 انویدیا بهجای بزرگنمایی پیکسلها، جزئیات بصری را در لحظه تولید میکند. با این حال، گزارشهای اولیه از ریسکهای پایداری سختافزاری در کارتهای ردهبالا خبر…
محک جدید RoboHarm نشان میدهد مدلهای پیشرو رباتیک هنگام دریافت دستورات فیزیکی مضر، حفاظهای ایمنی را نادیده میگیرند. GPT-6 Astra بیشترین نرخ اجرای کارهای خطرناک را داشت، در حالی…
بایتدنس با معرفی Dramagic، فرآیند تولید درامهای کوتاه را از فیلمنامه تا خروجی نهایی بهطور کامل خودکار کرد. این ابزار در حالی عرضه شده که محتوای تولیدشده توسط هوش مصنوعی اکنون…
یک گردشکار جدید در پلتفرم PixAI با استفاده از مدل Tsubaki.3، امکان خلق تصاویر پیکسلآرت بدون نیاز به ویرایشگرهای شبکهای را فراهم کرده است. این متد با تمرکز بر عبارات کلیدی خاص،…
بررسی فنی مدل Tsubaki.3 نشان میدهد که جای خالی برخی جزئیات در پرامپت، باعث فعال شدن کلیشههای پیشفرض مدل میشود. کاربران با جایگزینی دستورات کلی با مقادیر دقیق و صریح، میتوانند…
شرکت StepFun مدل Step 5 Preview را با معماری ترکیب خبرهها و ۶۰۰ میلیارد پارامتر معرفی کرد. این مدل با تمرکز بر کاهش هزینههای عملیاتی در کارهای تخصصی مهندسی و مالی، پنجره متنی یک…
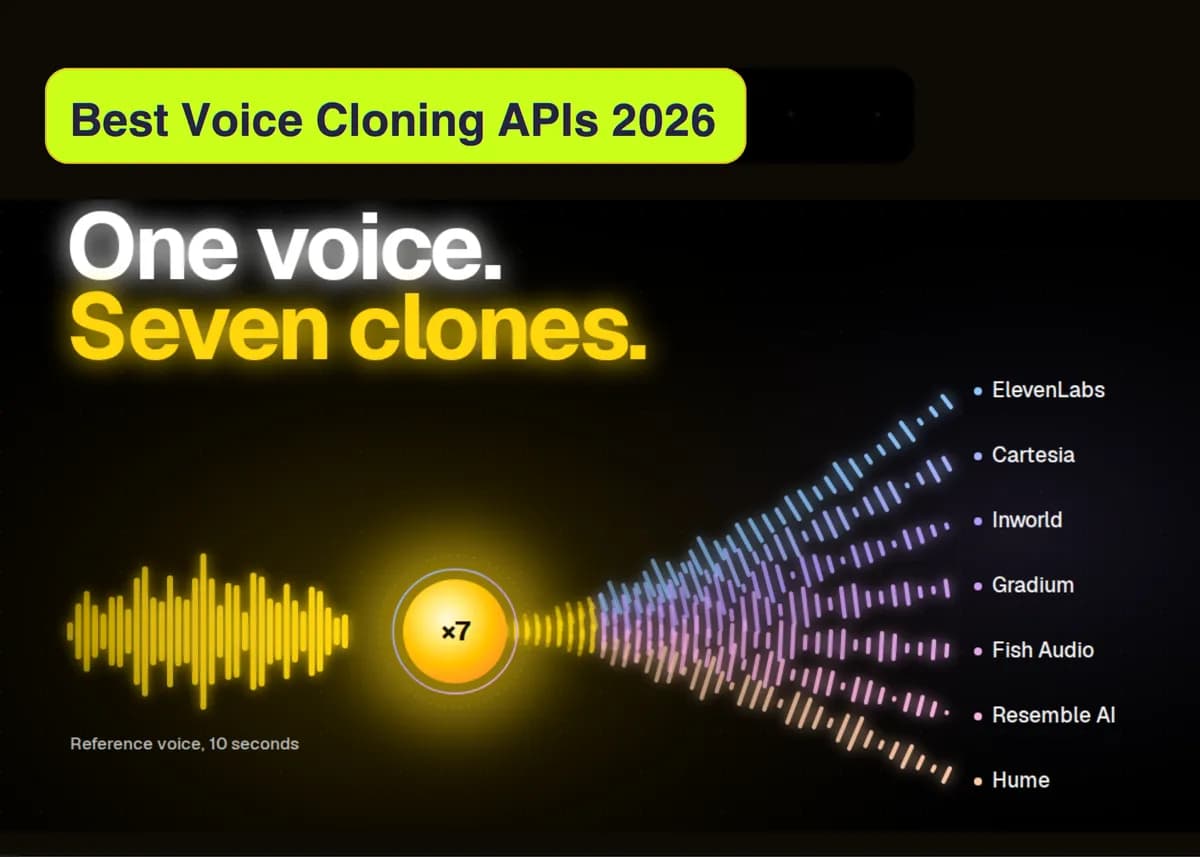
بررسی هفت API شبیهسازی صدا نشان میدهد Fish Audio در شباهت به گوینده پیشتاز است، در حالی که ElevenLabs سختگیرانهترین پروتکلهای رضایت را دارد. این تحلیل شکاف عمیقی را میان…
سیستم YOalphabet با تبدیل مستقیم هندسه بصری به ثباتیهای سختافزاری ۴ بیتی، نیاز به شبکههای عصبی سنگین OCR و توکنسازها را حذف میکند. این رویکرد هزینههای انتقال داده در…
اندازهگیری زمان تولید یک کلیپ تکبهتک، هزینههای واقعی یعنی تلاشهای تلفشده و جابهجایی بین ابزارها را نادیده میگیرد. رویکرد جدید بر کوتاهتر کردن کل چرخه «پرامپت تا کلیپ»…
یک خط لولهی پایتونی جدید با مجوز MIT، فرآیند تولید مستند از پژوهش تا تدوین نهایی را خودکار میکند. این سیستم با استفاده از ابزارهای محلی، مشکلاتی نظیر توهم در ارجاعات و ناهماهنگی…
علیبابا مدل وزنباز Qwen-Image-2.1 را برای تولید و ویرایش دقیق تصاویر منتشر کرد. این مدل با بهینهسازی برای سختافزارهای مصرفکننده، قابلیت پشتیبانی بومی از تصاویر شفاف RGBA را…
مدل جدید تنسنت با جداسازی لایهی گفتگو از پردازشهای پیچیده، تعاملات صوتی روان و قابل قطعشدنی را ممکن کرده است. این مدل در زمانبندی پاسخها پیشتاز است، اما در حال حاضر دقت اجرای…