پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۴۲۵ مقاله منتشر شده

مقایسه دو روش هوش مصنوعی: تبدیل متن به میم در برابر تبدیل تصویر به میم

متن در برابر تصویر؛ دو مسیر متفاوتی برای تولید میم‌های ویروسی

تولیدکنندگان محتوای ویروسی اکنون بین دو مسیر «متن به میم» برای ایده‌های نو و «تصویر به میم» برای شخصی‌سازی بصری انتخاب می‌کنند. این تفکیک، نقش سازنده را از یک ویرایشگر دستی به یک…

۴ دقیقه خواندن۱
انتشار Audex توسط انویدیا: مدل زبانی یکپارچه صدا-متن با حفظ هوشمتدی متنی مدل پایه

مدل Audex انویدیا دلیل افت استدلال متنی در سیستم‌های چندوجهی را حل کرد

انویدیا مدل Audex را معرفی کرد؛ یک مدل ۳۰ میلیارد پارامتری که بدون کاهش توان استدلالی، صوت و متن را پردازش می‌کند. این مدل یکی از معدود مدل‌های وزن‌باز است که می‌تواند صداهای…

۵ دقیقه خواندن۲
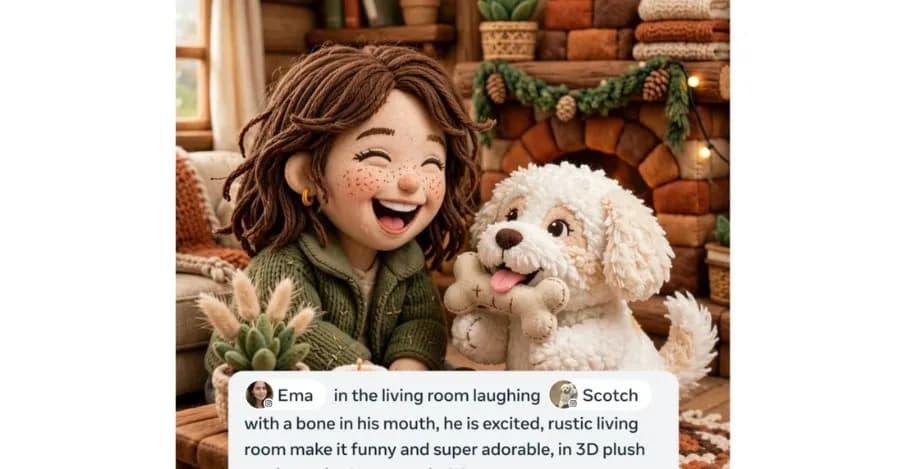
مدل تصویرسازی Muse متا می‌تواند کاربران دیگر اینستاگرام را در عکس‌های هوش مصنوعی جای دهد.

«ادغام هویت کاربران»؛ قابلیت جدید Meta برای شخصی‌سازی عکس‌های تولیدی

متا مدل Muse Image را برای ادغام شباهت ظاهری کاربران تگ‌شده در اینستاگرام در عکس‌های تولیدی هوش مصنوعی عرضه کرد. این مدل عامل‌محور جایگزین Llama در ابزارهای تصویری متا شده و…

۲ دقیقه خواندن۱
ویرایشگر ویدیوی داخلی به اپ X برای iOS اضافه شد

X با ابزار تدوین ویدیو در iOS به جنگ بازنشرهای تیک‌تاک آمد

پلتفرم X برای کاهش نرخ بازنشر کلیپ‌ها و تشویق تولید محتوای اصیل، ویرایشگر و ضبط‌کننده داخلی ویدیو را برای iOS عرضه کرد. این اقدام علاوه بر رقابت با تیک‌تاک، هدف تامین داده‌های…

۲ دقیقه خواندن۱
ادغام مدل زبانی بزرگ با وظایف بینایی ماشین
آموزش کاربردی

Oxlo.ai هزینهٔ عامل‌های چندوجهی را با مدل قیمت‌گذاری درخواستی کاهش داد

ترکیب مدل‌های زبانی با بینایی ماشین باعث انفجار توکن‌ها و افزایش هزینه‌ها می‌شود. Oxlo.ai با جایگزینی پرداخت توکنی با یک مدل قیمت‌گذاری ثابت برای هر درخواست، این چالش عملیاتی را…

۴ دقیقه خواندن۱