پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۱٬۷۸۸ مقاله منتشر شده

نمودار: نحوه کار مکانیزم ابزار در Claude Code - تعامل بین هوش مصنوعی، ابزارها و محیط اجرا
آموزش کاربردی

مکانیزم چهارلایه‌ی Claude Code برای تبدیل توهمات AI به دستورات قابل‌اجرا

کلاود کد (Claude Code) با جایگزینی پرامپت‌های آزاد با یک سیستم ساختاریافته از چهار لایه ابزاری، خروجی‌های غیرقابل‌پیش‌بینی مدل‌های زبانی را به اقدامات قابل‌اعتماد تبدیل می‌کند.…

۷ دقیقه خواندن۱
گزارش‌ها خط‌لوله‌اند، نه صحنه: یک ظرف جریان مرکب در عمل
آموزش کاربردی

تغییر ساختار پردازش: افزایش پایداری خروجی‌های پیچیده از ۶۰٪ به ۹۵٪

تغییر معماری از عامل‌های تک‌صحنه‌ای به کانتینر خط لوله پنج‌مرحله‌ای، مشکل ناپایداری در تولید گزارش‌های پیچیده را حل کرد. با سپردن پردازش داده به اسکریپت‌های قطعی و استفاده از مدل…

۶ دقیقه خواندن۱
مقایسه عملکرد و هزینه مدل‌های GPT-5.6 Sol و Fable 5 در بنچمارک‌های ترکیبی

خانواده مدل‌های Astra با حل ۱۰ مسئله ریاضی قدیمی مرز استدلال را جابه‌جا کرد

مدل‌های جدید OpenAI با نام Astra توانستند ۱۰ مسئله پیچیده ریاضی و علوم کامپیوتر را که بیش از یک دهه حل‌نشده مانده بودند، گره‌گشایی کنند. این دستاورد نشان‌دهنده تغییر استراتژی…

۵ دقیقه خواندن۴
مقایسه هوش مصنوعی: تفاوت LLM و یادگیری عمیق
آموزش کاربردی

مدل‌های زبانی در برابر یادگیری عمیق؛ تحلیل مرز استدلال و بازنمایی

یک راهنمای عملی جدید نشان می‌دهد که مدل‌های زبانی بزرگ، زیرمجموعه‌ای تخصصی از یادگیری عمیق هستند و نه جایگزینی برای آن. توسعه‌دهندگان می‌توانند با جداسازی مدل‌های بردارساز و مولد،…

۴ دقیقه خواندن
مقایسه معنای تکمیل و حفظ زمینه: تفاوت طراحی بین AGE Plan و برنامه‌ریزی با فایل‌ها
آموزش کاربردی

AGE Plan با مکانیزم «دروازه‌های بستار» جلوی توهم عامل‌های کدنویس را می‌گیرد

مقایسه‌ای میان AGE Plan و PwF نشان می‌دهد که در حالی که دومی بر حفظ حافظه تمرکز دارد، اولی با معرفی «دروازه‌های بستار» مانع از ادعاهای دروغین عامل‌ها درباره تکمیل وظایف می‌شود.…

۱۴ دقیقه خواندن۳
نمونه‌برداری بوت‌استرپ در خط لوله RAG: بررسی عمیق مشکل انتخاب تصادفی اسناد
آموزش کاربردی

پژوهش‌های RAG: اتصال به دانش خارجی ریسک خطای LLM را پایین می‌آورد

خط لوله‌های RAG با ترکیب بازیابی داده‌های خارجی و تولید متن، پاسخ‌های مدل‌های زبانی را به واقعیت‌های قابل راستی‌آزمایی گره می‌زنند. این سازوکار ریسک توهم مدل را کاهش داده و دسترسی…

۷ دقیقه خواندن۲
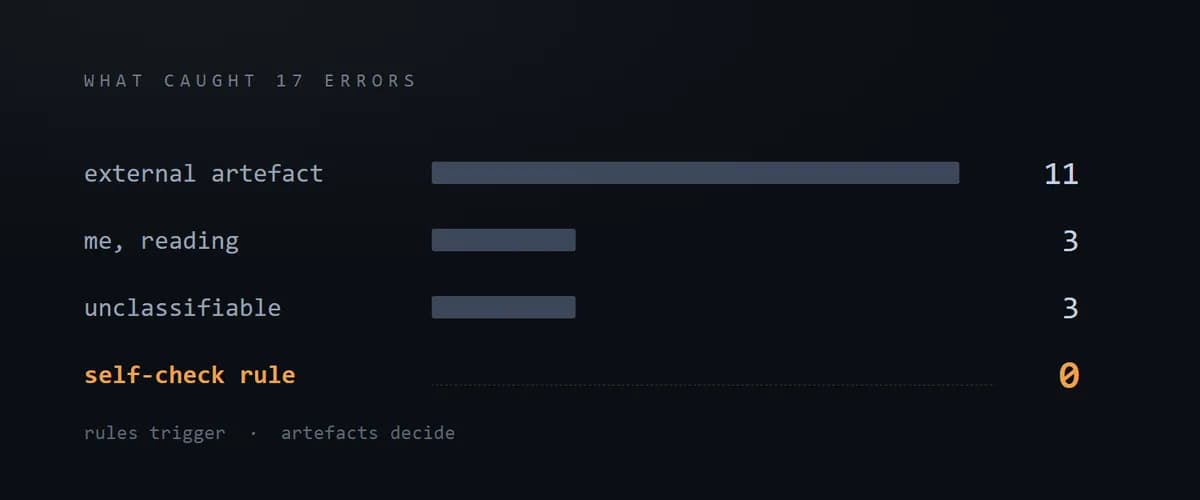
قوانین محرک‌اند، مصنوعات تصمیم‌می‌گیرند: آنچه در ۱۷ خطای عامل اندازه‌گرفتم
آموزش کاربردی

قواعد خودارزیابی در عامل‌های هوش مصنوعی هرگز خطاهای تثبیت‌شده را شکار نمی‌کنند

تحلیل ۱۷ خطای عامل‌محور نشان می‌دهد قواعد داخلی برای اندازه‌گیری مفیدند اما هرگز نمی‌توانند داور نهایی باشند. برای دستیابی به قابلیت اطمینان، توسعه‌دهندگان باید به‌جای تکیه بر…

۷ دقیقه خواندن
معیار ORCA: آمادگی عوامل زبانی برای پاسخگویی به حوادث عملیاتی چقدر است؟

عامل‌های هوش مصنوعی در ۷۵٪ سناریوهای عملیاتی SRE شکست می‌خورند

محک جدید ORCA-bench نشان می‌دهد که پیشرفته‌ترین عامل‌های کدنویسی در تحلیل ریشه‌ای حوادث تولید (Production) ناتوان‌اند. این یافته‌ها شکاف عمیقی را میان قدرت کدنویسی مدل‌ها و…

۲ دقیقه خواندن۲