پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۲٬۰۴۹ مقاله منتشر شده

آموزش کاربردی

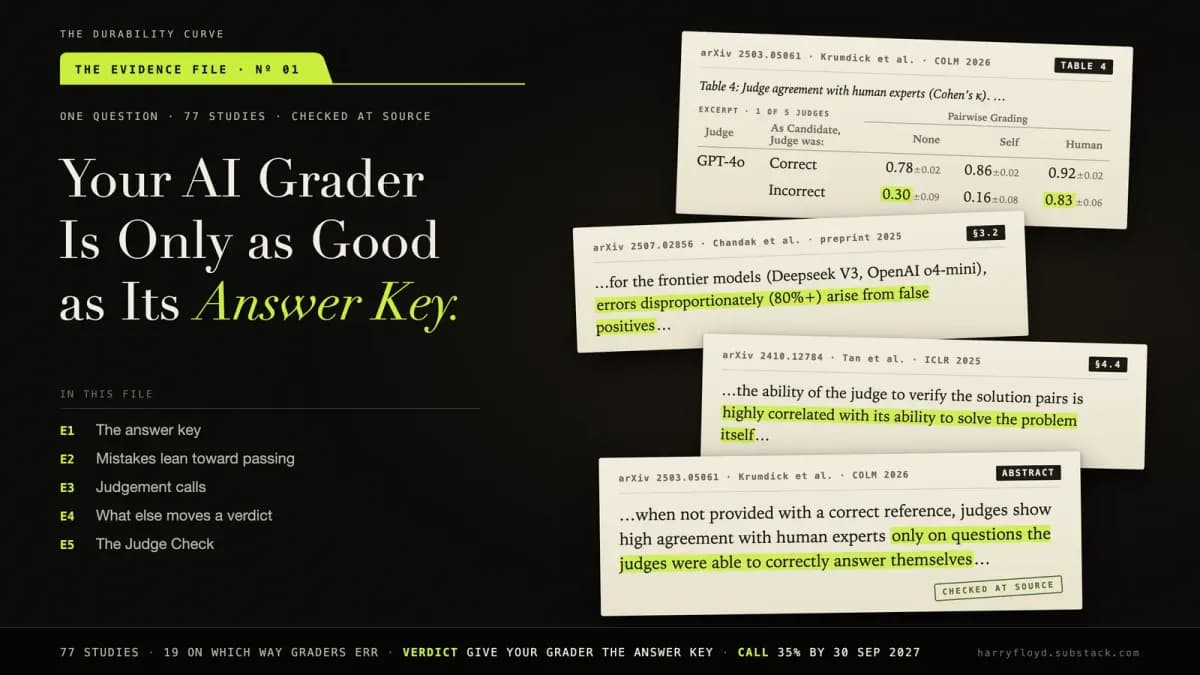
داوران هوش مصنوعی ۸۰٪ سوالات دشوار را بدون کلید پاسخ اشتباه می‌سنجند

تحلیل ۷۷ مطالعه نشان می‌دهد مدل‌های پیشرو در تصحیح پاسخ‌های تشریحی، بدون داشتن کلید پاسخ معتبر، تمایل شدیدی به «قبول کردن» پاسخ‌های غلط دارند. اعتبار این داوران دقیقاً در لحظه‌ای…

۱۳ دقیقه خواندن
آموزش کاربردی

تحلیل ساختار LLM: ترجیح نمایش‌های عددی فشرده بر متن‌های وب

مدل‌های زبانی بزرگ برخلاف انسان‌ها، وب را نمی‌خوانند، بلکه بر اساس نمایش‌های عددی فشرده عمل می‌کنند که ثبات را به خلاقیت ترجیح می‌دهد. برای دیده شدن در جست‌وجوی AI، محتوا باید…

۵ دقیقه خواندن

«تعریف واقعیت»؛ مانع اصلی در استخراج داده با رای‌گیری مدل‌ها

یک توسعه‌دهنده با استفاده از پنلی متشکل از سه مدل مختلف سعی کرد دقت استخراج واقعیت‌ها را در یک پروژه بازی افزایش دهد. نتایج نشان داد چالش اصلی نه کیفیت مدل‌ها، بلکه دشواری تعریف…

۷ دقیقه خواندن
آموزش کاربردی

LexAegis با ترکیب Qwen و Monad ردپای تصمیمات انسانی در حقوق را مستند کرد

پروژه LexAegis با جداسازی تحلیل هوش مصنوعی از تصمیم‌گیری انسانی و ثبت تاییدیه نهایی روی بلاک‌چین Monad، سیستمی برای کاهش توهمات در پرونده‌های حقوقی ساخته است. در این معماری، مدل…

۷ دقیقه خواندن

«بدون نیاز به نمایش انسانی»؛ قابلیت جدید AlphaNIST در مونتاژ دقیق

پژوهشگران با توسعه AlphaNIST سیستمی را ساختند که بدون نیاز به نمایش‌های انسانی، ۲۰ تسک پیچیده مونتاژ را یاد می‌گیرد. این مدل با استفاده از پاداش‌های صفر و یک و شبیه‌سازی‌های…

۲ دقیقه خواندن
آموزش کاربردی

چرا عامل‌های تطبیقی MissionFlows جایگزین جریان‌های کاری ایستا می‌شوند؟

معماری جدید MissionFlows مسیرهای اجرای پیش‌فرض در سیستم‌های خودکار را حذف کرده و تصمیم‌گیری را به عامل‌های هوش مصنوعی در لحظه اجرا می‌سپارد. این رویکرد پیش‌بینی‌پذیری مطلق را فدای…

۸ دقیقه خواندن