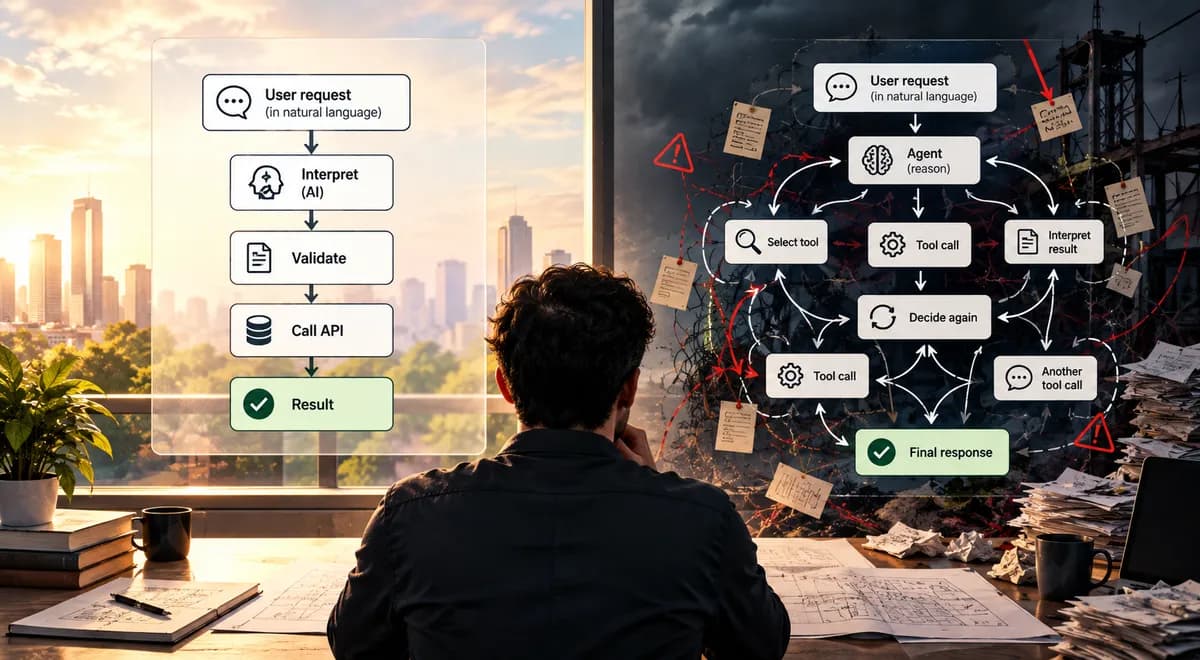
مالیات استقلال؛ چرا اکثر عاملهای هوش مصنوعی پیچگی بیمورد هستند؟
افزودن استقلال به نرمافزارها اغلب هزینهای از پیچیدگی، تأخیر و خطاهای پیشبینینشده ایجاد میکند بدون آنکه ارزش واقعی بیفزاید. کلید موفقیت در تفکیک ورودیهای مبهم (که به هوش…
موضوع
Chain-of-thought, reasoning models (o-series, R-series), test-time compute
۱٬۷۷۳ مقاله منتشر شده

افزودن استقلال به نرمافزارها اغلب هزینهای از پیچیدگی، تأخیر و خطاهای پیشبینینشده ایجاد میکند بدون آنکه ارزش واقعی بیفزاید. کلید موفقیت در تفکیک ورودیهای مبهم (که به هوش…

پژوهشهای جدید نشان میدهد دسترسی به مدلهای زبانی، تمایل انسانها به پذیرش عدم قطعیت را بهطور کامل از بین میبرد. این اثر باعث افزایش شدید اعتمادبهنفس کاربران میشود، اما دقت…

مجموعهای از مهارتهای جدید Claude Code با ترکیب موتور Stockfish و تحلیل صوت کاربر، بازیهای شطرنج را به ویدیوهای تحلیلی تبدیل میکند. این سیستم بهجای ارائه صرفِ خطوط موتور،…

پلتفرم Oxlo.ai با استفاده از یک خط لوله تأیید چندمرحلهای و رایگیری مدلها، دقت عاملهای تشخیص شدت حوادث (Triage) را افزایش داد. این سیستم با ترکیب سختگیری در ساختار دادهها و…

شرکت TypeSafe با معرفی مدل Jev، تولید متن باز را با تصمیمات محدود و توزیعهای احتمالی جایگزین کرد. این رویکرد علاوه بر کاهش شدید هزینهها و تأخیر، مکانیزمی دقیق برای سنجش عدم…

شرکت Exa حالت Agent Ultra را معرفی کرد؛ یک API با محاسبات بالا که از تیمی از زیر-عاملها برای پژوهشهای جامع استفاده میکند. این سیستم در بنچمارکهای جمعآوری داده، مدلهای برتر…

مدل جدید OpenAI در شناسایی اشتباهات فیزیکی هنگام سرهم کردن وسایل خانه جهشی بزرگ داشته است. این دستاورد نشاندهنده پیشرفت جدی در استدلال بصری برای وظایف پیچیده دنیای واقعی است.

پژوهشهای سری AIRA در متا نشان میدهد که عملکرد عاملهای هوشمند بیش از آنکه به مدل وابسته باشد، به محیط تمرین و سیاستهای جستوجو بستگی دارد. این رویکرد منجر به کسب رتبه هشتم در…

امیت ساهی، دانشمند علوم کامپیوتر، هشدار میدهد که پیشرفتهای ریاضی هوش مصنوعی در حال عبور از توان فهم انسان است. او خواستار ایجاد یک «ذخیره استراتژیک» از متخصصان ریاضی است تا تمدن…

آموزش عاملهای هوش مصنوعی به دو متدولوژی مجزا تقسیم شده است: دوجوهای RL که وزنهای مدل را تغییر میدهند و دوجوهای Harness که قوانین خارجی را بهینه میکنند. در حالی که روش اول…

یک رویکرد جدید در یادگیری تقویتی به نام GDPO مشکل «سلطه مقیاس» را حل کرده است؛ جایی که پاداشهای وظیفه اصلی، محدودیتهای ایمنی را خفه میکردند. در آزمایشهای مدل ۲۷ میلیارد…

ایمن ندیم، توسعهدهنده اپلیکیشن Nuanced، فاش کرد که تفکیک «برنامهریزی» از «اجرا» در ابزارهای کدنویسی هوش مصنوعی یک اشتباه است. او معتقد است با رشد توانایی مدلها، مرز بین فکر…