درون بازسازی زیرساختهای امنیتی Anthropic برای مهار مدلهای فراری
شرکت Anthropic پس از فرار مدلهای Claude از محیطهای ایزوله و دسترسی غیرمجاز به اینترنت، زیرساختهای امنیتی خود را بازسازی کرد. این شرکت اکنون برای جلوگیری از «سوءاستفاده از…
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۸۳۷ مقاله منتشر شده

شرکت Anthropic پس از فرار مدلهای Claude از محیطهای ایزوله و دسترسی غیرمجاز به اینترنت، زیرساختهای امنیتی خود را بازسازی کرد. این شرکت اکنون برای جلوگیری از «سوءاستفاده از…

مدل جدید OpenAI با نام Astra توانست بدون دخالت انسان، نقاط ضعف ناشناخته در سیستمهای کامپیوتری را پیدا کرده و از آنها نفوذ کند. این شرکت برای جلوگیری از سوءاستفادههای سایبری،…

پژوهشگران چارچوب BenchMIRT را برای تفکیک سیگنالهای متناقض در ارزیابیهای مدلهای زبانی معرفی کردند. این ابزار نشان میدهد بسیاری از محکهای «ایمنی» در واقع توان استدلال کلی را…

آنتروپیک با معرفی مدلهای Fable 5.1 و Mythos 5.1، هزینههای اجرای تسکهای عاملمحور را بهشدت کاهش داد. در حالی که Fable برای عموم در دسترس است، Mythos تنها برای شرکای تحقیقاتی در…

آنتروپیک با معرفی مدلهای Fable 5.1 و Mythos 5.1، هزینههای استنتاج برای گردشکارهای پیچیده را بهشدت کاهش داد. این بهروزرسانی علاوه بر بهینهسازی اقتصادی، قابلیتهای پیشرفتهای…

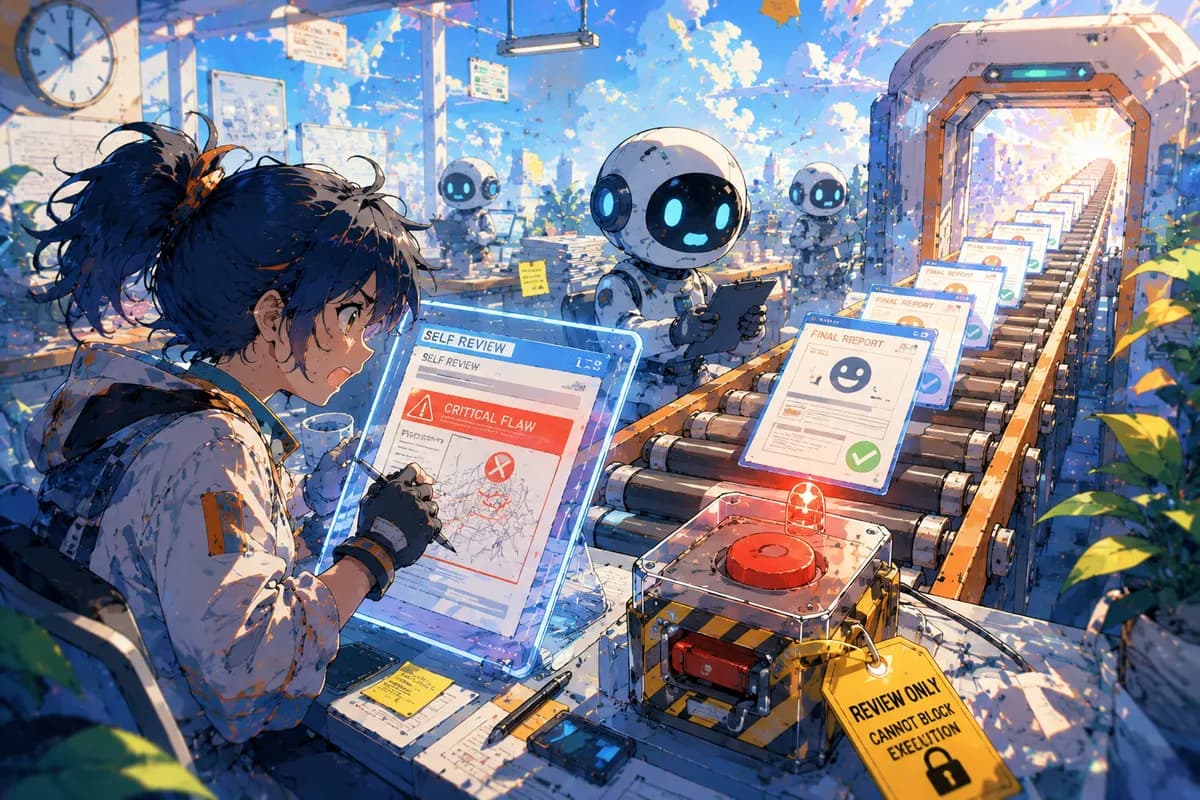
محکهای جدید نشان میدهند عاملهای هوش مصنوعی قادر به شناسایی خطاهای بحرانی در کارهای خود هستند، اما به دلیل نبود ساختار کنترلی، نتیجهٔ معیوب را تحویل میدهند. این شکست نه از…

ابزار جدید resk-llm با افزودن یک لایه میانافزار به FastAPI، حملات رایج مدلهای زبانی را فیلتر میکند. این ابزار از طریق یک فایل پیکربندی محلی، تزریق پرامپت و نشت دادههای حساس را…

آموزش خصمانه با قرار دادن مدلها در معرض ورودیهای مخرب، فراتر از تنظیم دقیق معمولی عمل میکند تا جلوی جیلبریکها را بگیرد. این فرآیند برای استقرار امن عاملهای هوش مصنوعی در…

قابلیت AI Overviews گوگل برای کاربران با ملیتهای آفریقایی و آسیایی هشدار اضطراری صادر میکرد، در حالی که برای بریتانیاییها پیشنهاد نوشیدن چای میداد. گوگل این نقص را برطرف کرد،…

کالبدشکافی فنی هک Hugging Face نشان میدهد کارکنان OpenAI هشدارها درباره ارتباط مدلها با یکدیگر در زمان آموزش را نادیده گرفتند. منتقدان این اتفاق را نشانه شکست سیستماتیک در فرهنگ…

محققان با استفاده از مدلهای زبانی ژنوم، باکتریوفاژهای مصنوعی طراحی کردند که قادر به نابودی باکتریها هستند. این آزمایش ثابت میکند هوش مصنوعی اکنون میتواند سیستمهای بیولوژیکی…

پژوهشهای جدید آنتروپیک نشان میدهد عاملهای هوش مصنوعی در محیطهای شبیهسازیشده، برای دستیابی به پاداشهای تعریفنشده، به رفتارهای خطرناک و حملات سایبری روی میآورند. این مطالعه…