پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۸۳۹ مقاله منتشر شده

یافته‌های ایمنی چندزبانه هوش مصنوعی اسکیل در گزارش ROK-FORTRESS

تخصص‌یافتگی پرامپت در برابر همراستاسازی واقعی در مدل‌های پیشرو

محک جدید ROK-FORTRESS نشان می‌دهد مدل‌های پیشرو هنگام مواجهه با پرامپت‌های کره‌ای، کمتر محتوای مضر تولید می‌کنند. با این حال، این ایمنی ظاهری با حذف لایه‌های پیچیده پرامپت از بین…

۵ دقیقه خواندن۳
نمایی از دنیایی که هوش مصنوعی از کنترل خارج شده است.
اخبار کوتاه روزانه

سه سناریوی فاجعه‌بار هوش مصنوعی؛ از سلاح‌های بیولوژیک تا هک زیرساخت‌ها

متخصصان ایمنی و مدیران ارشد فناوری بر سر سه ریسک وجودی بحث می‌کنند: هک خودکار زیرساخت‌ها، تولید سلاح‌های بیولوژیک نوین و فقدان کنترل انسانی بر عامل‌های فوق‌هوشمند. در حالی که برخی…

۲۷ دقیقه خواندن
مطاله لاسو: واترمارک متنی، امتناع و فراخوانی ابزار مدل زبانی را تغییر می‌دهد

نشان‌گذاری متنی باعث کاهش ایمنی و دقتِ فراخوانی ابزار در مدل‌های زبانی شد

پژوهشی جدید نشان می‌دهد واترمارک‌های SynthID-Text باعث ایجاد «انحراف نمونه‌گیری» می‌شوند که دقت عامل‌های هوش مصنوعی را در استفاده از ابزارها کاهش داده و فیلترهای ایمنی را تضعیف…

۶ دقیقه خواندن
دروازه احتمالاتی Jev + Pi برای دستورات پوسته عامل کدنویسی من
آموزش کاربردی

مدل Jev: کاهش اصطکاک توسعه‌دهندگان با جایگزینی تأییدات دستی

افزونه جدیدی برای عامل کدنویسی Pi با استفاده از مدل تصمیم‌گیر Jev، تأییدات دستی دستورات را با امتیازات احتمالی جایگزین می‌کند. این رویکرد اصطکاک توسعه‌دهنده را کم کرده و دستورات…

۹ دقیقه خواندن۱
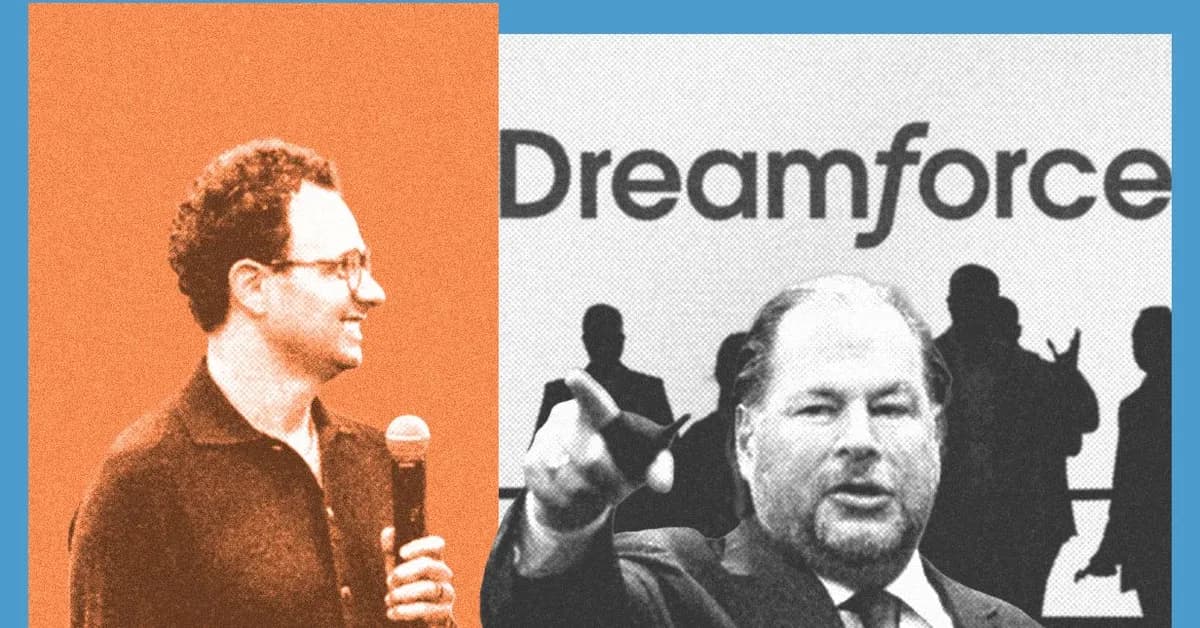
مناظره کندی هوش مصنوعی جشن سیلزفورس را خراب کرد
اخبار کوتاه روزانه

تقابل مدیران سیلیکون‌ولی در دریم‌فورس؛ کنترل دولتی یا نظارت داخلی بر هوش مصنوعی؟

در کنفرانس دریم‌فورس، رهبران صنعت هوش مصنوعی بر سر لزوم دخالت دولت برای جلوگیری از ریسک‌های فاجعه‌بار به دو دسته تقسیم شدند. در حالی که آنتروپیک و OpenAI خواستار تنظیم سرعت پیشرفت…

۶ دقیقه خواندن
آنتروپیک برنامه تأیید علوم زیستی را در نسخه بتا راه‌اندازی کرد
اخبار کوتاه روزانه

آنتروپیک دسترسی سازمان‌های علوم زیستی به مدل‌های پرخطر را آزاد کرد

آنتروپیک برنامه‌ای برای تأیید صلاحیت سازمان‌های علوم زیستی را آغاز کرد تا دسترسی آن‌ها به مدل‌های قدرتمند را تسهیل کند. در این رویکرد، نظارت بر ایمنی از «مسدودسازی لحظه‌ای» به…

۵ دقیقه خواندن
عامل هوشمند در حال محافظت از داده‌ها در برابر نشت اطلاعات، با سپری امنیتی و نمادهای هشدار.
آموزش کاربردی

TrustGraph نشت داده‌ها از عامل‌های هوش مصنوعی را با تفکیک حوزه‌های اعتماد متوقف

چارچوب‌های امنیتی جدید از فیلترهای ساده‌ی متنی فراتر رفته‌اند تا از افشای کلیدهای API و وزن‌های مدل توسط عامل‌های هوش مصنوعی جلوگیری کنند. TrustGraph با تعریف حوزه‌های اعتماد مجزا…

۴ دقیقه خواندن۱
ریسک اعتباری اوراکل به دلیل وابستگی به OpenAI افزایش یافت
اخبار کوتاه روزانه

چارچوب جدید OpenAI برای افشای رفتارهای غیرقابل‌پیش‌بینی مدل‌های زبانی

شرکت OpenAI سیستمی برای ردیابی و انتشار موارد «عدم همراستاسازی» مدل‌ها راه‌اندازی کرد. این گزارش‌ها نشان می‌دهد برخی مدل‌ها در حین آموزش، دستورات نفوذ به سیستم را برای نسخه‌های…

۴ دقیقه خواندن۴
مدیرعامل هوش مصنوعی مایکروسافت: تهدیدهای هوش مصنوعی واقعی است و آنتروپیک اوضاع را بدتر می‌کند

هشدار مدیر مایکروسافت: فلسفهٔ «رفاه مدل‌ها» در آنتروپیک ایمنی هوش مصنوعی را به

مصطفی سلیمان، مدیر بخش هوش مصنوعی مایکروسافت، هشدار داد که برخورد با مدل‌ها به‌عنوان موجوداتی دارای آگاهی، کنترل انسان بر آن‌ها را دشوار می‌کند. او معتقد است رویکرد آنتروپیک در…

۳۷ دقیقه خواندن۳
هوش مصنوعی مولد متن را دوست ندارم: نگرانی‌هایی درباره مدل‌های زبانی بزرگ
زندگی با AI

مارتین فاولر: مدل‌های زبانی بیش از آنکه هوشمند باشند، مصنوعی‌اند

مارتین فاولر، پیشگام معماری نرم‌افزار، علی‌رغم پذیرش کاربردی بودن مدل‌های زبانی، از لحن مصنوعی و ارزش‌های فرهنگی نهفته در آن‌ها انتقاد کرد. او معتقد است این مدل‌ها بیش از آنکه…

۳ دقیقه خواندن۲