
Meta Quest: انتقال تمرینات بالینی چشم به محیطهای VR
اپلیکیشن جدید Amblyotube تمرینات پیچیده بالینی برای درمان آمبلیوپی (چشم تنبل) را به یک تجربه VR در خانه تبدیل کرده است. این ابزار با استفاده از Meta Quest، مراقبتهای تخصصی چشم را…
۴ دقیقه خواندن۲
موضوع
Models that natively process text+image+audio+video
۱٬۳۴۷ مقاله منتشر شده
اپلیکیشن جدید Amblyotube تمرینات پیچیده بالینی برای درمان آمبلیوپی (چشم تنبل) را به یک تجربه VR در خانه تبدیل کرده است. این ابزار با استفاده از Meta Quest، مراقبتهای تخصصی چشم را…

سازندگان مستقل از تولید پراکنده موسیقی به سمت ایجاد «اکوسیستمهای صوتی» حرکت میکنند. با تبدیل پرامپتها به APIهای پایدار، آنها اکنون برند صوتی یکسانی را در تمام کانالهای…
یک متد جدید با تفکیک وظایف بین مدل Whisper برای زمانبندی دقیق و GPT-4o-mini برای تولید فصلبندی، از اتلاف توکنهای گرانقیمت جلوگیری میکند. این رویکرد هزینههای API را برای…

شبکه ورزشی Wanjian با استقرار یک معماری سه لایه، دادههای رفتاری کاربران را در محیط واقعی استخراج کرد. این سیستم با ترکیب رایانش لبه و بینایی ماشین، شکاف دادهای میان گجتهای…
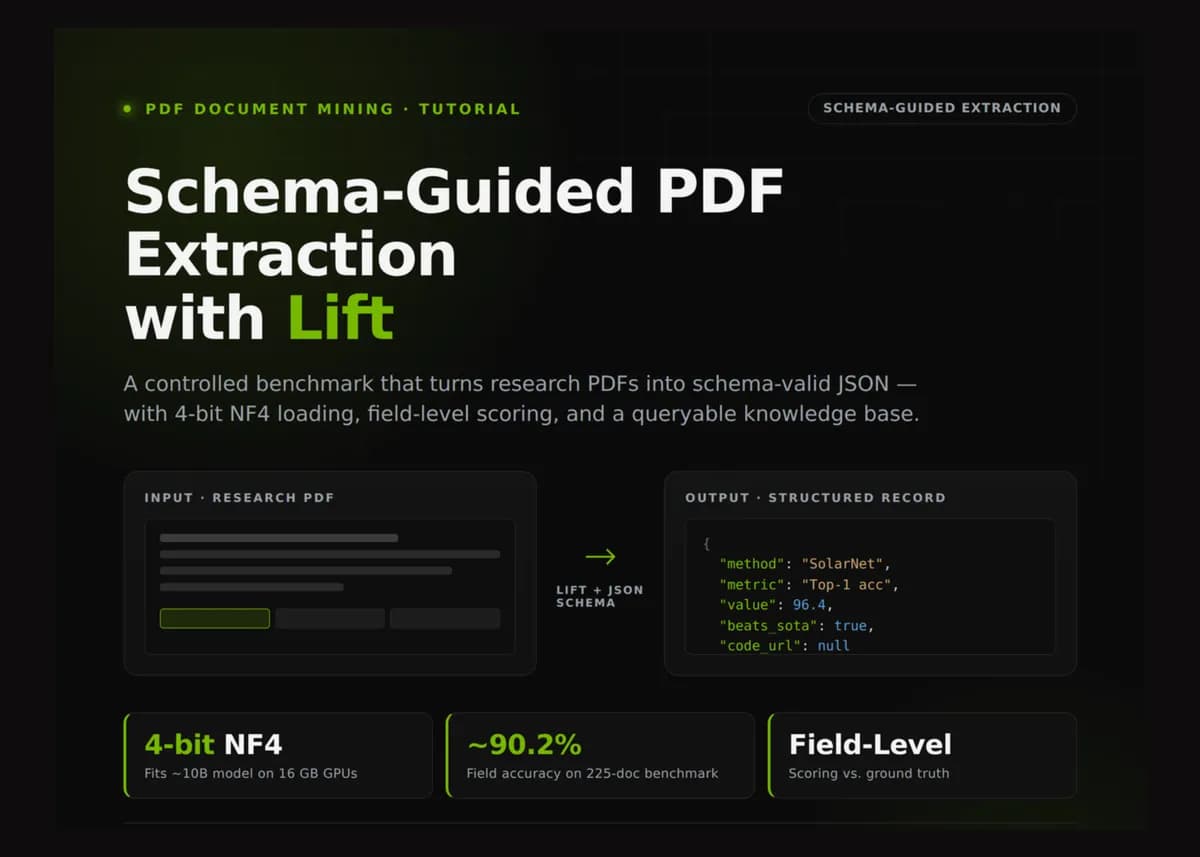
مدل Lift با استفاده از استخراج دادهها بر اساس طرحواره (Schema) و کوانتش ۴-بیتی، اسناد PDF را به فرمت JSON تبدیل میکند. این روش امکان استخراج دقیق دادههای فنی را حتی روی…
ابزارهای نظارتی فعلی با نادیده گرفتن خط لولهی صوتی، ریشهی شکست عاملهای صوتی را پنهان میکنند. تحلیلهای عملی نشان میدهد خطاهای بحرانی مانند قطع تماس، محصول زمانبندی…

تولیدکنندگان برتر ویدیو با استفاده از یک خطلوله چهارلایه از عاملهای هوش مصنوعی، ویدیوهای ویروسی را مهندسی معکوس کرده و با Veo 3 بازتولید میکنند. کلید موفقیت این سیستم نه در…

ابزارهای تولید موسیقی با هوش مصنوعی، برندسازی صوتی را از یک کالای لوکس برای شرکتهای بزرگ به دارایی عملیاتی برای تولیدکنندگان کوچک تبدیل کردهاند. این رویکرد به جای یک آهنگ کوتاه،…
هگینگ فیس و سربرس با ادغام مدل Gemma 4 و سختافزار استنتاج فوقسریع، یک خط لوله صوتی بلادرنگ ایجاد کردند. این سیستم با حذف تأخیرهای چندثانیهای، مکالمات هوش مصنوعی را به جریان…

گوگل پس از ۶ سال اولین بلندگوی هوشمند خود را مخصوص Gemini عرضه کرد. با وجود طراحی جذاب، سرعت پایین پاسخدهی و محدودیتهای اشتراکی، تجربه کاربری این دستگاه هنوز ناتمام است.

موج جدیدی از پژوهشها در هاکینگ فیس نشان میدهد که تمرکز صنعت از تولید متن ساده به سمت مدلهای جهانی (World Models) برای درک قوانین فیزیک و عاملهایی که زمان توقف برای جلوگیری از…

سرویس Vavus AI با ارائه قابلیت تبدیل گفتار به متن و ترجمهٔ همزمان، دشواری درک محتوای صوتی را برای دانشجویان و متخصصان غیربومی از بین میبرد. این ابزار تمرکز خود را بر محیطهایی…