اگر امروز برای استنتاج مدلهای سطح بالا هزینه میپردازید، صورتحساب ماهانه شما با مدل جدید آنتروپیک تا ۴۰ درصد کاهش مییابد. این مدل نه تنها ارزانتر است، بلکه در بسیاری از محکهای استدلالی، رقبای قدرتمندی چون GPT-6 Astra را پشت سر گذاشته است.
در حالی که مدل پرچمدار Fable 5.1 برای مدتها استاندارد استدلالهای سطح بالای هوش مصنوعی را تعیین کرده بود، آنتروپیک در ۲۲ سپتامبر ۲۰۲۶ مدل Claude Opus 5.5 را عرضه کرد تا همان سطح از عملکرد را با هزینه عملیاتی ۴۰ درصد کمتر و سرعتهای بالاتر ارائه دهد.
این تحول در حالی رخ میدهد که آزمایشگاههای هوش مصنوعی تحت فشار شدید برای کاهش «هزینهٔ هوشمندی» هستند. در واقع صنعت از تمرکز بر توانمندی خام به سمت بهینهسازی حرکت کرده تا اجرای گردشهای کاری عاملمحور (Agentic) — شبیه به داشتن یک کارمند دیجیتال که میتواند چندین مرحله از یک پروژه را بدون نظارت پیش ببرد — در مقیاس واقعی بهصرفه شود. همانطور که در تحلیل قبلی ما دربارهی پرامپتهای تأییدشده برای عاملهای هوش مصنوعی اشاره کردیم، برای اجرای این فرآیندهای پیچیده و چندمرحلهای، به محاسباتی ارزانتر نیاز است تا بودجه شرکتها پیش از رسیدن به نتیجه تمام نشود. این رویکرد بهینهسازی هزینهها در ادامه مسیر کاهش ۴۵ درصدی هزینهٔ اجرای عاملهای هوش مصنوعی در Claude Fable 5.1 قرار دارد که پیشتر گامی مهم در جهت تجاریسازی مدلهای عاملمحور بود.
تغییر در معادله هزینه و عملکرد
آنتروپیک برای رقابت با OpenAI و مدلهای نوظهور چینی — که اغلب عملکرد پایینتری دارند اما با قیمتی بسیار اندک عرضه میشوند — قیمتهای خود را بهطور تهاجمی کاهش داده است. قیمتگذاری جدید برای Opus 5.5 برابر با ۴ دلار برای هر میلیون توکن ورودی و ۲۰ دلار برای هر میلیون توکن خروجی است. این رقم نشاندهنده کاهش مستقیم ۲۰ درصدی قیمت توکنها در مقایسه با Opus 5 است که قیمتهای آن به ترتیب ۵ و ۲۵ دلار بود.
اما صرفهجویی واقعی در هزینههای کلی عملیاتی نهفته است. به دلیل اینکه این مدل توکنهای کمتری مصرف میکند و خروجیها را ۳۰ درصد سریعتر تولید میکند، آنتروپیک ادعا میکند که هزینههای کل تقریباً ۴۰ درصد کمتر از Opus 5 است. همچنین هزینه خواندن از حافظه موقت (Cache read) ۶۰ درصد کاهش یافته و از ۰.۵۰ دلار به ۰.۲۰ دلار برای هر میلیون توکن رسیده است. هزینه نوشتن در حافظه موقت (Cache write) نیز از ۶.۲۵ دلار به ۵ دلار برای هر میلیون توکن کاهش یافته است.
بنچمارک در برابر غولها
بر اساس دادههای Artificial Analysis، مدل Opus 5.5 اکنون با امتیاز ۵۸ در «شاخص هوشمندی» (Intelligence Index) پیشتاز است و از هر دو مدل Claude Fable 5.1 و GPT-6 Astra شرکت OpenAI (که هر دو امتیاز ۵۳ کسب کردند) پیشی گرفته است.
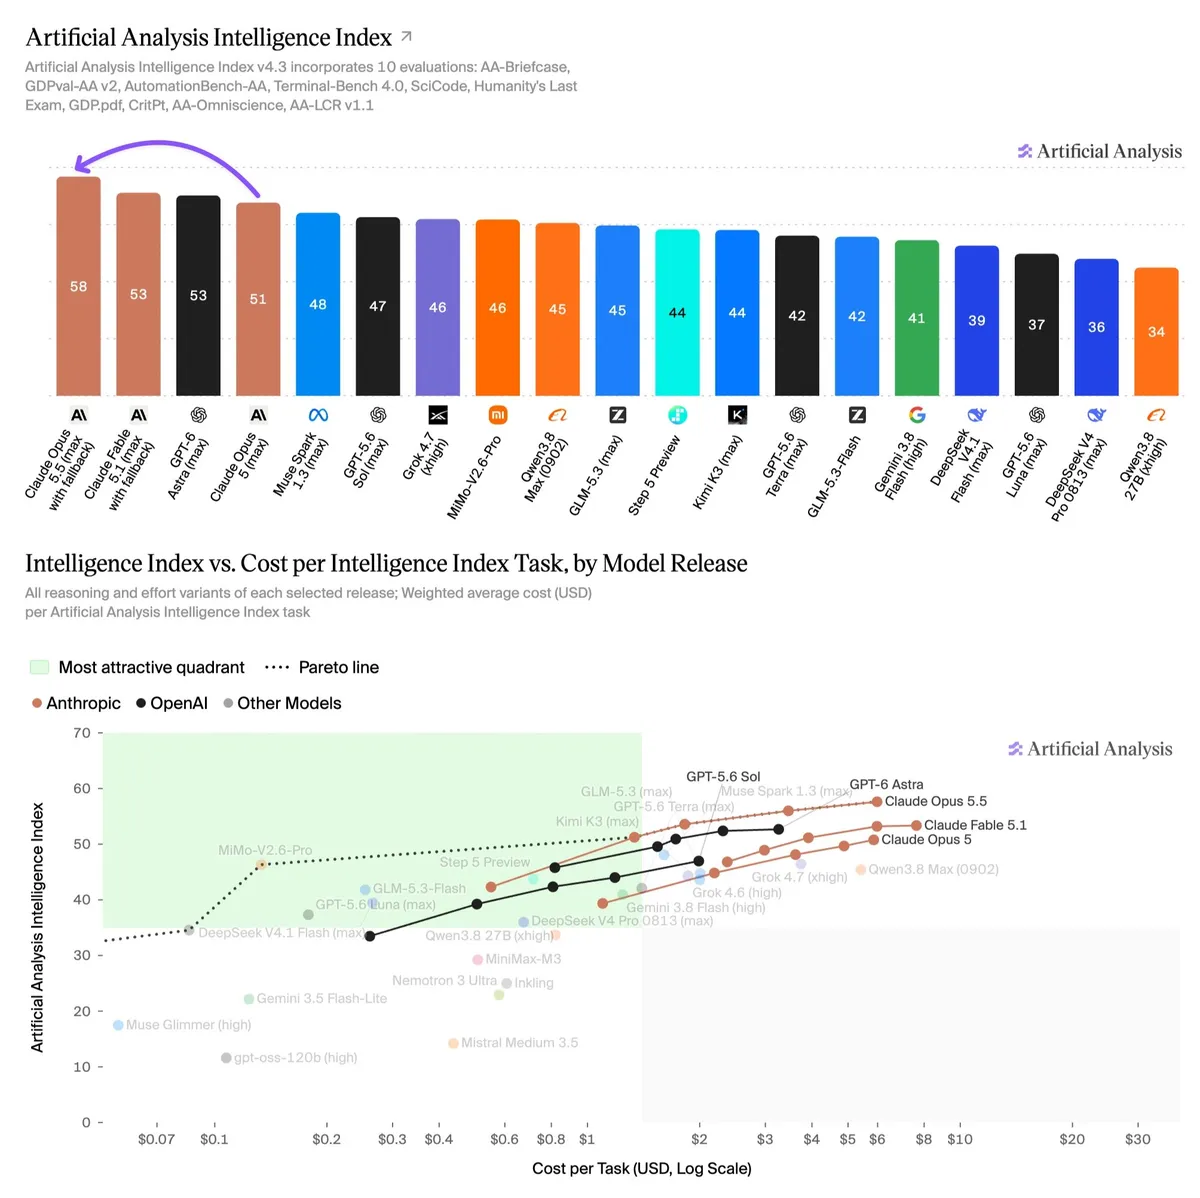
در حوزههای کدنویسی عاملمحور و کارهای دانشی، این مدل در چندین بنچمارک کلیدی پیشرفتهای قابلتوجهی نشان داده است:
- Terminal-Bench 4.0: کسب امتیاز ۵۹.۶٪ (طبق Artificial Analysis) و ۶۶.۴٪ (طبق آنتروپیک) که با GPT-6 Astra برابر شده و ۱۱ امتیاز از Opus 5 پیشی گرفته است.
- Humanity's Last Exam: ثبت رکورد جدید ۶۱.۴٪ (Artificial Analysis) و ۶۷.۷٪ با استفاده از ابزارها (آنتروپیک)، که از امتیاز ۵۹.۱٪ مدل Fable 5.1 بالاتر است.
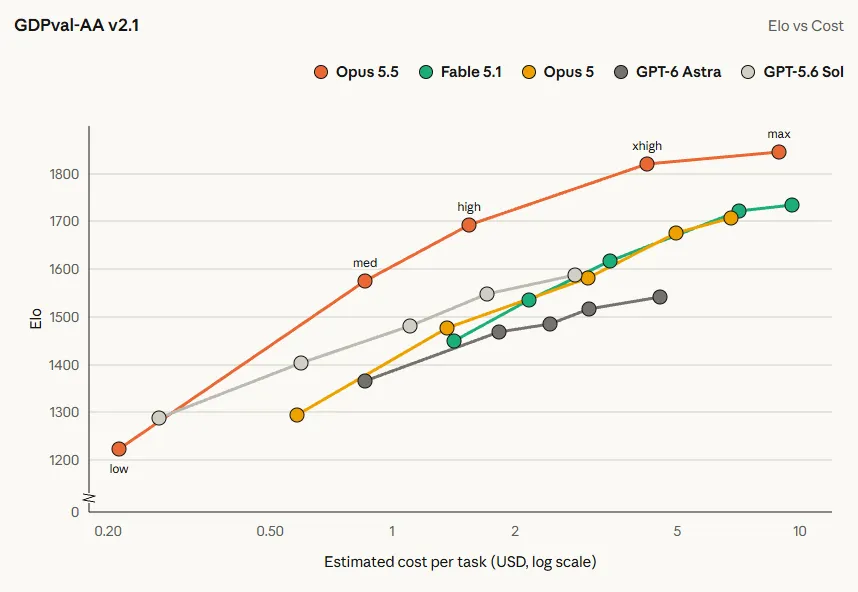
- GDPval-AA v2.1: برتری در تقریباً تمام حالتهای استدلالی نسبت به Astra، به جز حالت 'low'. آنتروپیک امتیاز ۱,۸۴۶ را گزارش کرده که از Fable 5.1 (۱,۷۳۵) و GPT-6 Astra (۱,۵۴۲) بیشتر است.
- FrontierCode v1.1 (Main): کسب امتیاز ۵۴.۴٪ و شکست دادن GPT-6 Astra (۵۳.۳٪) در حالی که هزینه هر تسک تقریباً ۲۰ درصد است.
- CursorBench 4.0: کسب امتیاز ۵۷.۸٪ و برتری ۱۱ امتیازی نسبت به GPT-5.6 Sol با یکسوم هزینه.
- AutomationBench: رسیدن به امتیاز ۴۰.۰٪ که بهطور قابلتوجهی بالاتر از Fable 5.1 (۳۱.۴٪) و Opus 5 (۲۶.۹٪) است.
- Terminal-Bench-Science 0.1: کسب امتیاز ۵۸.۷٪، هرچند در این مورد از امتیاز ۶۴.۶٪ مدل GPT-6 Astra عقبتر است.
- OSWorld 2.0: رسیدن به نرخ ۸۱.۸٪ (بخش جزئی) برای تسکهای مربوط به استفاده از کامپیوتر.
- Chartography: کسب امتیاز ۸۹.۰٪ با استفاده از ابزارها برای تشخیص بصری نمودارها.
نابودی سبک «کلودگونه»
فراتر از اعداد و ارقام، آنتروپیک در حال مقابله با یکی از شکایتهای قدیمی کاربران است: سبک نوشتاری فرمولوار و پیچیدهای که به «کلودگونه» (Claudish) معروف شده است. این شرکت ادعا میکند Opus 5.5 اکنون طبیعیتر ارتباط برقرار میکند؛ به این صورت که اطلاعات حیاتی را در ابتدا قرار میدهد، کمتر از اصطلاحات تخصصی (Jargon) استفاده میکند و دستورات نوشتاری را با دقت بیشتری دنبال میکند.
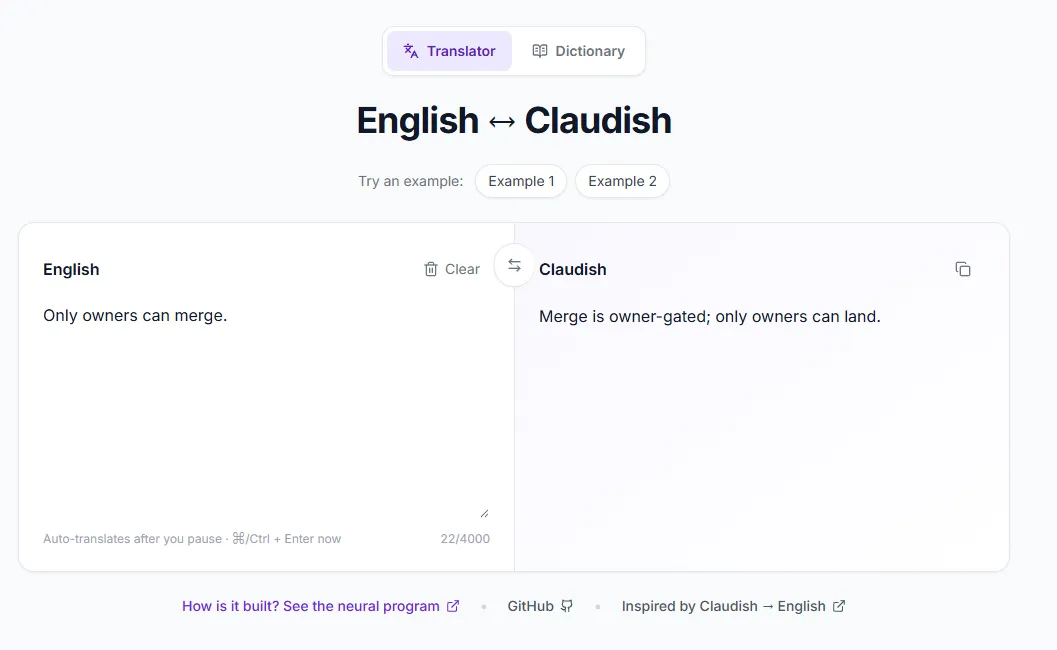
تسترهای اولیه گزارش میدهند که نوشتار مدل شفافتر و قابلفهمتر شده است و این امر آن را به شریکی مؤثرتر برای کارهای حرفهای و متون بلند تبدیل میکند. آنتروپیک بهطور ویژه بازخوردهای مشتریان در بخشهای خدمات مالی، حقوق و توسعه نرمافزار را برای اصلاح این ویژگیهای ارتباطی هدف قرار داده است.
امنیت و ضد-استخراج (Anti-Distillation)
مدل Opus 5.5 مکانیزم جدیدی به نام «تفکر حفظشده» (Preserved Thinking) را معرفی کرده است که برای توقف «حملات استخراج» (Distillation attacks) طراحی شده است. این حملات زمانی رخ میدهند که مهاجمان از هزاران حساب جعلی استفاده میکنند تا الگوهای استدلالی مدل را در مقیاس صنعتی استخراج کرده و مدلهای رقیبی بدون حفاظهای امنیتی بسازند. آنتروپیک به گزارش تهدیدات سپتامبر ۲۰۲۶ اشاره میکند که فعالیتهای استخراج غیرقانونی شناسایی و متوقف شده را مستند کرده است.
این تدبیر برای مدلهای Fable 5.1 و Opus 5.5 در حسابهای API که در تاریخ ۳۱ اوت ۲۰۲۶ یا پس از آن ایجاد شدهاند، اعمال میشود. این سیستم از کاربران API جلوگیری میکند تا با ویرایش کانتکست قبلی کلود، استدلالهای داخلی آن را استخراج کنند.
برای انطباق با قانون هوش مصنوعی اتحادیه اروپا (EU AI Act)، این مدل اکنون شامل نشانگذاری (Watermarking) است و نمیتواند در حالی که حالت «تفکر» (Thinking) غیرفعال است، اجرا شود. همچنین این مدل با قابلیت «عدم ذخیرهسازی دادهها» (Zero Data Retention) در دسترس است.
از نظر ایمنی، Opus 5.5 اولین مدل خانواده Opus است که دارای حفاظهای امنیتی برای امنیت سایبری، بیولوژی و توسعه مدلهای پیشرو (Frontier LLM) است که با سطح Fable 5.1 برابری میکند. این رویکرد در راستای تأکید آنتروپیک بر توازن میان ایمنی و قابلیتها در Opus 5.5 است تا اطمینان حاصل شود که افزایش قدرت مدل منجر به ایجاد ریسکهای امنیتی جدید نمیشود. هنگامی که این حفاظها فعال میشوند، درخواستها بهطور شفاف به مدلهای دیگر هدایت میشوند:
- تسکهای امنیت سایبری: اکثر این درخواستها به مدل قدیمیتر Opus 4.8 هدایت میشوند، هرچند کاربران همچنان میتوانند باگهای کد خودشان را پیدا و رفع کنند.
- بیولوژی و توسعه مدلهای پیشرو: درخواستهایی که توسط طبقهبندیکنندهها شناسایی شوند، به Opus 5 هدایت میشوند.
سازمانهای تأییدشده میتوانند از طریق «برنامه تأیید علوم زیستی» برای دسترسی به تحقیقات بیولوژیکی درخواست دهند. آنتروپیک همچنین قصد دارد در هفتههای آینده «برنامه تأیید سایبری» خود را به Opus 5.5 گسترش دهد.
توازن در بهرهوری
یک نکته در مورد حجم توکنها وجود دارد. Artificial Analysis اشاره میکند که در حداکثر تلاش (Maximum Effort)، مدل Opus 5.5 حدود ۱۱۹,۰۰۰ توکن خروجی برای هر تسک مصرف میکند. این مقدار بهطور قابلتوجهی بیشتر از Opus 5 (۷۳,۰۰۰)، Fable 5.1 (۷۸,۰۰۰) یا GPT-6 Astra (۲۷,۰۰۰) است.
در حالی که قیمتهای پایینتر توکن باعث میشود هزینه هر تسک رقابتی باقی بماند، اما مدل در پردازشهای داخلی خود «پرگوتر» (Verbose) شده است. این تغییر نشان میدهد که آنتروپیک روی «محاسبات زمان استنتاج» (Test-time compute) — یعنی استفاده از توکنهای بیشتر برای فکر کردن عمیقتر روی یک مسئله — شرطبندی کرده تا به امتیازات پیشرو دست یابد. با این حال، چهار سطح از پنج سطح تلاش در Opus 5.5 در مرز پارتو (Pareto frontier) برای هزینه هر تسک قرار دارند.
برای کاربر تجاری، این به معنای گسترش مؤثر محدودیتهای اشتراک ماهانه است. محدودیتهای استفاده ۵ ساعته برای مشترکین ۲۰ درصد افزایش مییابد و سقف کلی استفاده به دلیل بهرهوری مدل ۲۵ درصد بیشتر میشود. همچنین کاربران اکنون قابلیت ذخیره بازنشانی محدودیت (Limit Reset) را برای زمانهایی که بیشترین نیاز را دارند، به دست آوردهاند.
زمینه صنعت و چشمانداز آینده
آنتروپیک در حالی که مدلها توانمندتر میشوند، بهویژه مدلهایی که میتوانند پژوهشهای AI را بهطور کامل خودکار کنند، خواستار استانداردهای ایمنی بالاتری است. این شرکت استدلال میکند که سیاستهای عمومی باید نقش پررنگتری در تعیین این استانداردها داشته باشند. برای بهبود همسویی (Alignment)، آنتروپیک محیطهای یادگیری تقویتشده (RL) را با سختگیری بیشتری غربال میکند تا محیطهای آموزشی معیوب — که آنها را منبع اصلی رفتارهای ناسازگار میدانند — حذف کند.
آنتروپیک همچنین در حال توسعه روشهای خودکار برای ایجاد سناریوهای آموزشی ایمنی و اقدامات نظارتی قویتر است. این اقدامات در میان بحثهای گستردهتری رخ میدهد که در آن OpenAI خواستار استانداردهای بینالمللی برای هوش مصنوعی خود-بهبودبخش شده و پژوهشگران از آزمایشگاهها خواستهاند تا عرضه مدلها را تا زمان رسیدن روشهای همسویی متوقف کنند. پیش از عرضه، Opus 5.5 توسط سازمانهای خارجی Frontier Design و METR مورد آزمایش قرار گرفت.
مدل Claude Opus 5.5 هماکنون در Amazon Web Services, Google Cloud و Microsoft Azure در دسترس است. توسعهدهندگان میتوانند از طریق پلتفرم کلود و با استفاده از شناسه مدل claude-opus-5-5 به آن دسترسی پیدا کنند.
این حرکت نشاندهنده گذار از عصر «بزرگتر بهتر است» به عصر «هوش بهینه شده» است. آنتروپیک با آوردن قدرت سطح Fable به قیمت Opus، عاملهای استدلالی سطح بالا را برای تولیدات روزانه سازمانی، به جای صرفاً پروژههای آزمایشی، در دسترس قرار داده است.
منتظر عرضه مدلهای Sonnet 5.5 و Haiku 5.5 در هفتههای آینده باشید که انتظار میرود دستاوردهای مشابهی در عملکرد، بهرهوری و ایمنی را برای خانواده مدلهای سطح متوسط و سریع به ارمغان بیاورند.



گفتگو