اشتباه گرفتن یک شکست در انصاف با یک نقص در برازش مدل، میتواند منجر به اصلاحاتی هزینهبر و بیاثر در محیط عملیاتی هوش مصنوعی شود. در ۱ اکتبر ۲۰۲۶، جزئیات فنی مربوط به الزامات آزمون AWS Certified AI Practitioner (AIF-C01) فاش کرد که آمازون وب سرویسز (AWS) چگونه بین سوگیری آماری، واریانس و سوگیری اجتماعی تمایز قائل میشود تا قابلیت اطمینان مدل را تضمین کند.
برای توسعهدهندگان و متخصصان، این تمایز حیاتی است؛ زیرا راهکار مدل «بیش از حد ساده» با مدل «ناانصاف» کاملاً متفاوت است. در دنیایی که صحت کلی (Aggregate Accuracy) اغلب شکستهای سیستماتیک برای گروههای اقلیت را میپوشاند، شناخت «امضای» هر خطا تنها راه انتخاب ابزار تشخیص درست است.
دوگانهی سوگیری: آماری در برابر اجتماعی
به نقل از گزارش dev.to، واژه «سوگیری» در اکوسیستم AWS دو معنای متمایز دارد. اینها دو مشکل جداگانه هستند، هرچند هر دو باعث پیشبینیهای نادرست میشوند. در واقع، لحن توصیف سناریو به شما میگوید کدام معنا کاربرد دارد.
سوگیری آماری (Statistical Bias) — شبیه وقتی است که یک نقاشی را با قلممویی بیش از حد ضخیم میکشید و جزئیات مهم را از دست میدهید — زمانی رخ میدهد که مدل برای ثبت الگوهای زیربنایی دادهها بیش از حد ساده باشد. این وضعیت منجر به عملکرد ضعیف در هر دو مجموعه آموزش و دادههای دیدهنشده میشود که به آن کمبرازش (Underfitting) میگویند. هر جا به صحت آموزش، صحت دادههای دیدهنشده، بیشبرازش یا کمبرازش اشاره شد، موضوع سوگیری آماری است.
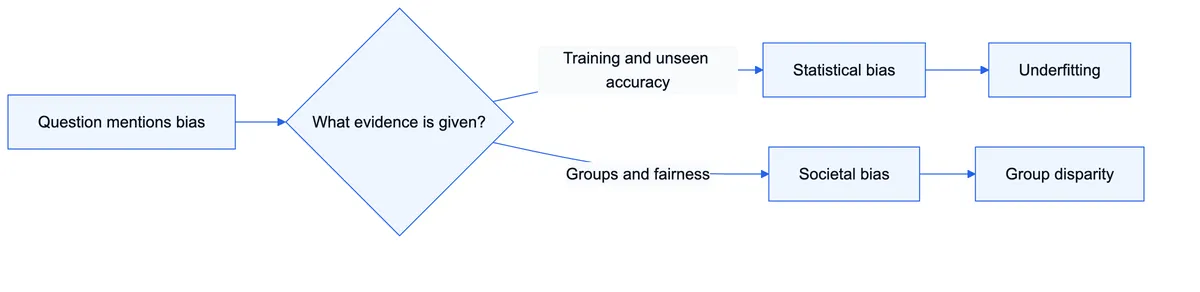
در مقابل، سوگیری اجتماعی یک شکست در انصاف (Fairness) است. یک مدل ممکن است صحت کلی بالایی داشته باشد اما نتایج بهطور سیستماتیک برای گروههای دموگرافیک خاصی بدتر باشد. این یک نقص در برازش نیست؛ مدل ممکن است در کل بهخوبی تعمیم یابد اما برای زیرمجموعهای از کاربران اساساً ناعادلانه باشد. اشاره به انصاف، گروههای دموگرافیک یا نتایج نابرابر، نشانه سوگیری اجتماعی است.
مثالی برای درک بهتر: مدلی را تصور کنید که در هر دو مجموعه آموزش و آزمون نمره پایینی میگیرد؛ این سوگیری آماری بالاست چون مدل هرگز الگو را نفهمیده است. حالا مدلی را فرض کنید که در کل نمرات خوبی میگیرد اما برای متقاضیان مناطق روستایی بسیار ضعیف عمل میکند؛ این سوگیری اجتماعی است. مدل دوم در مجموع بهخوبی تعمیم یافته اما همچنان ناعادلانه است.
واریانس و شکاف بیشبرازش
واریانس (Variance) حساسیت مدل به دادههای خاصی است که روی آنها آموزش دیده است. واریانس بالا بهصورت بیشبرازش (Overfitting) — شبیه دانشآموزی که بهجای یادگیری فرمول ریاضی، جوابهای کتاب را حفظ کرده و در امتحان با اعداد جدید شکست میخورد — ظاهر میشود. در این حالت، مدل جزئیات خاص مجموعه آموزش را یاد میگیرد بهجای اینکه الگویی را بیابد که قابل تعمیم باشد. مدل روی دادههای آموزش عالی عمل میکند اما روی دادههای دیدهنشده ضعیف است.
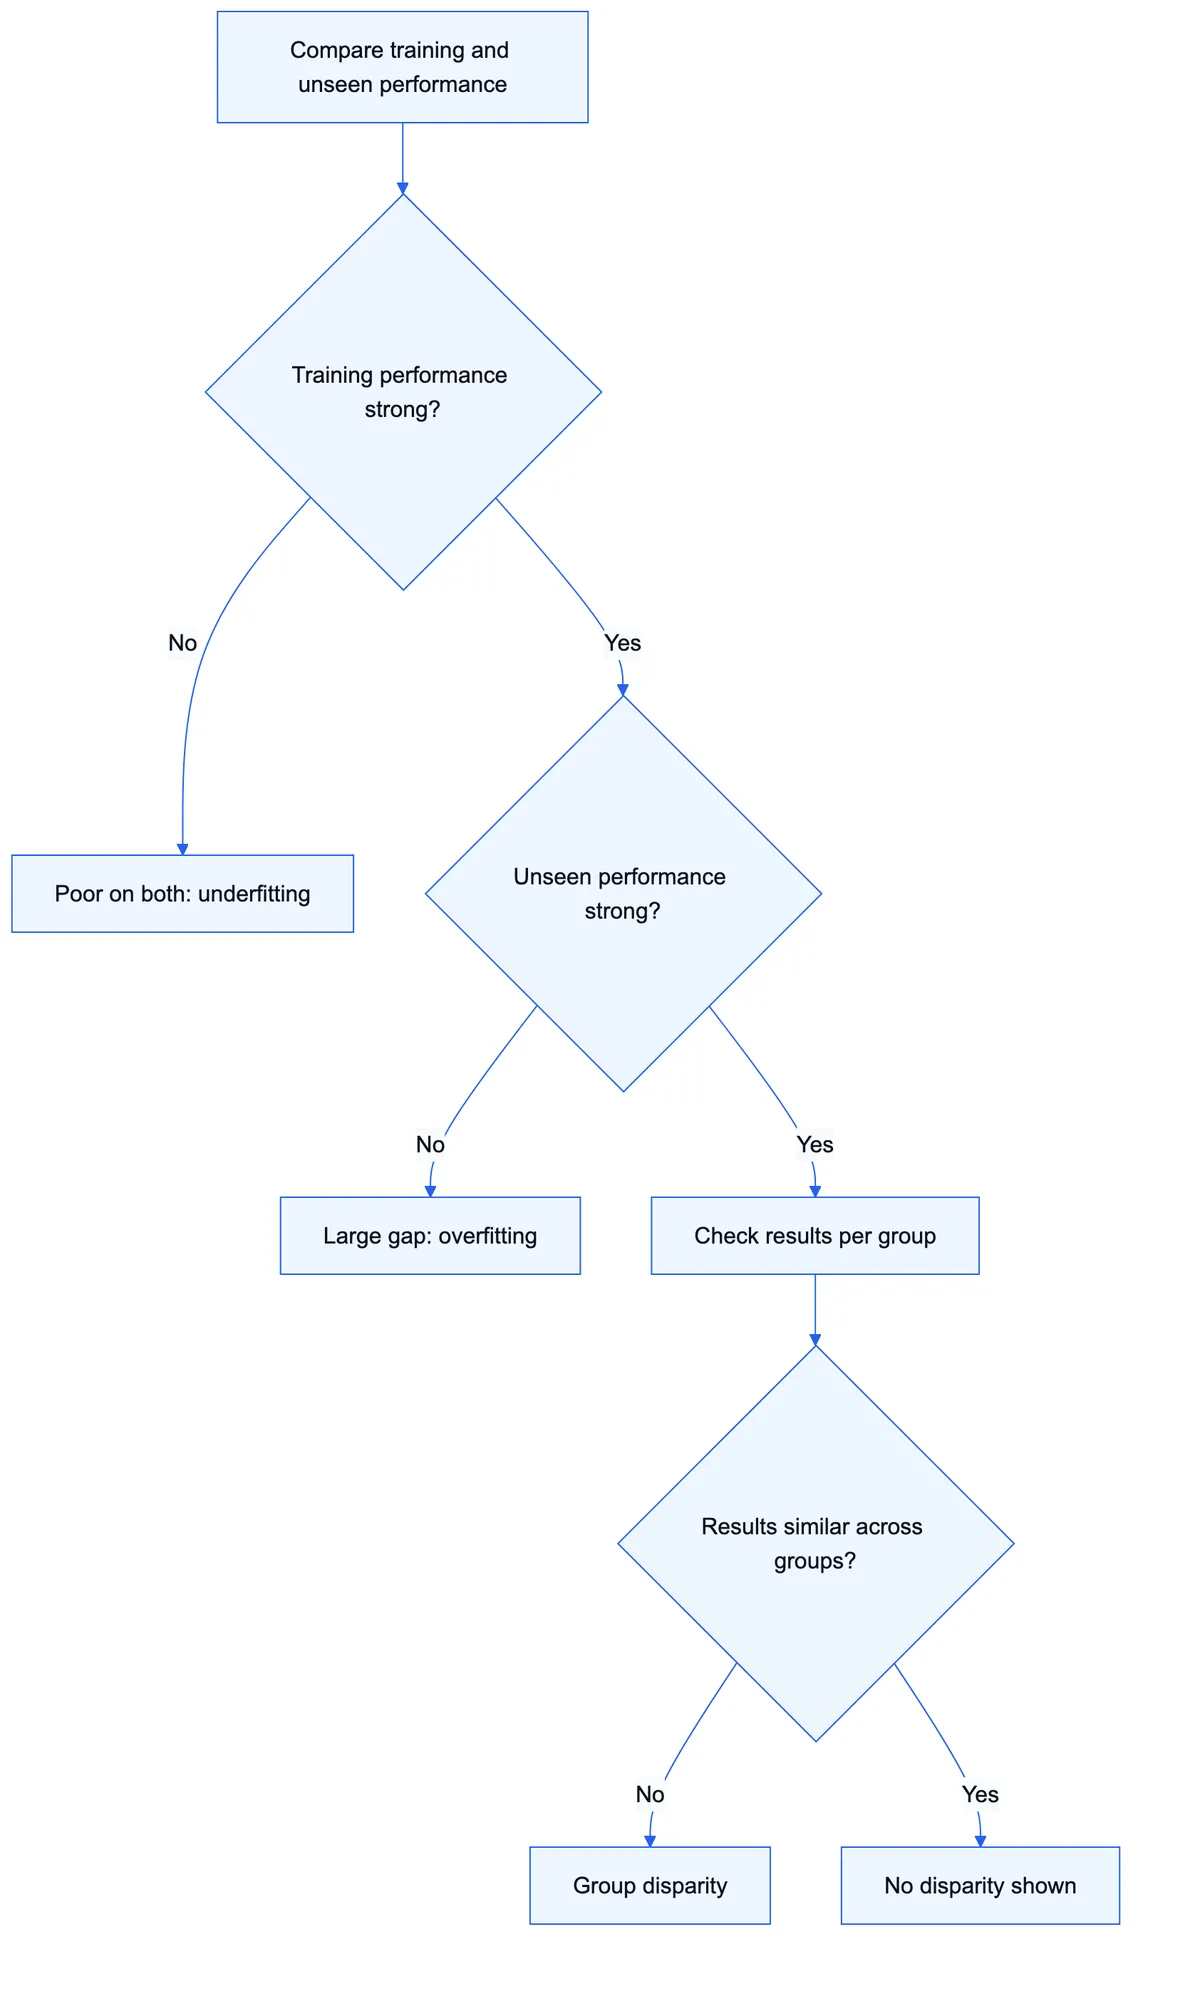
ملاک تعیینکننده در اینجا «شکاف» است: عملکرد قوی در آموزش در کنار عملکرد ضعیف در دادههای دیدهنشده. این تفکیک مانع از یک اشتباه رایج در آزمون میشود: اینکه هر تفاوت عملکرد بین گروهها را «بیشبرازش» بنامیم. بیشبرازش توصیفکننده حساسیت به مجموعه آموزش است؛ این به معنای آن نیست که مدل در گروههای مختلف عملکرد متفاوتی دارد.
برای سادهسازی تشخیص، متخصصان AWS از این ماتریس عملکرد استفاده میکنند:
- کمبرازش (سوگیری آماری بالا): عملکرد ضعیف در آموزش + عملکرد ضعیف در دادههای دیدهنشده.
- بیشبرازش (واریانس بالا): عملکرد قوی در آموزش + عملکرد ضعیف در دادههای دیدهنشده.
- برازش سالم: عملکرد قوی در آموزش + عملکرد قوی در دادههای دیدهنشده.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت و پایداری مدلهای زبانی اشاره کردیم، تکیه بر یک عدد واحد برای سنجش کیفیت، ریسکهای پنهانی دارد. برای مثال، اگر مدلی تقریباً تمام نمونههای آموزش را درست جواب دهد اما در نمونههای جدید خطا کند، این نشانهی سلامت نیست، بلکه نشانه بیشبرازش است. اما اگر مدل در هر دو مجموعه عالی باشد ولی دقتش برای یک گروه دموگرافیک خاص بهشدت پایین بیاید، نه کمبرازش است و نه بیشبرازش؛ مدل در مجموع بهخوبی برازش شده اما ناعادلانه است.
ویژگیهای مجموعه داده و ریشه نابرابری
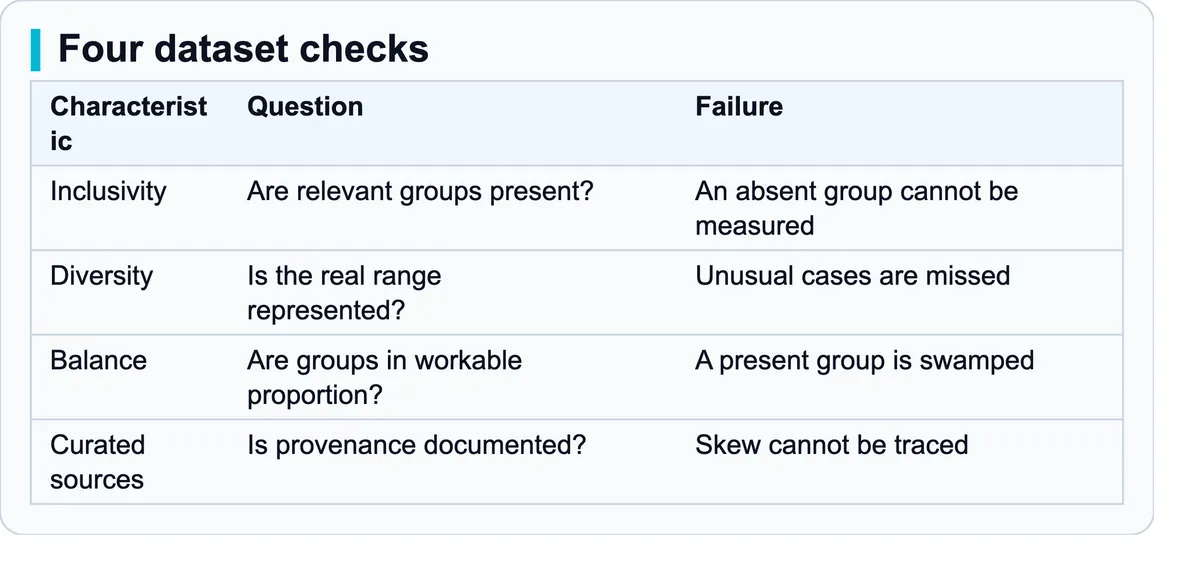
سوگیری اغلب پیش از نوشتن اولین خط کد، در دادهها شکل میگیرد. AWS سلامت دادهها را به چهار ویژگی تقسیم میکند زیرا هر کدام به پرسش متفاوتی پاسخ میدهند:
- شمولیت (Inclusivity): میپرسد آیا گروههایی که سیستم قرار است به آنها خدمات دهد، اصلاً در دادهها حضور دارند؟ اگر گروهی رکورد نداشته باشد، مدل نمیتواند از آن یاد بگیرد و هیچ ردیفی برای محاسبه عملکرد آن گروه وجود نخواهد داشت.
- تنوع (Diversity): میپرسد آیا دادهها طیف واقعی موارد، شرایط و زمینهها را پوشش میدهند؟ ممکن است همه گروههای نامبرده حضور داشته باشند اما دادهها فقط موارد معمولی را پوشش دهند و مدل در لبههای داده (Edge Cases) غیرقابلاعتماد شود.
- توازن (Balance): میپرسد آیا گروههای موجود با نسبتهای مناسب حضور دارند؟ یک گروه ممکن است حضور داشته باشد اما تعدادش آنقدر کم باشد که تأثیری روی هدف آموزش (Training Objective) نگذارد.
- کیوریتوریشن (Curation): اشاره به منابعی با منشأ شناختهشده، انتخابشده و مستند دارد. کیوریتوریشن باعث میشود منشأ داده قابل بررسی باشد، اما بیطرفی را تضمین نمیکند.
تصور کنید مجموعهای دارید با ۴۰,۰۰۰ رکورد از یک گروه و ۳۰۰ رکورد از گروه دیگر. گروه دوم حضور دارد، پس شکست در شمولیت نیست، بلکه شکست در توازن است: گروه نماینده دارد اما در میان حجم زیاد دادهها غرق شده است. در مقابل، اگر گروه دوم هیچ رکوردی نداشته باشد، «متوازن کردن دادهها» هنوز پاسخ کافی نیست چون رکوردی برای وزندهی وجود ندارد؛ ابتدا باید داده از گروه مفقود جمعآوری شود.
کیوریتوریشن را بهراحتی میتوان اشتباه گرفت. مجموعهای که با دقت مستند شده اما فقط از یک جمعیت محدود جمعآوری شده، همزمان میتواند «کیوریت شده» و «سوگیرانه» باشد. کیوریتوریشن به شما کمک میکند بفهمید مجموعه داده نماینده چیست، اما لزوماً آن نمایش را منصفانه نمیکند. علاوه بر این، سوگیری میتواند از طریق جمعآوری، برچسبگذاری، آموزش، استقرار یا بازخورد وارد شود. برای مثال، بازبینهای ناسازگار ممکن است برچسبهای متفاوتی به موارد مشابه بدهند. در چنین حالتی، متوازن کردن دادهها مشکل برچسبهای پیشداورانه یا ناسازگار را حل نمیکند؛ بلکه خودِ برچسبها نیاز به تحلیل دارند.
چرا صحت کلی یک فریب است
یک معیار کلی صرفاً یک میانگین است. این معیار میتواند عملکرد کلی را توصیف کند بدون اینکه فاش کند این عملکرد چگونه توزیع شده است. برای مثال، مدلی با صحت کلی ۹۴٪ ممکن است برای یک گروه اقلیت بهطور کامل شکست بخورد اما از نظر ریاضی همچنان «صحیح» باشد. هیچ چیز در عدد کلی به این پرسش پاسخ نمیدهد: «مدل برای چه کسی کار میکند؟»
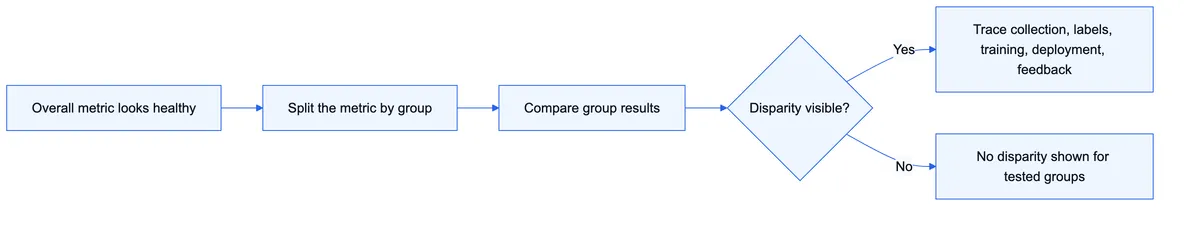
برای افشای این شکستهای پنهان، باید از تحلیل زیرگروهی (Subgroup Analysis) استفاده کرد. این یک محصول نیست، بلکه یک عادت اندازهگیری است که شامل محاسبه جداگانه معیارها برای هر گروه مرتبط است. ترتیب درست در سناریوهای عملیاتی چنین است:
۱. رد کردن صحت کلی بهعنوان مدرکی برای انصاف.
۲. شناسایی گروههایی که نیاز به مقایسه دارند.
۳. محاسبه مجدد معیار مربوطه برای هر گروه.
۴. ردیابی نابرابری در مراحل جمعآوری، برچسبگذاری، آموزش، استقرار و بازخورد.
۵. انتخاب ابزار تشخیص یا نظارت بر اساس زمان وقوع.
حذف ویژگیهای دموگرافیک راهکار مطمئنی نیست. ویژگیهای دیگر ممکن است بهعنوان «متغیرهای جایگزین» (Proxy Variables) عمل کنند، به این معنی که اطلاعاتی مرتبط با ویژگی حذفشده را حمل میکنند. همچنین حذف این ویژگیها، فیلد مورد نیاز برای محاسبه معیارهای هر گروه را از بین میبرد و تشخیص نابرابری را بدون حذف علت آن، سختتر میسازد. قضاوت انسانی همچنان اهمیت دارد زیرا کسی باید تصمیم بگیرد کدام گروهها با هم مقایسه شوند؛ یک معیار فقط میتواند نابرابریهایی را افشا کند که برای اندازهگیری آنها پیکربندی شده است.
تطبیق ابزارها با چرخه حیات مدل
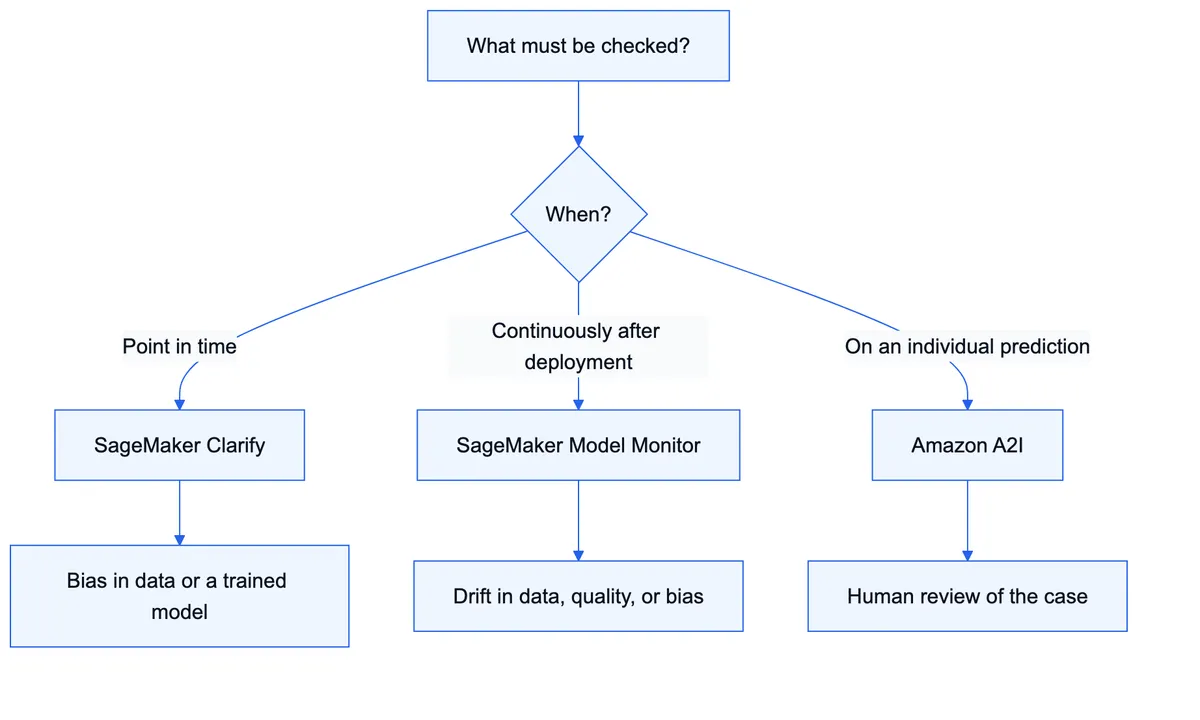
انتخاب ابزار درست در AWS کاملاً به زمانبندی بستگی دارد — یعنی اینکه بررسی در چه زمانی نسبت به استقرار (Deployment) رخ میدهد. این ابزارها جایگزین یکدیگر نیستند.
Amazon SageMaker Clarify برای اندازهگیریهای نقطهای (Point-in-time) است. این ابزار میتواند سوگیری را در دادهها (قبل از آموزش) و در مدل آموزشدیده (بعد از آموزش) ارزیابی کند. همچنین «تخصیص ویژگیها» (Feature Attributions) را تولید میکند. وقتی سناریو میپرسد «آیا مجموعه داده آموزشی یا مدل آموزشدیده در حال حاضر سوگیره هستند»، بهویژه قبل از استقرار، Clarify انتخاب اول است.
SageMaker Model Monitor برای نظارت مستمر است. این ابزار مدل مستقر شده را بهطور مداوم برای تغییر در دادهها، کیفیت مدل و سوگیری نسبت به یک خط مبنا (Baseline) میپاید. عباراتی مثل «از زمان عرضه»، «رانش» (Drift) و «نظارت مداوم» نشانه استفاده از Model Monitor است و آن را از Clarify متمایز میکند. برای مدیریت ریسکهای استقرار، میتوان از روشهایی مانند استفاده از Feature Flagها برای جلوگیری از شکستهای هزینهبر در عرضه مدل بهره برد تا اثرات تغییرات مدل پیش از پذیرش کامل، کنترل شود.
Amazon Augmented AI (Amazon A2I) پیشبینیهای تکی را مدیریت میکند. این ابزار پیشبینیهایی را که در زمان استنتاج (Inference) اطمینان مدل در آنها پایین است، برای بازبین انسانی میفرستد. A2I زمانی انتخاب میشود که یک پیشبینی یا کاربرد خاص به قضاوت انسانی نیاز داشته باشد. آن را برای محاسبه نابرابری در سطح جمعیت انتخاب نکنید؛ A2I یک تصمیم انسانی برای یک مورد خاص تولید میکند، نه یک معیار سوگیری در میان گروهها.
دو روش دیگر این مجموعه را کامل میکنند:
- تحلیل کیفیت برچسب (Label Quality Analysis): بررسی اینکه آیا برچسبها درست و سازگار هستند. زمانی استفاده میشود که شواهدی از استانداردهای متناقض بازبینها وجود داشته باشد یا سوگیری در هدف آموزش (Training Target) کدگذاری شده باشد. این رویکرد مشابه استفاده از تستهای رگرسیون در چارچوب AIDDSkeleton است که برای اعتبارسنجی حاکمیت مدل و تبدیل دستورالعملها به کدهای اجرایی به کار میرود.
- ممیزی انسانی (Human Audits): برای مواردی که نیاز به قضاوتی است که هیچ معیاری آن را ثبت نمیکند. این ممیزیها نقاط کوری را بررسی میکنند که بر اثر انتخاب معیارهای اندازهگیری ایجاد شدهاند.
قانون انتخاب سریع
برای اجتناب از گزینههای گمراهکننده، از این قانون فشرده استفاده کنید:
- ارزیابی دادههای آموزش یا مدل آموزشدیده در حال حاضر $\rightarrow$ SageMaker Clarify
- رصد تغییرات بعد از استقرار $\rightarrow$ SageMaker Model Monitor
- ارسال یک پیشبینی برای بررسی انسانی $\rightarrow$ Amazon A2I
- مقایسه عملکرد بین گروهها $\rightarrow$ تحلیل زیرگروهی (Subgroup analysis)
- بررسی اهداف ناسازگار یا پیشداورانه $\rightarrow$ تحلیل کیفیت برچسب (Label quality analysis)
- بررسی نگرانیهایی که هیچ معیاری برایشان تعریف نشده $\rightarrow$ ممیزی انسانی (Human audit)
تحلیل: تغییر به سمت حاکمیت چرخه حیات
این چارچوب نشاندهنده تغییری در رویه هوش مصنوعی از حاکمیت «مدلمحور» به حاکمیت «چرخه-حیات-محور» است. AWS با اجبار به تمایز بین برازش (آماری) و انصاف (اجتماعی)، توسعهدهندگان را سوق میدهد تا از برخورد با هوش مصنوعی بهعنوان یک «جعبه سیاه» دست بردارند و آن را بهعنوان خط لولهای از مراحل قابل بررسی ببینند.
برای متخصصان، این بدان معنای آن است که دوران «جمعآوری دادههای بیشتر» بهعنوان یک راهکار جهانی به پایان رسیده است. جمعآوری بیشتر از همان جمعیت، همان سوگیری را تکرار میکند؛ اقدام اصلاحی باید افزودن موارد یا گروههای مرتبط باشد. به همین ترتیب، استفاده از Clarify برای نظارت جاری، زمانبندی را نادیده میگیرد، زیرا Clarify نقطهای است. استفاده از Model Monitor روی یک مجموعه داده آموزشی یک خطای دستهبندی است، زیرا هنوز رفتار Endpoint برای نظارت وجود ندارد.
برای بهکارگیری این قوانین، ابتدا با ممیزی شکاف عملکرد آموزش-در-مقابل-آزمون شروع کنید تا بیشبرازش را رد کنید و سپس به سراغ تحلیل زیرگروهی برای بررسی انصاف بروید. به یاد داشته باشید که این قوانین به انتخاب روشهای تشخیص کمک میکنند، اما ثابت نمیکنند که مدل منصف است. انصاف همچنان به این بستگی دارد که کدام گروهها بررسی شدهاند، آیا برچسبها منعکسکننده جمعیت استقرار هستند و آیا بازبینهای انسانی به دنبال آسیبهایی بودهاند که معیارهای انتخابی قادر به بیان آنها نبودند.
گام بعدی شما
- شکاف عملکرد بین مجموعه آموزش و آزمون را بررسی کنید تا ابتدا بیشبرازش را رد کنید.
- برای هر ویژگی حساس، تحلیل زیرگروهی را جایگزین تکیه بر صحت کلی کنید.
- اگر مدل شما در محیط عملیاتی است، برای شناسایی رانش دادهها (Drift) از Model Monitor استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو