تصور کنید یک عامل هوش مصنوعی در رزومهی شما، مهارتی را ادعا کند که هرگز یاد نگرفتهاید یا پروژهای را اختراع کند که وجود ندارد. در دنیای حرفهای، جایی که اعتماد تنها ارز واقعی است، یک توهم کوچک میتواند اعتبار سالها تلاش یک متخصص را در چند ثانیه نابود کند. وقتی یک هوش مصنوعی پروژهای خیالی میسازد، مهارتی غیرموجود را ادعا میکند یا کارفرمای قبلی را توهم میزند، صرفاً یک پاسخ اشتباه نداده است، بلکه فعالانه به اعتبار حرفهای توسعهدهندهای که قرار است نمایندهاش باشد، آسیب میزند. این چالش با یافتههای اخیر همسو است که نشان میدهد مدلهای هوش مصنوعی در بیش از ۷۰ درصد موارد دادههای مفقود را جعل میکنند و همین موضوع ضرورت ایجاد لایههای کنترلی را دوچندان میکند.
بسیاری از پیادهسازیهای فعلی مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — برای «مفید بودن» و «روان صحبت کردن» بهینه شدهاند، نه برای دقت مطلق. این یک نقص بنیادی در طراحی است که در آن روانی متن بر صحت واقعیتها اولویت دارد. برای حل این مشکل، رویکردی به نام «شکست بسته» یا Fail-Closed طراحی شده است؛ فلسفهای که میگوید: «هر جمله باید منبعی داشته باشد، وگرنه نباید گفته شود». این قانون مطلق تعریفکنندهی سیستمی است که در آن مدل اجازه ندارد بدون استناد به منابع کنترلشده، حتی یک کلمه بر زبان بیاورد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر احتمال در سیستمهای حساس یک ریسک است. در این معماری، مدل دیگر «منبع حقیقت» نیست، بلکه تنها یک «موتور قالببندی» است. هدف این است که مدل در هر دو طرف محصور شود تا هرگز کلمهی نهایی دربارهی آنچه به کاربر ارائه میشود، در اختیار او نباشد. در کنار این ریسکهای ساختاری، حفرههای امنیتی در متادیتای ابزارها نیز میتواند مسیر استدلال عاملهای هوشمند را به خطر اندازد. طبق مستندات این پروژه، پشتهی فنی سیستم شامل Mastra برای مدیریت گردشکار (Workflow Orchestration)، Neo4j برای گراف دانش (Knowledge Graph) — شبیه به یک نقشهی شبکهای از مفاهیم که روابط بین اشیا را دقیقاً تعریف میکند — و مدلهای سازگار با OpenAI برای ترکیب نهایی دادهها و میزبان Railway برای استقرار است.
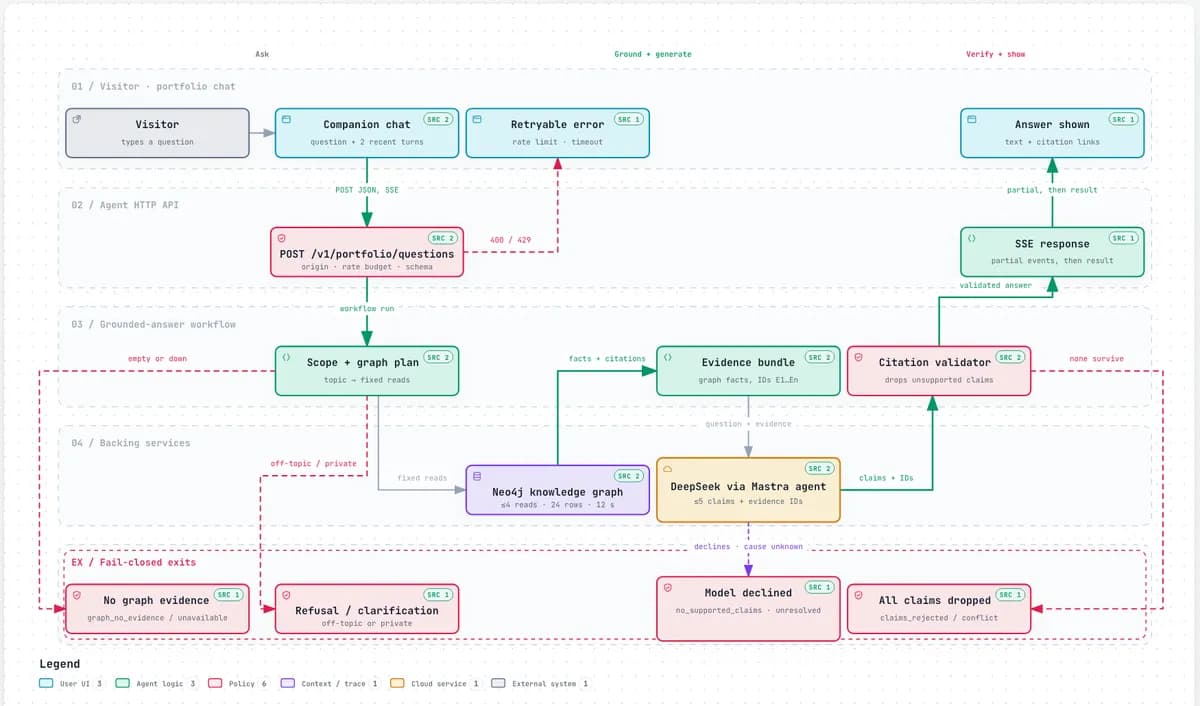
برخلاف سیستمهای رایج تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — که صرفاً تکههایی از متن را به مدل میدهند و امیدوارند جواب درست باشد، این سیستم یک خط لولهی سختگیرانه دارد:
- بررسی محدوده (Scope Check): ابتدا بررسی میشود که آیا سؤال کاربر اصلاً به حوزهی کاری و آثار عمومی توسعهدهنده مربوط است یا خیر. اگر سؤال خارج از این محدوده باشد، فرآیند متوقف میشود.
- برنامهریزی گراف: اگر سؤال تأیید شود، سیستم به مرحلهی برنامهریزی گراف میرود. بهجای اجازه دادن به مدل برای پرسوجوی آزاد و دلخواه از دیتابیس، از دستورات خواندنِ گرافِ ثابت و پیشنویس شده استفاده میشود. این کار مانع از آن میشود که مدل برای یافتن الگوهایی که وجود ندارند، در دیتابیس «ماهیگیری» کند.
- جستوجوی محدود: برای ارتقای سیستم، یک قابلیت جستوجوی وب اختیاری ادغام شده است، اما این جستوجو بهشدت به دامنههای مورد اعتماد محدود شده و هرگز نمیتواند دادههای اصلی گراف دانش را بازنویسی یا نادیده بگیرد.
نقطهی عطف این سیستم، «اعتبارسنجکنندهی استنادات» (Citation Validator) است. به نقل از نویسنده، این بخش اصلاً توسط هوش مصنوعی مدیریت نمیشود، بلکه یک کد برنامهنویسی ساده (Plain Code) است. فرآیند به این صورت است که مدل ابتدا ادعاها را مینویسد، اما با یک محدودیت حیاتی: هر ادعا باید شناسههای (ID) دقیق شواهدی را که به آنها تکیه کرده است، لیست کند. سپس اعتبارسنج، این شناسهها را با واقعیتهای بازیابیشده تطبیق میدهد؛ اگر ادعایی توسط یک شناسه متناظر در دادههای منبع تأیید نشود، آن ادعا بهطور کامل حذف میشود. اگر در نهایت هیچ جملهای از این فیلتر رد نشود، عامل بهسادگی پاسخ میدهد: «اطلاعات تأییدشدهی کافی وجود ندارد». این مکانیسم تضمین میکند که مدل بهجای «تولیدکننده محتوا»، صرفاً به عنوان «ترکیبکنندهی واقعیتها» عمل کند.
برای ساخت پایگاه دانش، نیازی به نوشتن یک دیتابیس مجزا و تکراری نبود. در عوض، نویسنده از فایلهای دادهی موجود در سایت پورتفولیو، مانند portfolio.ts و resume.tsx و همچنین پاسخهای آماده در companion.ts استفاده کرد. این رویکرد در کنار ابزارهای مدرن توسعه، مشابه تلاشهایی است که برای دستیابی به دسترسیپذیری ۱۰۰ درصدی در پورتفولیوها با استفاده از Claude Code صورت میگیرد تا کیفیت خروجی نهایی تضمین شود. با تبدیل این فایلهای ساختاریافته به یک گراف دانش در Neo4j، سیستم میتواند روابط بین پروژهها، فناوریها و نقشهای شغلی را با دقت پیمایش کند. این رویکرد گرافمحور اجازه میدهد پرسوجوهای پیچیدهتری نسبت به جستوجوی برداری ساده انجام شود؛ مثلاً سیستم میتواند دقیقاً ردیابی کند که «کدام پروژهها هم از انگولار استفاده کردهاند و هم در سال ۲۰۲۲ تکمیل شدهاند؟» بدون اینکه به ماهیت احتمالی بردار معنایی (Embedding) — که صرفاً همسایگی معنایی را نشان میدهد — تکیه کند.
در نهایت، مدیریت خطاها نیز بر اساس اصل Fail-Closed است. سیستم بهگونهای طراحی شده که در هر شرایطی «بسته» شود. چه شکست در بررسی محدوده باشد، چه نبود شواهد تأییدشده و چه سقوط زیرساختهای فنی، کاربر همواره یک پاسخ ردِ مودبانه و سازگار دریافت میکند. برای حفظ سلامت سیستم بدون به خطر انداختن حریم خصوصی، خطاهای زیرساختی از طریق ایمیل به توسعهدهنده گزارش میشوند. این هشدارها برای جلوگیری از اسپم، به یک بار در ساعت برای هر دلیل محدود شدهاند و نکتهی حیاتی این است که هرگز سؤال خاص بازدیدکننده را در ایمیل نمیگنجانند تا حریم خصوصی کاربر حتی در زمان عیبیابی (Debugging) حفظ شود.
این رویکرد، نقش LLM را از «منبع حقیقت» به «موتور قالببندی» تغییر میدهد. مدل وظیفه دارد تکههای تأییدشدهی اطلاعات را بگیرد و آنها را به پاسخی طبیعی تبدیل کند، اما اختیار تصمیمگیری دربارهی اینکه چه چیزی «درست» است از او گرفته شده است. با پیادهسازی یک لایهی اعتبارسنجی سختافزاری (Hard-coded)، ریسک توهمات بهطور کامل حذف میشود. درس برای هر کسی که یک عامل حرفهای میسازد روشن است: به صداقت مدل اعتماد نکنید؛ در عوض، سیستمی بسازید که در آن دروغ گفتن برای مدل از نظر ریاضی غیرممکن باشد. این کار تجربهای ایجاد میکند که بازدیدکننده میتواند به هر کلمه اعتماد کند، زیرا هر پاسخ با لینکهای مستقیم به شواهد پشتیبانی میشود و جعبهی چت را از یک ریسک احتمالی به ابزاری قدرتمند برای تأیید اعتبار حرفهای تبدیل میکند.
برای ساخت پایگاه دانش، نیازی به نوشتن یک دیتابیس مجزا و تکراری نبود. در عوض، نویسنده از فایلهای دادهی موجود در سایت پورتفولیو، مانند portfolio.ts و resume.tsx و همچنین پاسخهای آماده در companion.ts استفاده کرد. با تبدیل این فایلهای ساختاریافته به یک گراف دانش در Neo4j، سیستم میتواند روابط بین پروژهها، فناوریها و نقشهای شغلی را با دقت پیمایش کند. این رویکرد گرافمحور اجازه میدهد پرسوجوهای پیچیدهتری نسبت به جستوجوی برداری ساده انجام شود؛ مثلاً سیستم میتواند دقیقاً ردیابی کند که «کدام پروژهها هم از انگولار استفاده کردهاند و هم در سال ۲۰۲۲ تکمیل شدهاند؟» بدون اینکه به ماهیت احتمالی بردار معنایی (Embedding) — که صرفاً همسایگی معنایی را نشان میدهد — تکیه کند.
در نهایت، مدیریت خطاها نیز بر اساس اصل Fail-Closed است. سیستم بهگونهای طراحی شده که در هر شرایطی «بسته» شود. چه شکست در بررسی محدوده باشد، چه نبود شواهد تأییدشده و چه سقوط زیرساختهای فنی، کاربر همواره یک پاسخ ردِ مودبانه و سازگار دریافت میکند. برای حفظ سلامت سیستم بدون به خطر انداختن حریم خصوصی، خطاهای زیرساختی از طریق ایمیل به توسعهدهنده گزارش میشوند. این هشدارها برای جلوگیری از اسپم، به یک بار در ساعت برای هر دلیل محدود شدهاند و نکتهی حیاتی این است که هرگز سؤال خاص بازدیدکننده را در ایمیل نمیگنجانند تا حریم خصوصی کاربر حتی در زمان عیبیابی (Debugging) حفظ شود.
این رویکرد، نقش LLM را از «منبع حقیقت» به «موتور قالببندی» تغییر میدهد. مدل وظیفه دارد تکههای تأییدشدهی اطلاعات را بگیرد و آنها را به پاسخی طبیعی تبدیل کند، اما اختیار تصمیمگیری دربارهی اینکه چه چیزی «درست» است از او گرفته شده است. با پیادهسازی یک لایهی اعتبارسنجی سختافزاری (Hard-coded)، ریسک توهمات بهطور کامل حذف میشود. درس برای هر کسی که یک عامل حرفهای میسازد روشن است: به صداقت مدل اعتماد نکنید؛ در عوض، سیستمی بسازید که در آن دروغ گفتن برای مدل از نظر ریاضی غیرممکن باشد. این کار تجربهای ایجاد میکند که بازدیدکننده میتواند به هر کلمه اعتماد کند، زیرا هر پاسخ با لینکهای مستقیم به شواهد پشتیبانی میشود و جعبهی چت را از یک ریسک احتمالی به ابزاری قدرتمند برای تأیید اعتبار حرفهای تبدیل میکند.
گام بعدی شما
- اگر عامل هوش مصنوعی برای کسبوکار خود میسازید، لایهی اعتبارسنجی را از مدل جدا کرده و به کد سخت (Hard-coded) منتقل کنید.
- بهجای تکیه بر جستوجوی برداری ساده، برای دادههای ساختاریافته از گراف دانش استفاده کنید تا روابط بین موجودیتها دقیق بماند.
- استراتژی Fail-Closed را جایگزین تلاش مدل برای «همیشه مفید بودن» کنید تا اعتبار برندتان به خطر نیفتد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو