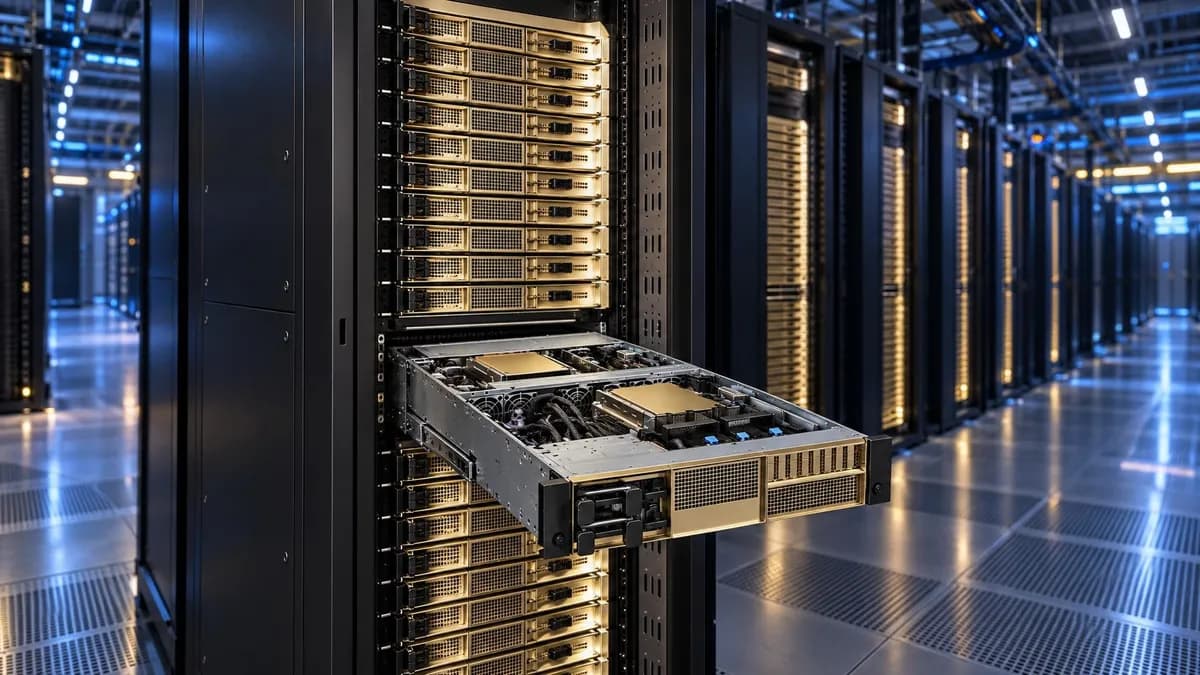
اگر امروز برای اجرای هزاران محیط ایزوله در هر ثانیه با تأخیرهای سختافزاری دستوپنجه نرم میکنید، معماری جدید انویدیا بازی را تغییر میدهد. در حالی که یک لوپ تکعاملی هوش مصنوعی ممکن است هزاران محیط ایزوله را برای یک ساعت فعال کند و سپس برای ساعت بعد کاملاً خاموش شود، CoreWeave با استقرار پردازندههای NVIDIA Vera در مقیاس رک، این تقاضای «انفجاری» (Bursty) را مدیریت میکند. این شرکت گزارش میدهد که زمان راهاندازی محیطهای ایزوله (Sandbox) در این معماری، بیش از ۳ برابر سریعتر از پردازندههای سنتی x86 است.
این تحول در حالی رخ میدهد که صنعت از رابطهای سادهی چت به سمت عاملهای هوش مصنوعی (AI Agents) — شبیه دستیارهای هوشمندی که میتوانند بهجای حرف زدن، واقعاً کارهای پیچیده را در نرمافزارهای مختلف انجام دهند — حرکت میکند. در این ساختار، در حالی که GPUها وظیفهی استدلال و آموزش را بر عهده دارند، کارهای پیرامونی مثل اجرای کد، فراخوانی ابزارها و خط لولههای داده بر دوش CPU میافتد. همانطور که در تحلیل قبلی ما دربارهی ادغام ابزارهای تجاری در عاملهایی مثل Meta Muse اشاره کردیم، صنعت اکنون به یک دیوار سختافزاری برخورد کرده است؛ جایی که پردازندههای همهمنظوره نمیتوانند با سرعت استدلال GPUها همگام شوند و مقیاسپذیری لازم را فراهم کنند.
زمینه: لوپ هوش مصنوعی عاملمحور
به نقل از CoreWeave، هوش مصنوعی عاملمحور از طریق یک لوپ مداوم شامل مراحل «اجرا، مشاهده، سازماندهی، بهبود و ارزیابی» عمل میکند. در این چرخه، GPUها مدیریت آموزش مدل و استدلال را بر عهده دارند. با این حال، CPUها باید کارهای حیاتی پیرامون هر مرحله را مدیریت کنند؛ این وظایف شامل ایجاد محیطهای ایزوله (Sandboxes)، محیطهای یادگیری تقویتی (Reinforcement Learning)، فراخوانی ابزارها، اجرای کد و مدیریت خط لولههای داده است.
تقاضا برای این خط لولههای پیشپردازش و اپیزودهای آموزشی یادگیری تقویتی اغلب بهصورت انفجاری و غیرقابلپیشبینی است. با رشد حجم کارهای پس از آموزش (Post-training) و بارهای کاری عاملمحور، این بخشهای متکی به CPU بهطور فزایندهای سرعت کل لوپ هوش مصنوعی را تعیین میکنند. بنابراین، زیرساختهای مدرن اکنون هم به تراکم بالا برای مدیریت پیکهای تقاضا و هم به انعطافپذیری برای مقیاسپذیری سریع در زمان تغییر تقاضا نیاز دارند. این رویکرد در راستای مدیریت صدها پردازنده Vera Rubin به عنوان یک سیستم واحد است تا بیشترین بهرهوری از سختافزار حاصل شود.
در ۳۰ سپتامبر ۲۰۲۶، در کنفرانس Fully Connected در سانفرانسیسکو، CoreWeave جزئیات ادغام Vera در زیرساختهای خود را فاش کرد. این رویداد که از ۲۹ سپتامبر تا ۱ اکتبر در مرکز Moscone South (واقع در خیابان هوارد ۷۴۷) برگزار شد، بیش از ۴۵۰۰ مشتری، شریک تجاری، توسعهدهنده و رهبر حوزه هوش مصنوعی را گرد هم آورد.
جزئیات: محیطهای ایزوله و استقرار CoreWeave
CoreWeave برای ایجاد لایههای اجرای امن و ایزوله برای یادگیری تقویتی و ارزیابی مدل، از CoreWeave Sandboxes استفاده میکند که در ۱۴ مه ۲۰۲۶ عرضه شد. این پلتفرم مزایای عملیاتی کلیدی زیر را فراهم میکند:
- ایزولاسیون کامل: هر محیط بهصورت پیشفرض در یک محیط مجازی کاملاً ایزوله عمل میکند تا اطمینان حاصل شود که شکست یا اجرای خارج از کنترل یک فرآیند در یک محیط، به محیطهای دیگر سرایت نکند.
- گزینههای استقرار: این سرویس از طریق سرویس کوبرنتیز CoreWeave یا بهصورت یک زمان اجرای بدون سرور (Serverless Runtime) از طریق Weights & Biases در دسترس است.
- ابزارهای توسعه: یک SDK پایتون برای مدیریت نشستها (Session Management)، یکپارچهسازی ذخیرهسازی و ابزارهای نظارتی در این بسته گنجانده شده است.
- جایگذاری سختافزاری: محیطهای ایزوله مستقیماً در کنار کارهای آموزشی که از آنها پشتیبانی میکنند قرار میگیرند تا تأخیر (Latency) به حداقل برسد.
چن گلدبرگ، نایبرئیس اجرایی محصول و مهندسی در CoreWeave، اظهار داشت که زیرساختهای همهمنظوره باعث ایجاد گلوگاه در هوش مصنوعی عاملمحور میشوند و Vera نخستین پردازندهای است که صراحتاً برای شتابدهی به این حوزه طراحی شده است. رایان شروت، رئیس و مدیر کل Signal65 نیز افزود که سهم هر چرخه عامل از کارهای CPU در حال افزایش است و تفاوت عملیاتی اصلی در اجرای این کدها روی سختافزار Bare Metal در کنار خوشههای آموزشی نهفته است.
مشخصات فنی استقرار Vera
استقرار Vera در مقیاس رک توسط CoreWeave برای تراکم و ایزولاسیون حداکثری طراحی شده است:
- ظرفیت: در یک رک واحد، ۱۲۸ پردازنده و ۱۱۲۶۴ هسته جای میگیرند.
- همزمانی: این پیکربندی از بیش از ۱۱۰۰۰ محیط ایزوله همزمان پشتیبانی میکند.
- اتصالات: گرهها از طریق BlueField-4 DPUs و سوئیچهای Spectrum-X Ethernet به یکدیگر متصل شدهاند.
طبق مستندات فنی انویدیا، پردازنده Vera دارای ۸۸ هسته سفارشی Olympus و قابلیت Multithreading فضایی است که ۱۷۶ رشته (Thread) با منابع هستهای تقسیمبندی شده ایجاد میکند. این پردازنده از حافظه LPDDR5X با پهنای باند تا ۱.۲ ترابایت بر ثانیه و ظرفیت حافظه ۱.۵ ترابایت استفاده میکند. انویدیا اشاره میکند که این زیرسیستم حافظه، ۲ برابر پهنای باند کلی و ۳ برابر پهنای باند بهازای هر هسته را نسبت به پردازندههای پیشرو x86 با DDR5 ارائه میدهد.
برای سیستمهای ردهبالا، پلتفرم Vera Rubin NVL72 مجموعهای از ۷۲ پردازنده گرافیکی Rubin، ۳۶ پردازنده Vera، کارتهای شبکه ConnectX-9 SuperNICs و BlueField-4 DPUs را در یک رک ترکیب میکند. علاوه بر این، رکهای پردازنده Vera که بر پایه NVIDIA MGX ساخته شدهاند، میتوانند تا ۲۵۶ پردازنده Vera را برای اجرای بیش از ۲۲۵۰۰ محیط همزمان جای دهند.
انویدیا ادعا میکند Vera زنجیرههای ابزار پایتون، کامپایل و تحلیل کد را تا ۱.۸ برابر سریعتر از پردازندههای پیشرو x86 اجرا میکند. این موفقیت از طریق نسل دوم Scalable Coherency Fabric با پهنای باند ۳.۴ ترابایت بر ثانیه و NVLink-C2C برای پهنای باند منسجم تا ۱.۸ ترابایت بر ثانیه بین CPU و GPU حاصل شده است.
همزمان با سختافزار، CoreWeave در ۳۰ سپتامبر ۲۰۲۶ سرویس CoreWeave Forge را معرفی کرد. Forge بهعنوان یک لایه توسعه عمل میکند که کل لوپ هوش مصنوعی — اجرا، مشاهده، سازماندهی، بهبود و ارزیابی — را در یک محیط واحد متصل میکند. این ابزار در واقع یکپارچهسازی چرخه توسعه مدلهای هوش مصنوعی در یک لایه را هدف قرار داده است تا پراکندگی در مراحل توسعه کاهش یابد. پذیرندگان اولیه این پلتفرم، از جمله Canva و MasterClass، در حال حاضر از آن برای ساخت و بهینهسازی عاملهای خود استفاده میکنند.
این حرکت نشاندهنده تغییری بنیادین در نحوه ساخت ابرهای هوش مصنوعی است. CoreWeave پیش از این پیشتازی خود در عملکرد را با اشاره به نتایج بنچمارک MLPerf و جایگاه خود بهعنوان تنها ابر هوش مصنوعی که سه بار متوالی رتبه پلاتینیوم در SemiAnalysis ClusterMAX را کسب کرده، به اثبات رسانده است.
سالها تمرکز تقریباً بهطور انحصاری روی خوشههای GPU بود، اما اکنون «مالیات CPU» در هوش مصنوعی عاملمحور به گلوگاه اصلی تبدیل شده است. CoreWeave با تبدیل CPU از یک میزبان همهمنظوره به یک شتابدهنده تخصصی برای عاملها، روی این موضوع شرطبندی کرده است که انعطافپذیری زیرساخت، عامل تعیینکننده در برنده شدن در مسابقه عاملها خواهد بود.
برای کاربر نهایی، این یعنی عاملها پاسخگوتر میشوند و بدون تأخیرهای مربوط به راهاندازی محیطهای مجازی، قادر به انجام کارهای پیچیده و چندمرحلهای با استفاده از ابزارها خواهند بود. همچنین اصطکاک عملیاتی برای پژوهشگرانی که نیاز به اجرای همزمان هزاران اپیزود یادگیری تقویتی دارند، بهشدت کاهش مییابد.
باید منتظر ماند و دید سایر ارائهدهندگان خدمات ابری چگونه به این رویکرد پردازنده تخصصی پاسخ میدهند و آیا معماری Vera به استاندارد لایه «عاملمحور» در پشته (Stack) هوش مصنوعی تبدیل خواهد شد یا خیر.
گام بعدی شما
- اگر در حال توسعه عاملهای پیچیده هستید، بررسی کنید که آیا گلوگاه شما در استنتاج مدل است یا در زمان اجرای ابزارها و محیطهای ایزوله.
- معماریهای Bare Metal را برای جایگزینی با ماشینهای مجازی در محیطهای تست مدلهای عاملمحور ارزیابی کنید.
- قابلیتهای CoreWeave Forge را برای یکپارچهسازی لوپ «اجرا-مشاهده-بهبود» در جریان کاری خود بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو