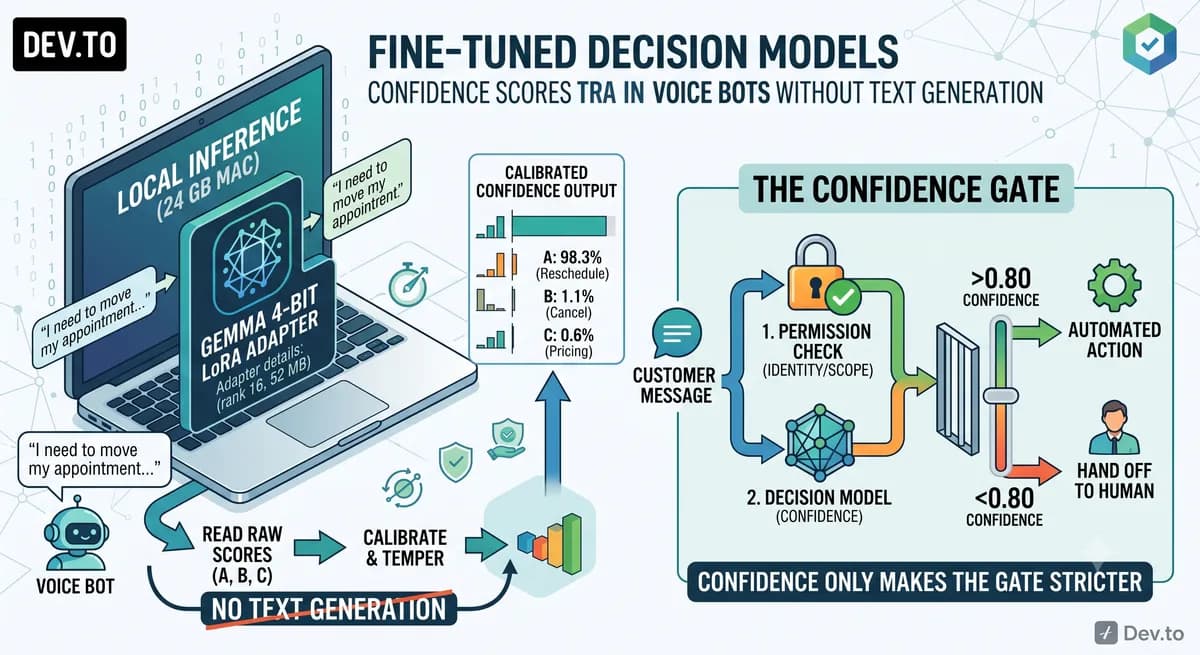
اگر امروز برای اجرای مدلهای زبانی روی لپتاپ خود منتظر میمانید، باید بدانید که تأخیر پاسخدهی میتواند به زیر ۱۰۰ میلیثانیه برسد. یک مدل تصمیمگیر Gemma 4 E2B اکنون قادر است طبقهبندی قصد کاربر (Intent Classification) را تنها در ۸۵ میلیثانیه روی GPU یک مکبوک استاندارد پردازش کند.
این رویکرد، تولید متن سنتی را با پیشبینی یک تکحرف جایگزین میکند و عملاً یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — را به یک موتور طبقهبندی فوقسریع تبدیل میکند. اکثر باتهای صوتی بهدلیل تأخیر در تولید پاراگرافهای طولانی برای فهمیدن خواسته کاربر، دچار مشکل میشوند. اما با تبدیل LLM به یک مدل تصمیمگیر، توسعهدهندگان بهجای تحلیل زبان طبیعی، امتیازات احتمالی خام برای گزینههای مشخص را استخراج میکنند. این تغییر اجازه میدهد سیستمی ایجاد شود که هوش مصنوعی تنها در صورت اطمینان بالا اقدام کند و در غیر این صورت، تسک را به انسان بسپارد.
زمینه و طراحی
همانطور که در بحثهای گذشتهی ما دربارهی بهینهسازی مدلهای لبه اشاره کردیم، کاهش وابستگی به ابر، کلید حریم خصوصی است. شرکت TypeSafe AI این سبک پیادهسازی را «مدلهای تصمیمگیر» نامیده است؛ رویکردی که پیش از این در مدل Jev برای کاهش چشمگیر هزینههای استنتاج مورد بررسی قرار گرفته بود. این نسخه خاص با استفاده از ابزار تنظیم دقیق forge ساخته شده و برخلاف تعاملات استاندارد، مدل آموزش دیده تا دقیقاً با یک حرف پاسخ دهد.
در زمان تست، سیستم اجازه نمینویسد که مدل متنی تولید کند. در عوض، پرامپت یکبار اجرا شده و امتیازات خام برای گزینههای حروف (مثلاً A، B یا C) خوانده و به احتمال تبدیل میشوند. برای اطمینان از اینکه این امتیازات بهدرستی کالیبره شدهاند، یک دمای (Temperature) خاص بر روی مجموعه دادههای اعتبارسنجی تنظیم شده است.
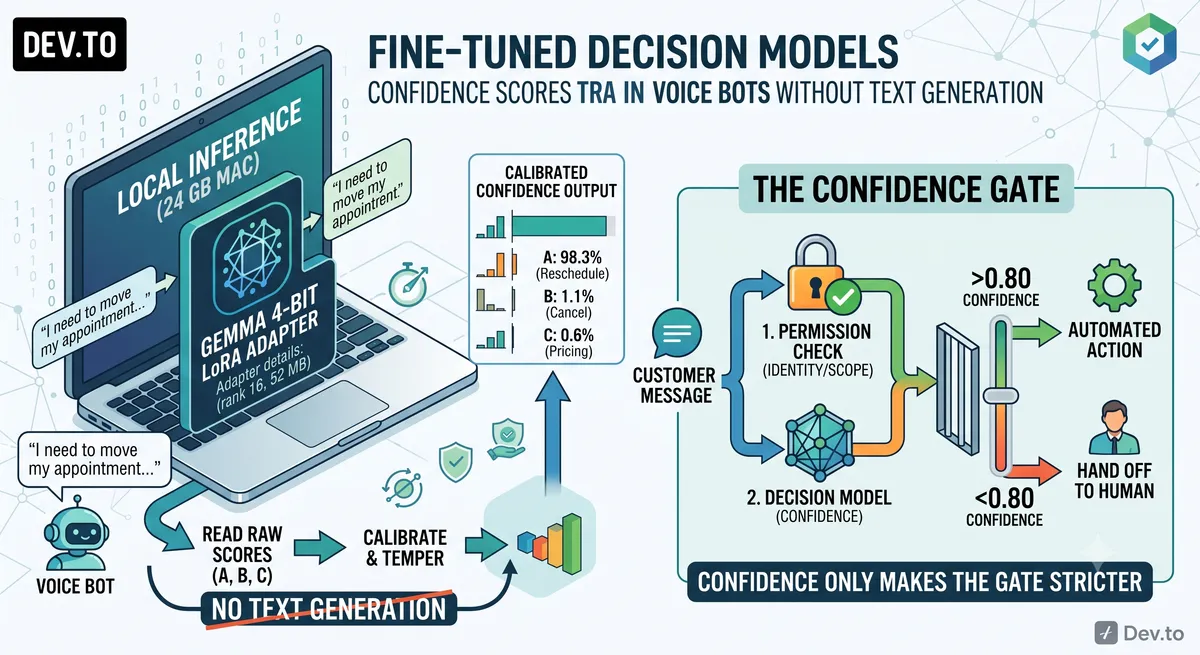
طبق گزارش فنی منتشر شده در ۲ اکتبر ۲۰۲۶، این ساختار از مدل ۴ بیتی Gemma 4 E2B با یک آداپتور لورا (LoRA) — که شبیه به اضافه کردن یک لایه تخصص کوچک به یک دانش کلی است — با رتبه (Rank) ۱۶ و حجم تنها ۵۲ مگابایت استفاده میکند. این مدل روی هفت مجموعه داده عمومی و ردیفهای دادههای مصنوعی آموزش دیده است. این دادههای مصنوعی برای چهار تسک رفتاری توسط یک مدل محلی روی همان مکبوک ایجاد شدهاند. در تمام این فرآیند، هیچ API پولی یا GPU ابری در آن به کار نرفته است.
جزئیات فنی
مشخصات فنی این پیادهسازی عبارت است از:
- پیک مصرف حافظه: ۵.۷ گیگابایت هنگام آموزش.
- زمان آموزش: تقریباً یک ساعت روی مکبوک ۲۴ گیگابایتی.
- تأخیر: میانگین ۸۵ میلیثانیه برای هر تصمیم (p95 برابر با ۱۱۷ میلیثانیه).
- کالیبراسیون: نرخ خطای بین ۰.۰۰۶ تا ۰.۰۴ در اکثر تسکها روی ۶۸,۰۰۰ ردیف آزمون.
برای تضمین استواری، توسعهدهنده سه مکانیزم خاص را اجرا کرده است. اول، جابهجایی (Shuffling) گزینهها در هر ردیف آموزش و بازنویسی سوالات برای جلوگیری از سوگیری مدل نسبت به حروف خاص. دوم، استانداردسازی فرمت که در آن سوالات چندگزینهای به چندین سوال بله/خیر تبدیل میشوند تا فرمت واحد حفظ شود. سوم، خواندن امتیازات در حین پردازش (In-Process Reading)؛ زیرا سرور تنها ۱۱ احتمال برتر (log-probabilities) را برمیگرداند و در لیستهای ۱۳ گزینهای، بخشی از جرم احتمالی (probability mass) از دست میرفت.
به نقل از گزارش مذکور، بیشترین بهبود عملکرد هنگام اعمال آستانه اطمینان ۰.۸ مشاهده شده است. در مجموعه داده CLINC150، صحت (Accuracy) مدل از ۹۰٪ به ۹۸.۳٪ جهش کرد، بهشرطی که مدل برای اقدام کردن، ۸۰٪ مطمئن باشد. نتایج مشابهی در مجموعههای MASSIVE intent (۷۹٪ به ۹۵.۴٪) و BANKING77 (۷۴٪ به ۹۲.۳٪) ثبت شد.
این معماری این فرض بنیادی را که عاملها برای رسیدن به نتیجه باید از طریق متن «استدلال» کنند، تغییر میدهد. با خواندن احتمالات در حین پردازش، ریسک برچسبهای نامعتبر یا خطاهای تجزیه متن حذف میشود و یک مدل مولد عملاً به یک طبقهبندیکننده قطعی تبدیل میگردد. این متدولوژی در واقع پاسخی به این پرسش است که آیا بازرسی خروجیها موثرتر از مهندسی پیچیدهٔ پرامپت است یا خیر، چرا که بر صحت خروجی بهجای پیچیدگی ورودی تمرکز دارد.
درگاه عامل (The Agent Gateway)
در یک درگاه عامل عملیاتی، امتیاز اطمینان بهعنوان یک فیلتر سخت عمل میکند. سیستم ابتدا هویت و مجوزهای محدود شده (scoped permissions) را بررسی میکند. اگر دسترسی رد شود، پردازش متوقف میگردد. در صورت تایید، مدل تصمیمگیر پیام را امتیازدهی میکند. اگر امتیاز زیر آستانه باشد، پیام به انسان ارسال میشود و در غیر این صورت، فرآیند ادامه مییابد.
نکته کلیدی این است که امتیاز مدل میتواند یک دستور «اجرا کن» را به «ارسال به انسان» تبدیل کند، اما هرگز نمیتواند یک وضعیت «رد شده» (Denied) را به «اجرا کن» تبدیل کند. هویت و مجوزها دسترسی اولیه را تعیین میکنند و مدل تنها درگاه را تنگتر میکند.
برای کاربر نهایی، این یعنی عاملهای هوش مصنوعی میتوانند کاملاً بهصورت محلی اجرا شوند و پیامهای مشتری هرگز دستگاه را ترک نکند. این موضوع مزیت بزرگی برای رعایت قوانین حفاظت از دادهها مانند DPDPA است و هزینهها و تأخیرهای APIهای شخص ثالث را حذف میکند.
با این حال، توسعهدهنده به یک ناهنجاری در آموزش اشاره کرده است؛ جایی که تابع زیان (Loss Function) برای ۲۰۰۰ گام اول در نزدیکی ln(26) ثابت میماند — که نشاندهنده حدس تصادفی یکنواخت بین حروف الفبا است — و سپس بهشدت افت میکند. این پلاتو فارغ از تغییرات نرخ یادگیری باقی میماند و پرسشی درباره رفتار همگرایی مدل در مراحل اولیه ایجاد میکند.
توسعهدهندگان اکنون باید بررسی کنند که آیا آستانههای تحویل به انسان (Hand-off thresholds) باید برای هر تسک، هر نوع داده یا هر سطح دسترسی بهطور مجزا تنظیم شوند تا قابلیت اطمینان در محیط عملیاتی بهینه شود. نویسنده در حال حاضر تمایل دارد این آستانهها را بر اساس نوع داده تنظیم کند.
گام بعدی شما
- بررسی کنید که آیا در گردشکارهای خود میتوانید تولید متن را با پیشبینی تکحرفی جایگزین کنید تا تأخیر را کاهش دهید.
- برای بهینهسازی قابلیت اطمینان، آستانههای تحویل به انسان (Hand-off thresholds) را بهجای یک عدد ثابت، بر اساس نوع داده تنظیم کنید.
- مدلهای کوچکتر را با لایههای LoRA برای تسکهای طبقهبندی محلی آزمایش کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو