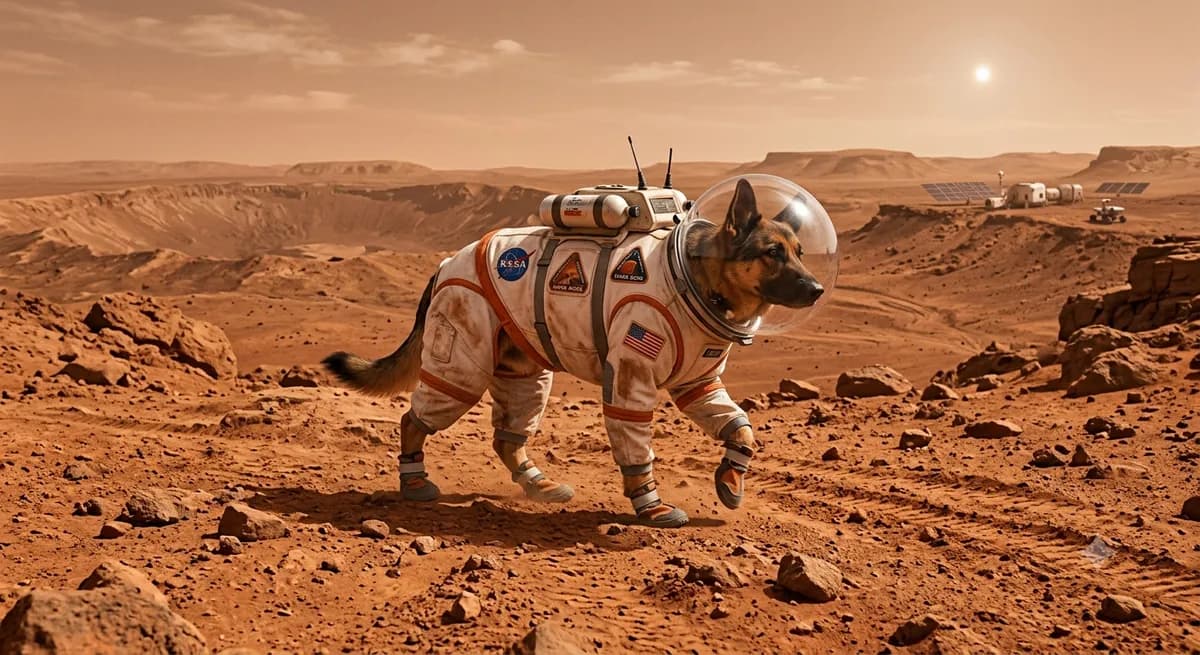
تصور کنید یک جمله ساده بتواند سگی طلاییرنگ با لباس فضانوردی را در حال کاوش در مریخ خلق کند؛ این دیگر جادوی سینمایی نیست، بلکه نتیجهی یک خط لولهی پیچیده است که واقعیت را از نویز ریاضی خالص میسازد. همانطور که در تحلیل فنی منتشر شده در ۲۶ سپتامبر ۲۰۲۶ در وبسایت dev.to آمده است، این قابلیت به جای جستوجو در تصاویر موجود، آنها را از ابتدا سنتز میکند.
بسیاری از کاربران تصور میکنند هوش مصنوعی زاینده (Generative AI) شبیه به یک کلاژ دیجیتال کار میکند که تکههای مختلف را از تصاویر موجود برش داده و کنار هم میچسباند، اما سازوکار واقعی آن بیشتر شبیه به یک فرآیند مجسمهسازی ریاضی است. در این سیستم، مدل ابتدا باید زبان انسان را به یک نقشهی بصری ترجمه کند و سپس بومی از برفکهای تصادفی را به صورت تکرار شونده به یک صحنهی منسجم تبدیل نماید.
پل ارتباطی زبانی
برای شروع، سیستم باید کلمات را به مفاهیم بصری متصل کند و برای این کار از یک رمزگذار متن-تصویر چندوجهی استفاده میکند. CLIP (Contrastive Language-Image Pre-training) متعلق به OpenAI در اینجا نقش یک لغتنامهی جهانی را ایفا میکند که کلمات و تصاویر را روی یک شبکهی ریاضی مشترک قرار میدهد. این معماری از یک رمزگذار متن (Transformer) و یک رمزگذار بینایی (ViT/CNN) استفاده میکند تا بردارهای معنایی (Embedding) ایجاد کند که در یک فضای برداری چندوجهی مشترک با هم تلاقی میکنند.
در طول مرحلهی آموزش، CLIP صدها میلیون جفت تصویر-شرح را که از وب جمعآوری شدهاند، تحلیل کرده است. این مدل یاد گرفته است که هرگاه کلمهی «پُرزدار» در یک شرح ظاهر میشود، تصویر مربوطه معمولاً دارای خز نرم، پر یا ابر است. با گذشت زمان، CLIP این مفاهیم را در یک فضای ریاضی مشترک ترسیم میکند، به طوری که کلماتی با معانی مشابه، مانند «سگ» و «سگسان»، در نزدیکی یکدیگر قرار میگیرند.
وقتی شما یک پرامپت وارد میکنید، رمزگذار متن شما را به یک بردار عددی — یا یک نقشهی راه — تبدیل میکند که دقیقاً جایگاه آن مفاهیم را در فضای بصری مشترک مشخص میکند. این فرآیند تضمین میکند که تصویر یک سگ دقیقاً در کنار کلمهی متنی «سگ» و تصویر یک سیارهی قرمز در کنار کلمهی «مریخ» نقشهبرداری شود.
بهرهوری از طریق فضای نهان
پردازش تکتک پیکسلهای یک تصویر 4K برای تولید آنی از نظر محاسباتی غیرممکن است. اگر یک هوش مصنوعی بخواهد هر پیکسل را به طور همزمان پردازش کند، تولید یک عکس ساعتها زمان میبرد و مقدار عظیمی از قدرت پردازشی را مصرف میکند. برای حل این مشکل، پژوهشگران از مدلهای انتشار نهان (Latent Diffusion Models) استفاده میکنند، همانطور که در مقالهی جریانساز High-Resolution Image Synthesis with Latent Diffusion Models تشریح شده است.
یک خودرمزگذار وردشی (VAE) پیکسلهای خام را به یک نقشهی ریاضی سبک به نام فضای نهان (Latent Space) فشرده میکند. این فرآیند شبیه به یک فایل ZIP یا پیشنویس گلی یک مجسمهساز عمل میکند و یک «گلوگاه فشردهسازی» ایجاد میکند که به موتور انتشار اجازه میدهد روی نسخهی سادهشدهای از تصویر عملیات انجام دهد.
جزئیات این فشردهسازی ادراکی به شرح زیر است:
- گلوگاه: یک تصویر خام با رزولوشن بالا (۱۰۲۴ در ۱۰۲۴ در ۳ کانال RGB) دارای حدود ۳,۱۴۵,۷۲۸ مقدار است. رمزگذار VAE این مقدار را با مقیاس ۸ برابر فشرده میکند.
- فضای نهان: فضای نهان حاصل (۶۴ در ۶۴ در ۴) تنها حاوی حدود ۱۶,۳۸۴ مقدار است. این یعنی کاهش ۶۴ برابری در تقاضای محاسباتی.
- حذف نویز: در فضای پیکسل، یک دانهی شن کوچک روی مریخ به اندازهی کل شکل سگ انرژی پردازشی میبرد، اما در فضای نهان، این جزئیات میکروسکوپی و غیرقابل تشخیص موقتاً کنار گذاشته میشوند.
- تمرکز اصلی: این کار به مدل اجازه میدهد تمام تمرکز خود را روی ساختارهای اصلی، از جمله ترکیببندی، نورپردازی، فیگور و سیلوئت بگذارد.
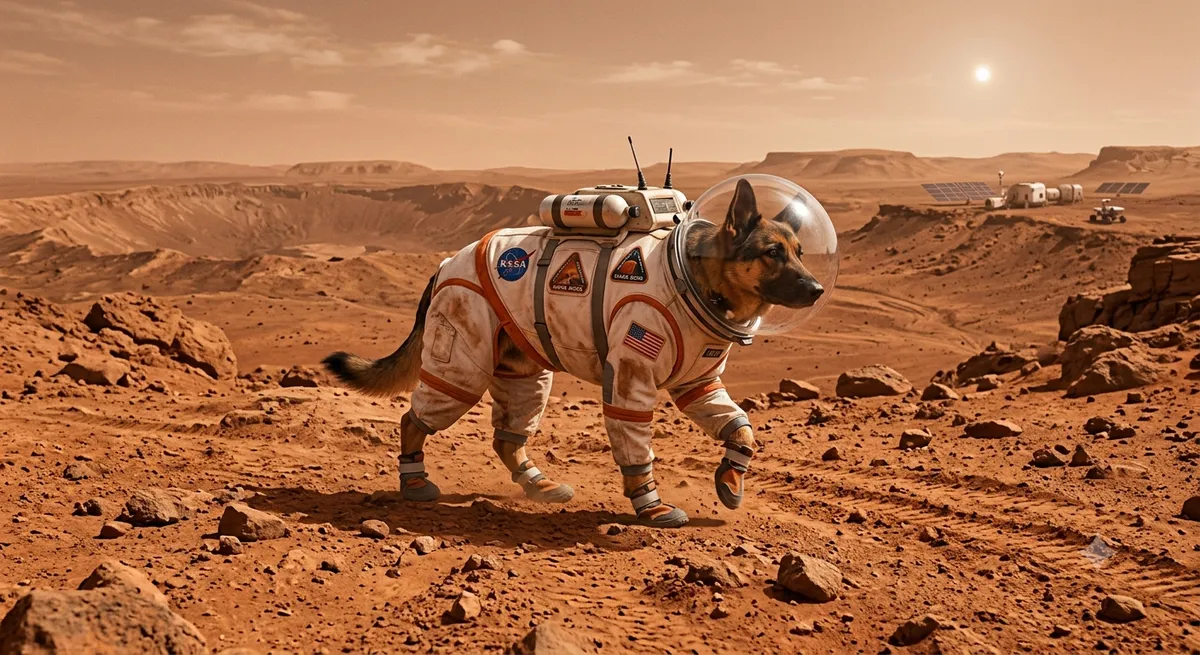
با کاهش تقاضای محاسباتی به میزان ۶۴ برابر، هوش مصنوعی میتواند دهها مرحلهی ترسیم پیچیده را در کسری از ثانیه انجام دهد، پیش از آنکه رمزگشای VAE نتیجه را دوباره به پیکسلهای با رزولوشن بالا گسترش دهد.
فرآیند حذف نویز (Denoising)
خلق واقعی تصویر از طریق انتشار گوسی (Gaussian Diffusion) رخ میدهد که دقیقاً شبیه به مجسمهسازی با تراشیدن یک تکه سنگ مرمر است. مدل با بومی از نویز تصادفی گوسی — شبیه به برفک تلویزیونهای قدیمی یا «برف» — شروع میکند.
در ۲۰ تا ۵۰ مرحلهی متوالی، یک شبکه عصبی تکههای نویز تصادفی را حذف میکند تا فرمها ظاهر شوند. این فرآیند معکوسِ مرحلهی آموزش (Forward Diffusion) است؛ در مرحلهی آموزش، تصاویر پاک به تدریج از طریق افزودن گامبهگام نویز (از t=10 و t=30 تا t=50) به نویز خالص تبدیل شده بودند.
توالی معکوس انتشار به این صورت است:
- گام ۰ (t=50): بوم ۱۰۰٪ برفک خالص است.
- گام ۱۵ (t=35): خطوط مبهم و سیلوئت افق ظاهر میشوند (حدود ۷۰٪ نویز).
- گام ۳۵ (t=15): فرم و رنگها قابل تشخیص میشوند؛ شکل سگ و لباس فضانوردی نمایان است (حدود ۳۰٪ نویز).
- گام ۵۰ (t=0): خروجی نهایی با جزئیات واقعگرایانه، بازتابهای نوری دقیق و لبههای تیز آماده است (۰٪ نویز).
برای اینکه نویز به جای گربه، به سگ تبدیل شود، سیستم از مکانیزمهای توجه متقاطع (Cross-Attention) استفاده میکند. این کار یک حلقهی بازخورد ایجاد میکند که در آن پیشنویس نهان فعلی با بردار نقشهی متنی مقایسه میشود. سیستم از یک ماتریس توجه متقاطع متشکل از پرسوجوها (پیکسلهای نهان)، کلیدها (توکنهای متنی) و مقادیر (ویژگیهای بصری) برای پیشبینی باقیماندهی نویز استفاده میکند.
در هر یک از مراحل حذف نویز، شبکه پیشنویس خود را با نقشهی متنی CLIP تطبیق میدهد و میپرسد: «آیا این ناحیه شبیه لباس فضانوردی درخواستی است؟ آیا این بخش با خاک مریخ مطابقت دارد؟». اگر همراستایی درست نباشد، شبکه مرحلهی بعدی کاهش نویز را تنظیم میکند تا مسیر را به سمت پرامپت هدایت کند.
مقیاسپذیری با ترنسفورمرها
در حالی که مدلهای اولیه از معماری U-Net استفاده میکردند — که بر اساس کاهش نمونه (downsampling)، یک گلوگاه و سپس افزایش نمونه (upsampling) از طریق کانولوشن بود — مدلهای مدرنی مثل Stable Diffusion 3 و FLUX به سمت ترنسفورمرهای انتشار (DiT) حرکت کردهاند. این تغییر توسط Peebles و Xie در مقالهی Scalable Diffusion Models with Transformers معرفی شد.
معماری DiT با دادههای بصری مانند یک زبان برخورد میکند. این مدل بوم فشردهی نهان را به تکههای مربعشکل کوچک یا «پچ» (Patch) تقسیم میکند. سپس این توکنهای پچ بصری را دقیقاً به همان روشی پردازش میکند که یک مدل زبانی بزرگ (مانند ChatGPT) کلمات را در یک جمله تحلیل میکند.
اجزای معماری DiT عبارتند از:
- پچسازی (Patchification): بوم نهان (مثلاً ۶۴ در ۶۴) به شبکهای از پچها (P1, P2 و غیره) تقسیم میشود.
- توکنهای پچ بصری: این پچها با رمزگذاریهای موقعیتی (Positional Embeddings) ترکیب میشوند تا ساختار فضایی تصویر حفظ شود.
- بدنه ترنسفورمر: سیستم از توجه چندسر (Multi-Head Self-Attention) و نرمالسازی لایهای تطبیقی (adaLN) استفاده میکند.
- توجه متقاطع: توکنهای متن مستقیماً در بلوکهای ترنسفورمر ادغام میشوند تا خروجی بصری را هدایت کنند.
این معماری اجازه میدهد مدلها به صورت نمایی مقیاسپذیر شوند. هرچه قدرت محاسباتی و دادههای بیشتری فراهم شود، مدل در درک پرامپتهای پیچیده، نوشتن متنهای خوانا و منسجم در داخل تصاویر و رندر کردن جزئیات آناتومیک سخت (مانند انگشتان دست انسان) بهتر عمل میکند.
شبیهسازی بُعد سوم
تبدیل تصویر به ویدیو نیازمند افزودن بُعد زمان است. ویدیو توالی سریعی از تصاویر است (معمولاً ۲۴ تا ۶۰ فریم در ثانیه). اگر فریمها به طور مستقل تولید شوند، نتیجه به دلیل تغییر رنگ و شکل در هر میلیثانیه، دچار لرزش شدید (Flickering) میشود.
مدلهای پیشرو مثل Sora متعلق به OpenAI، ویدیو را به عنوان یک ترنسفورمر نهان زمان-مکان سهبعدی میبینند، همانطور که در گزارش فنی Sora ذکر شده است. این مدل به جای پچهای دوبعدی، «مکعبهای» سهبعدی از دادههای بصری را میبرد که همزمان فضا و زمان را در بر میگیرند و ویدیو را به عنوان یک مکعب نهان زمان-مکان (ارتفاع × عرض × زمان) پردازش میکند. این رویکرد در ابزارهای تخصصیتر نیز به کار گرفته شده است؛ برای مثال، قابلیت رندرینگ عصبی در TalkPix نشان میدهد چگونه میتوان پرترههای ایستا را به ویدیوهای سخنگوی باکیفیت تبدیل کرد.
سازوکار تولید ویدیو شامل موارد زیر است:
- پچهای زمان-مکان سهبعدی: مدل مختصات ارتفاع، عرض و زمان را به عنوان یک واحد واحد پردازش میکند، نه به صورت برشهای تخت دوبعدی.
- توجه زمانی (Temporal Attention): این مکانیزم اشیا را در چندین فریم ردیابی میکند. اگر سگ فضانورد پشت یک تختهسنگ مریخی برود و دوباره ظاهر شود، مدل جزئیات ظاهر سگ، لباس و نورپردازی او را به خاطر میآورد تا تداوم بصری حفظ شود.
- پایداری اشیا (Object Permanence): این قابلیت اجازه میدهد دنیایی شبیهسازی شود که در آن اشیا حتی وقتی در کادر نیستند، وجود دارند و تضمین میکند که نژاد سگ یا رنگ لباسش هنگام پوشانده شدن تغییر نکند.
- مدلهای تداوم: برای مدیریت نیازهای پردازشی عظیم، از مدلهای تداوم زمان-پیوسته (sCM) استفاده میشود. این مدلها به سیستم اجازه میدهند در چند گام (به جای صدها گام) از نویز به فریمهای نهایی بپرد و سرعت تولید را به شدت افزایش دهد.
گذار به شبیهسازی جهان
این تکامل فنی، گذاری از ابزارهای سادهی «متن به عکس» به شبیهسازهای دنیای دیجیتال است. با ترکیب همراستاسازی زبانی، فشردهسازی نهان و انتشار تکرار شونده، هوش مصنوعی در حال درک فیزیک نور، پرسپکتیو و حرکت است. در همین راستا، ابزارهایی مانند Solaris در حال تغییر تعریف رابطهای کاربری هستند تا طراحیها را به جای کدهای استاتیک، به صورت ویدیوهای بلادرنگ رندر کنند.
برای یک سازندهی محتوا، این یعنی مرز بین تخیل و اجرای بصری در حال ناپدید شدن است. تمرکز از توانایی فنی «کشیدن» به توانایی مفهومی «کارگردانی» یک محیط شبیهسازی شده تغییر میکند.
با ادغام عمیقتر درک فیزیکی در این مدلها، میتوان انتظار داشت که رسانههای سنتتیک از تقلید بصری فراتر رفته و به سمت شبیهسازی واقعی قوانین فیزیکی حرکت کنند. ادغام موتورهای فیزیک در لحظه (Real-time Physics Engines) در مدلهای انتشار، میتواند «توهمات» باقیمانده در توالیهای حرکتی پیچیده را کاملاً حذف کند.
گام بعدی شما
- برای درک بهتر تفاوت در کیفیت، خروجیهای مدلهای مبتنی بر U-Net را با مدلهای DiT (مثل FLUX) مقایسه کنید.
- در پرامپتهای خود از توصیفات مربوط به نورپردازی و پرسپکتیو (مثلاً Cinematic Lighting یا Wide Shot) استفاده کنید تا قدرت مدلهای انتشار را به چالش بکشید.
- گزارشهای فنی Sora را برای درک مفهوم «پچهای زمان-مکان» مطالعه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو