عاملهای هوش مصنوعی معمولاً حجم عظیمی از توان محاسباتی را در مسیرهای بنبست و بینتیجه در فضاهای جستوجوی پیچیده هدر میدهند. در ۱۹ سپتامبر ۲۰۲۶، گوگل دیپمایند (Google DeepMind) از روشی به نام Dream-RSI پردهبرداری کرد؛ متدی که به عاملها اجازه میدهد نحوه کاوش برای یافتن پاسخهای بهینه را اصلاح کنند، بدون آنکه نیاز باشد خودِ مدل زیربنایی هوش مصنوعی را تغییر دهند.
بیشتر عاملهای فعلی یا از یک استراتژی جستوجوی صلب استفاده میکنند که منجر به تکرار اشتباهات میشود، یا از روشهای تطبیقی بهره میبرند که هزینه تست آنها در زمان واقعی بسیار بالاست. با تکیه بر فشار صنعت به سمت بهبودهای بازگشتی (Recursive Self-Improvement) — روندی که پیش از این به دلیل پیمانهای توسعه AI باعث بررسیهای قانونی شده است — Dream-RSI یک راه میانه را معرفی میکند: «شبیهساز بازپخش» (Replay Simulator).
سازوکار کاوش در فضای پاسخ
در وظایف پیچیده، فضای جستوجو میتواند بهشدت گسترده و عظیم شود. در این شرایط، عامل (Agent) باید مدام تصمیم بگیرد کدام رویکردهای امیدوارکننده را دنبال کند، کدامها را بهصورت موازی پیش ببرد و کدام مسیرها را بهطور کامل رها کند. این فرآیند که کاوش (Exploration) نام دارد، تعیینکننده نهایی است که آیا جستوجو به موفقیت میرسد یا توان محاسباتی را در تعقیب ایدههای غلط تلف میکند. این دقت در تحلیل و شناسایی مسیرهای بهینه، مشابه همان رویکردی است که در برتری هوش مصنوعی در شناسایی فرصتها در برابر روشهای انبوه مشاهده شد، جایی که تحلیل عمیق جایگزین تکرارهای بیهدف میشود.
طبق مستندات دیپمایند، رویکردهای موجود عموماً کاوش را به دو روش مدیریت میکنند. نخست، استراتژیهای جستوجوی ثابت که نمیتوانند از تجربه درس بگیرند؛ این یعنی عامل ممکن است بارها و بارها به همان بنبستهای قبلی برخورد کند. دوم، تطبیق استراتژی در حین جستوجو که اگرچه از صلب بودن میکاهد، اما بسیار هزینهبر است. یافتن اینکه آیا یک استراتژی خاص کار میکند یا خیر، نیازمند تلاشهای متعدد است و تست بیشمار جایگزینها به معنای تکرار اجراهای طولانی و گرانقیمت خواهد بود.
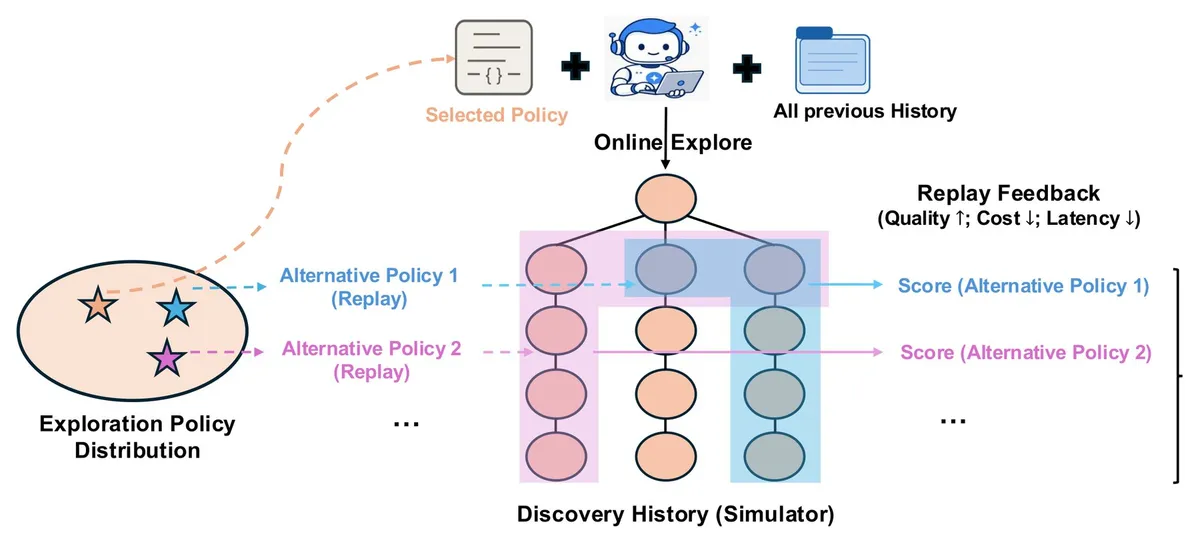
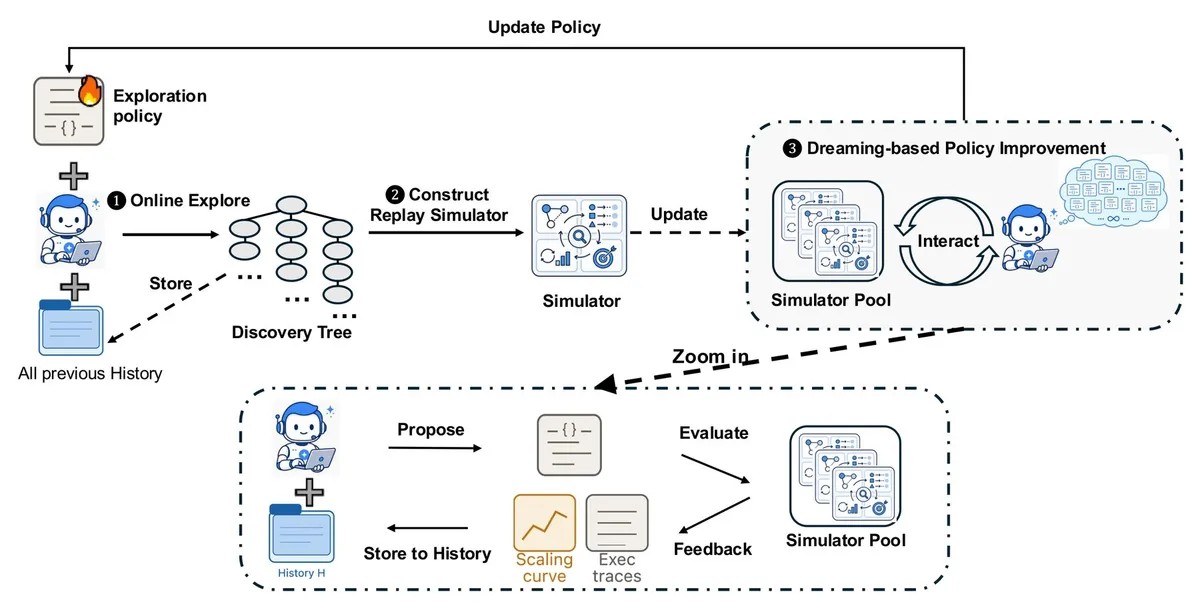
تصور کنید در شهری غریب گم شدهاید؛ بهجای اینکه هر بار دوباره تمام پیچوخمهای اشتباه را طی کنید، از یک نقشه ذهنی برای برنامهریزی مسیر بهتر استفاده میکنید. Dream-RSI دقیقاً همین منطق را در AI پیاده میکند؛ این سیستم تمام تلاشها و نتایج را در یک «درخت جستوجو» ثبت میکند. سپس عامل با اجرای هزاران استراتژی جایگزین روی این دادههای ذخیرهشده، «رؤیاپردازی» میکند تا ببیند اگر در لحظات کلیدی تصمیمات متفاوتی میگرفت، چه اتفاقی میافتاد.
فرآیند «رؤیاپردازی» و بهینهسازی
در این روش، عامل بهجای تست یک استراتژی جدید در یک اجرای زنده و واقعی، آن را روی نتایج ذخیرهشده اجرا میکند. این قابلیت به مدل اجازه میدهد بررسی کند اگر رویکردهای دیگر را زودتر امتحان میکرد یا برخی مسیرها را در مراحل ابتدایی رها میکرد، چه نتیجهای میگرفت. از آنجایی که تمام نتایج در درخت جستوجو ذخیره شدهاند، هزاران استراتژی جایگزین را میتوان بدون نیاز به فراخوانی مجدد مدل یا ارزیاب (Evaluator) تست کرد.
این سازوکار یک حلقه بهبود مستمر ایجاد میکند: عامل ابتدا یک جستوجوی زنده انجام میدهد، نتایج را ثبت میکند، سپس استراتژیهای بهینه را در یک شبیهساز بازپخش میسنجد و در نهایت استراتژی برنده را در اجرای زنده بعدی به کار میگیرد. در تمام این چرخه، تنها استراتژی جستوجو تغییر میکند و مدل تولیدکننده پاسخها کاملاً دستنخورده باقی میماند.
محکهای عملکرد و کاهش هزینهها
پژوهشگران این سیستم را با استفاده از مدلهای Gemini 3.1 Pro و Gemini 3.7 Flash در هشت وظیفه پیچیده در سه حوزه مختلف آزمایش کردند. نتایج بهدستآمده نشاندهنده کاهش چشمگیر اتلاف محاسباتی است:
- برنامهنویسی ژنومیک و مالی: در تسکی برای نوشتن سریعترین برنامه ممکن جهت یک محاسبه آماری که بهطور معمول در ژنومیک و امور مالی استفاده میشود، برنامههای تولیدشده توسط Dream-RSI در تمام ۶ مجموعه داده تست، سریعتر از کتابخانههای شناختهشده sklearn و glmnet عمل کردند.
- بهرهوری محاسباتی: با استفاده از مدل Gemini 3.1 Pro، میانگین زمان اجرا از ۳۵۸۷ به ۲۹۳۱ میلیثانیه کاهش یافت. همچنین تعداد تلاشهای مورد نیاز از ۵۵۰ به ۳۱۷ رسید که به معنای کاهش ۴۳ درصدی در تلاشهای جستوجو است.
- برتری رقابتی: در مقایسه با سیستمی به نام SimpleTES که برای انجام وظایف مشابه به ۵۱,۲۰۰ اجرا نیاز داشت، Dream-RSI توانست تنها با ۳۱۷ تلاش به نتایج خود دست یابد.
بهینهسازی هسته GPU
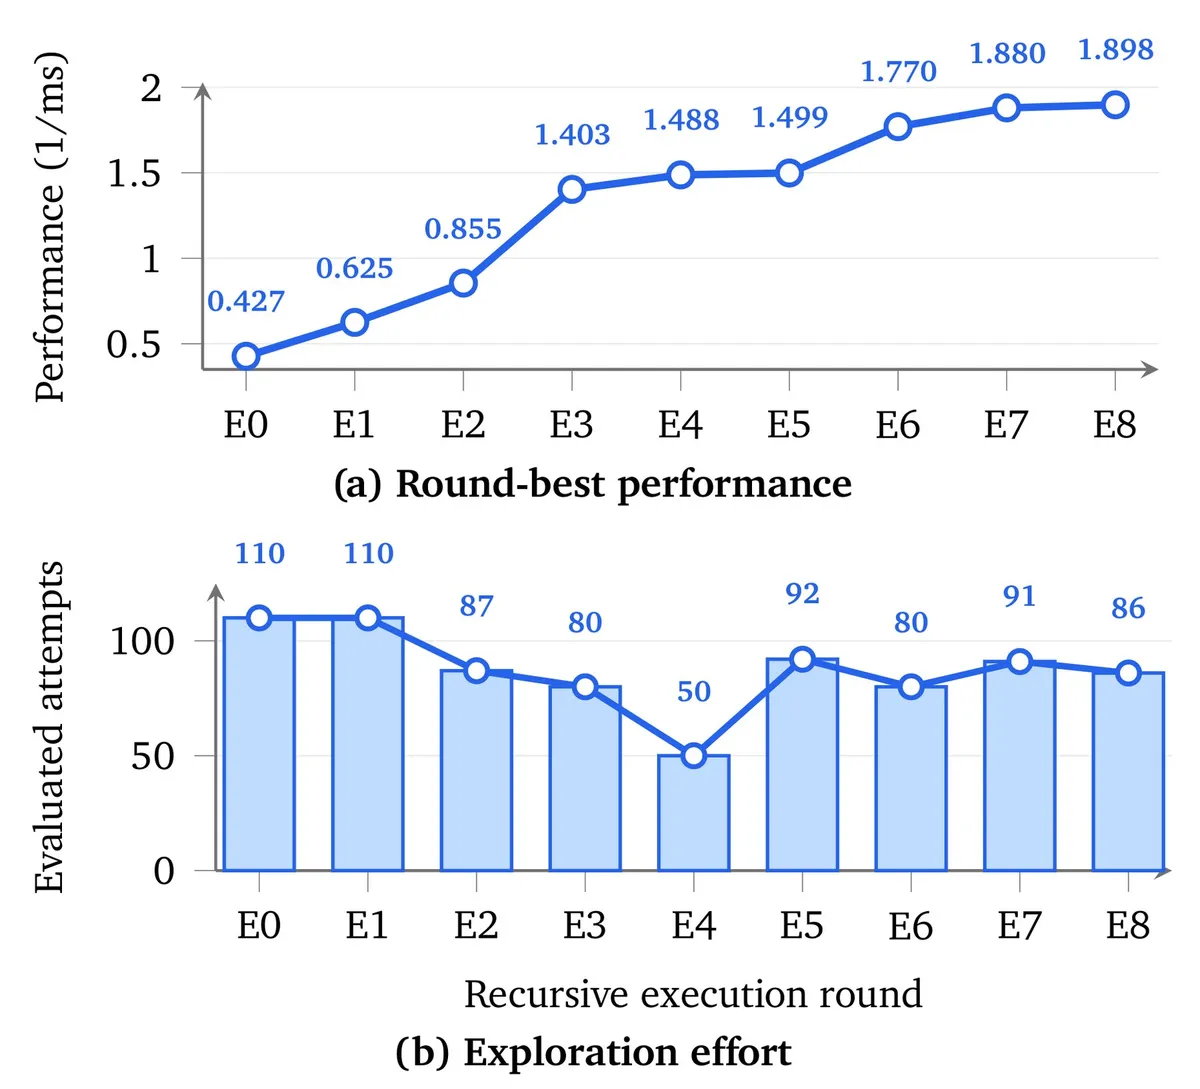
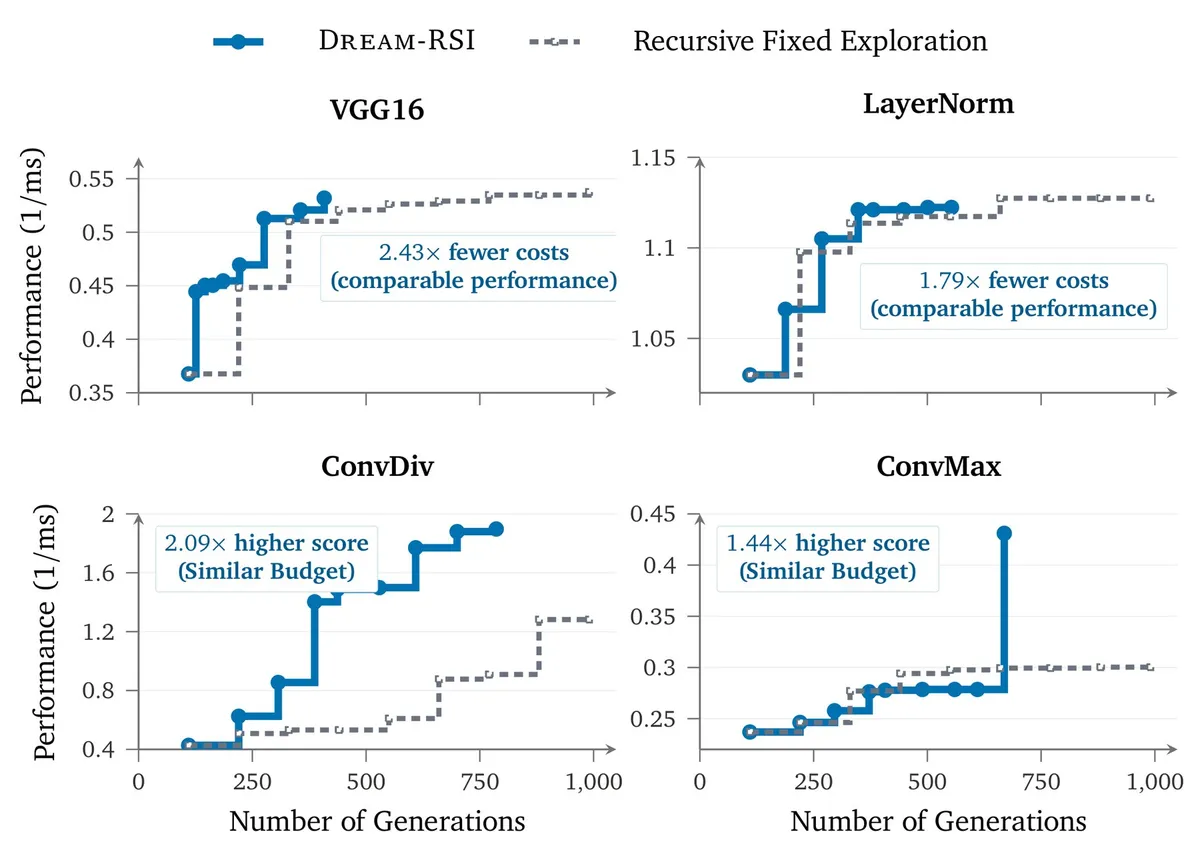
در وظایفی که شامل نوشتن بهینه هسته GPU (GPU Kernel) بود، این سیستم در حالی که عملکرد پایه (Baseline) را حفظ کرده بود، تعداد دفعات تولید کد را تا ۲.۴۳ برابر کاهش داد. در سناریوهای دیگر، با همان بودجه محاسباتی، عملکردی ۲.۰۹ برابر بالاتر ارائه کرد. الگوهای مشابهی از بهرهوری و کاهش اتلاف در وظایف بهینهسازی ریاضی نیز مشاهده شد.
ریسک دستورالعملهای صریح
یافتههای جالب پژوهشگران نشان داد که دستورالعملهای صریح (Explicit Instructions) میتوانند در واقع مانع پیشرفت شوند. آنها در یک تحلیل تکمیلی، سعی کردند تاریخچه جستوجو را در قالب دستورات مستقیم فشرده کنند تا به عامل بگویند دقیقاً کجا را جستوجو کند. اما در یک تسک مربوط به GPU، این نسخه عملکرد ضعیفتری نسبت به نسخهای داشت که هیچ دستورالعمل صریحی دریافت نکرده بود.
این موضوع نشان میدهد که جهتدهیهای بیش از حد دقیق، فضای جستوجو را بیش از حد محدود کرده و مانع از آن میشود که عامل رویکردهای گستردهتر و خلاقانهتر را کشف کند. تحلیلها همچنین نشان داد که استراتژی یادگرفتهشده چگونه تلاش خود را تنظیم میکند: با بهبود عملکرد، ابتدا تعداد تلاشها را کاهش داد و سپس زمانی که پیشرفت متوقف شد (Stalled)، دوباره تلاش برای جستوجو را افزایش داد که این امر با دستاوردهای بیشتر همزمان بود.
جایگاه در بهبودهای بازگشتی
این تغییر رویکرد، تمرکز را از بهینهسازی «مدل» به بهینهسازی «فرآیند کشف» منتقل میکند. مفهوم بهبودهای بازگشتی (Recursive Self-Improvement) توجه زیادی جلب کرده و حتی باعث شده است داریو آمودی، مدیرعامل آنتروپیک، درباره سرعت شتابان تحقیقات AI هشدار دهد.
- AlphaEvolve (۲۰۲۵): این سیستم که توسط گوگل دیپمایند معرفی شد، از Gemini Flash برای تولید پیشنهادهای کد و از Gemini Pro برای تحلیل آنها استفاده میکند و یک الگوریتم تکاملی نسخههای برتر را انتخاب میکند. Dream-RSI یک سطح بالاتر عمل کرده و خودِ استراتژی جستوجو را بهینه میکند.
- AutoTTS: از یک عامل کدنویس برای جستوجوی الگوریتمها در یک محیط شبیهسازی شده استفاده میکند تا تصمیم بگیرد یک مدل زبانی چه زمانی باید مسیرهای استدلال را شروع کند، گسترش دهد یا رها کند. این توانایی در تغییر مسیر بر اساس دادههای محیطی، یادآور تاثیر منابع خارجی بر تغییر تصمیمات عاملهای خرید است که نشان میدهد چگونه ورودیهای جدید میتوانند خروجی نهایی عامل را دگرگون کنند.
- WikiSkill: سیستمی از گوگل ریسرچ است که شکستها و موفقیتها را در یک ویکی ثبت میکند تا دستورالعملهای قابل استفاده مجدد ایجاد کند. یافتههای Dream-RSI نشان میدهد چنین دستورالعملهایی میتوانند کاوش را در وظایف باز (Open-ended) محدود کنند.
- Hyperagents: پروژهای از متا است که به عاملها اجازه میدهد مکانیزمی را که کنترل میکند چگونه بهبود یابند، بازنویسی کنند.
برای جامعه فنی، این نتایج تایید میکند که محاسبات زمان استنتاج (Test-time compute) زمانی بیشترین اثر را دارد که استراتژی جستوجو از تجربه یاد گرفته شود، نه اینکه بهصورت سختافزاری (Hard-coded) تعریف شود. این یعنی جهش بعدی در استدلال عاملمحور، از «حافظه بهتر از شکستها» حاصل خواهد شد، نه صرفاً از افزایش تعداد پارامترها.
گام بعدی شما
- بررسی مستندات Dream-RSI برای پیادهسازی درختهای جستوجو در عاملهای شخصی.
- تحلیل اثر کاهش دفعات فراخوانی API بر هزینههای عملیاتی پروژههای Agentic.
- آزمایش رویکرد «جستوجوی بدون دستورالعمل» در تسکهای خلاقانه برای جلوگیری از محدود شدن فضای پاسخ.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو