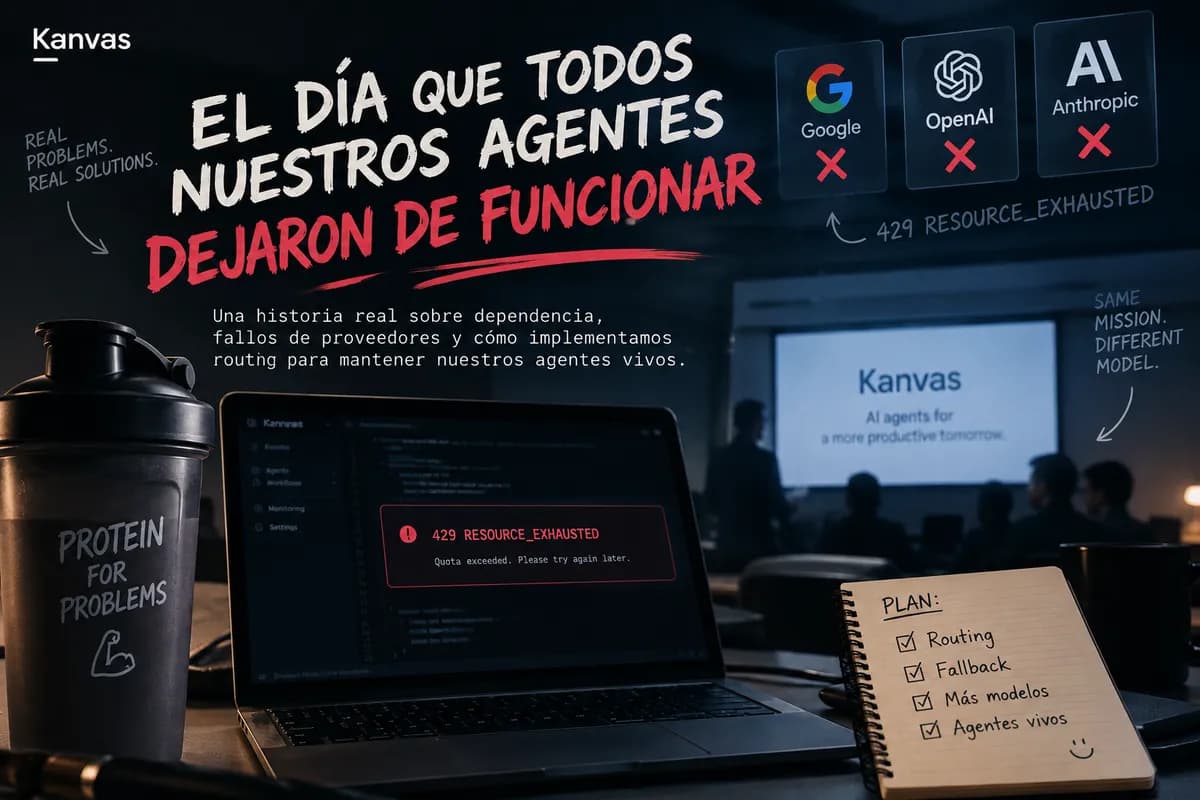
تصور کنید در حساسترین لحظهی یک ارائه زنده، تمام عاملهای هوش مصنوعی شما بهطور همزمان از کار بیفتند و هیچ راهی برای بازگشت نباشد. این کابوس دقیقاً در ۲۴ سپتامبر ۲۰۲۴ برای تیم Kanvas رخ داد و نشان داد که حتی پیشرفتهترین زیرساختها هم در برابر یک خطای سادهی خارجی آسیبپذیرند. روز برای آنها عالی شروع شده بود؛ تستهای قبلی با موفقیت انجام شده بود و مالک محصول (PO) از نتایج رضایت داشت. با وجود اینکه زیرساخت هسته سالم بود و قوانین کسبوکار بهدرستی اجرا میشدند، اما عاملها به دلیل یک «نقطه شکست واحد» (Single Point of Failure) یعنی ارائهدهنده خارجی هوش مصنوعی، از کار افتادند.
زمینه و شرایط وقوع حادثه
این شکست، ناگهانی و مطلق بود. کدبیس سیستم در ۲۴ ساعت گذشته هیچ تغییری نکرده بود. سیستم مرکزی همچنان فعال بود، APIها پاسخ میدادند و قوانین تجاری بهدرستی کار میکردند. با این حال، عاملها که محصولات پیشرو و ویترین شرکت Kanvas بودند، بهطور کامل آفلاین شدند.
بسیاری از توسعهدهندگان با مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — مانند یک ابزار سیستمیِ قابلاعتماد، شبیه به دیتابیس یا سرورهای ابری برخورد میکنند. اما همانطور که در تحلیلهای قبلی ما دربارهی پایداری سیستمهای عاملمحور اشاره کردیم، تکیه بر یک ارائهدهنده واحد، بزرگترین نقطه ضعف معماریهای مدرن است. همانطور که Kanvas کشف کرد، شما میتوانید بهترین سیستمهای مقیاسپذیری خودکار (Autoscaling) و استقرار مدلهای Blue/Green را داشته باشید، اما اگر ارائهدهنده LLM شخص ثالث شما شکست بخورد، عاملهای شما عملاً میمیرند. این موضوع یک شکاف خطرناک در سیستمهای با دسترسی بالا (High-Availability) ایجاد میکند؛ جایی که حیاتیترین جزء سیستم، همان بخشی است که توسعهدهنده کمترین کنترل را روی آن دارد.
به نقل از گزارشی در dev.to، این قطعی گسترده توسط یک خطای خاص از گوگل با کد 429 RESOURCE_EXHAUSTED ایجاد شده بود. این خطا به این معناست که سیستم به سقف مجاز درخواستها (Rate Limit) رسیده یا منابع تخصیصیافتهاش تمام شده است و تا زمان بازنشانی سهمیه توسط ارائهدهنده، هیچ راهی برای بازیابی وجود ندارد.
جزئیات فنی و راهکار مسیریابی
در حالی که «استرلا» (Estrella)، مالک محصول، موفق شد ارائه را نجات دهد، اما این حادثه تیم را مجبور کرد تا به یک سؤال حیاتی پاسخ دهد: چگونه میتوانیم دسترسی بالای عاملها را تضمین کنیم؟ لید فنی تیم یک تغییر مفهومی را پیشنهاد داد: یک درخواست نباید با شکستِ یک مدل واحد، بمیرد.
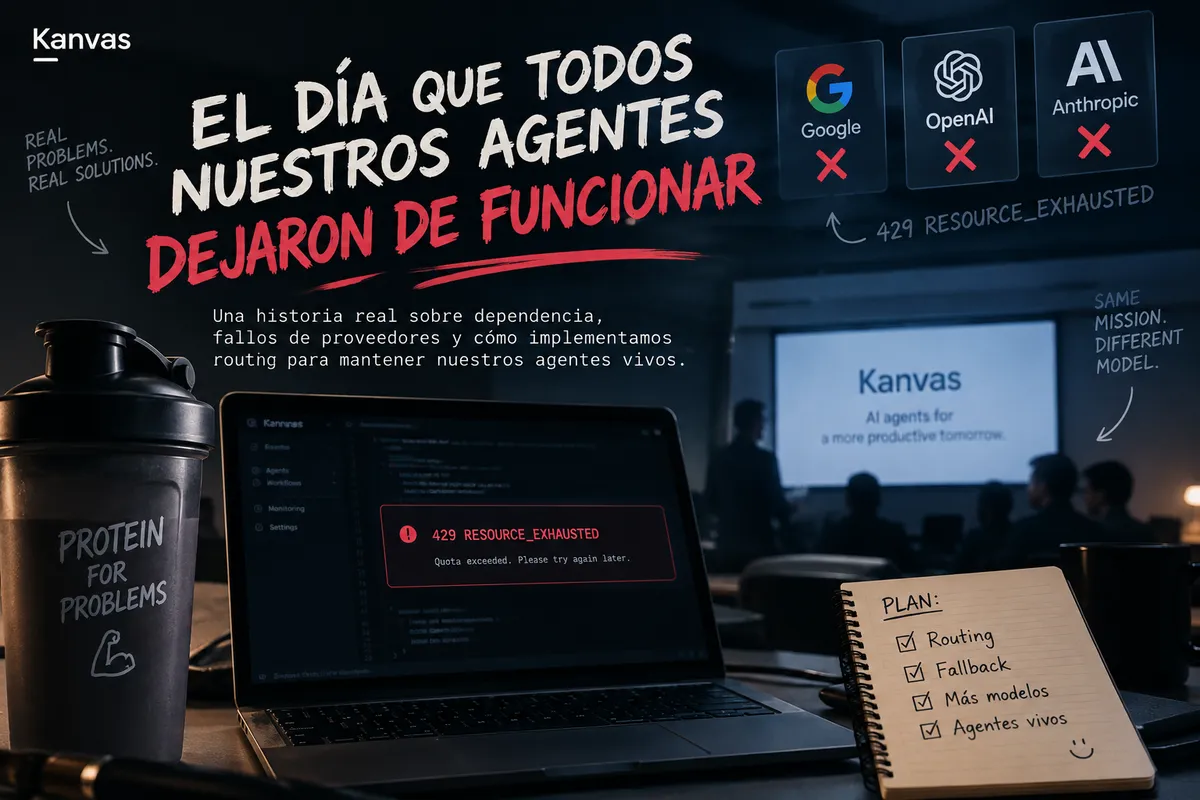
برای حل این مشکل، تیم مهندسی Kanvas مکانیزمی را پیادهسازی کردند که آن را «مسیریابی» (Routing) مینامند. اکنون سیستم بر اساس یک استراتژی جایگزین (Fallback) عمل میکند تا اطمینان حاصل شود که هیچ درخواستی با از دست رفتن یک مدل متوقف نشود. منطق این سیستم از یک سلسلهمراتب خاص پیروی میکند:
- مسیر اصلی: درخواست ابتدا تلاش میکند از مدل اصلی تعیینشده استفاده کند.
- جایگزینی مدل: اگر مدل A شکست بخورد، مسیریاب فوراً مدل B را امتحان میکند.
- جایگزینی ارائهدهنده: اگر کل ارائهدهنده (مثلاً گوگل) از دسترس خارج شود، مسیریاب به ارائهدهنده C سوییچ میکند.
- منطق زنجیرهای: توالی به شکل «مدل A ← مدل B ← ارائهدهنده B ← مدل C» ادامه مییابد تا زمانی که یک مسیر فعال و قابل اجرا پیدا شود.
این چارچوب به Kanvas اجازه میدهد چندین مدل از یک ارائهدهنده را اختصاص دهد و بهطور همزمان، ارائهدهندههای مختلف با مدلهای متفاوت را حفظ کند. تیم در حال حاضر در حال تست این راهکار است تا وابستگی مطلق به هر یک از غولهای مدلهای بسته (Closed-source) را از بین ببرد.
این تغییر، فرض بنیادی در معماری عاملمحور (Agentic) را عوض میکند؛ پایداری یا دسترسی بالا (High Availability) دیگر فقط به معنای داشتن سرورهای پشتیبان نیست، بلکه به معنای داشتن «هوش جایگزین» است. با جداسازی منطق عامل از یک ارائهدهنده خاص، شرکتها میتوانند مدلهای بسته بزرگ را با جایگزینهای کوچکتر و مدلهای «وزنهای باز» (Open-weights) بر اساس نوع وظیفه، ترکیب کنند.
برای یک توسعهدهنده، این یعنی عصر «تک-API» به پایان رسیده است. تکیه بر یک ارائهدهنده برای محیط عملیاتی (Production)، اکنون یک ریسک استراتژیک و یک نقطه ضعف محسوب میشود. هدف باید ساختن پشتهای (Stack) باشد که در آن مدل هوش مصنوعی، یک کالای قابل تعویض است، نه یک زیربنای شکننده.
توسعهدهندگان اکنون باید پشتههای عامل خود را برای شناسایی نقاط شکست تکنقطهای ارزیابی کنند. گام بعدی، آزمایش مدلهای متنباز است — چه ارزان باشند، چه کمیاب یا متعلق به مناطق جغرافیایی جایگزین — تا به عنوان پشتیبانهای ثانویه برای کاهش هزینهها و افزایش تابآوری سیستم استفاده شوند.
گام بعدی شما
- نقاط شکست تکنقطهای (Single Point of Failure) را در معماری عاملهای خود شناسایی کنید.
- مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — را به عنوان لایه پشتیبان برای کاهش هزینه و افزایش استواری تست کنید.
- یک سیستم مسیریابی ساده برای توزیع درخواستها بین حداقل دو ارائهدهنده مختلف پیادهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو