اگر امروز از عاملهای هوش مصنوعی برای تولید کد استفاده میکنید، احتمالاً متوجه شدهاید که سرعت نوشتن کد بسیار بیشتر از سرعت تأیید آن است. این شکاف زمانی، زیرساختهای تست را به بزرگترین مانع بهرهوری تبدیل میکند.
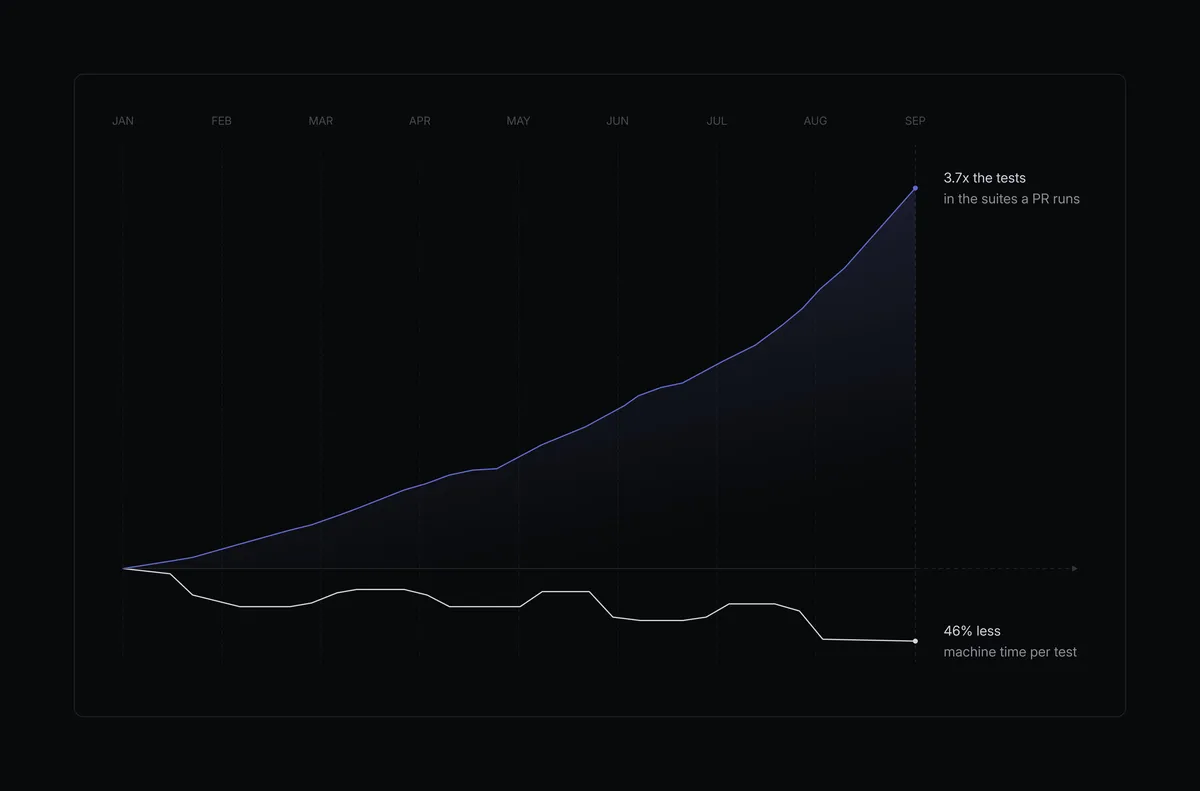
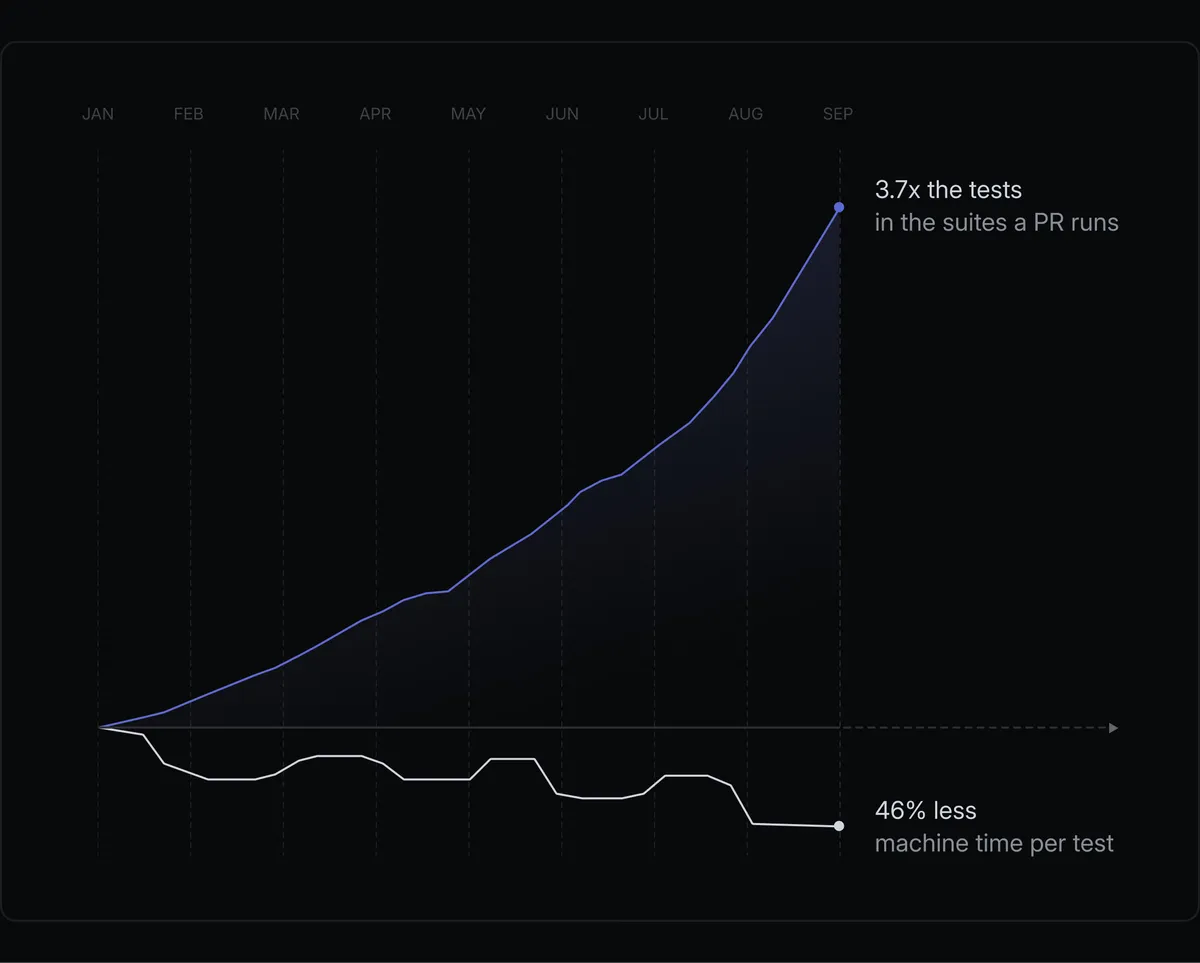
به نقل از گزارش فنی linear.app، حجم مجموعهتستهای این شرکت بین ژانویه و سپتامبر ۲۰۲۶ تقریباً چهار برابر شد، اما زمان انتظار برای Pull Requestها (PR) از ۶ دقیقه به کمی بیش از ۵ دقیقه کاهش یافت. این دستاورد در حالی به دست آمد که عاملهای هوش مصنوعی (AI Agents) — شبیه دستیارهای فوقسریع که هر ثانیه دهها خط کد مینویسند — سرعت ارسال کد را به صورت نمایی افزایش داده بودند و خط لولههای اعتبارسنجی دیگر توان همراهی با این سرعت را نداشتند. این فشار مضاعف بر بازبینها، دقیقاً همان بحرانی است که در آن حجم کد تولیدشده توسط AI، ظرفیت بازبینهای انسانی را به چالش میکشد و باعث ایجاد گلوگاه در فرآیند تایید میشود. شرکت Linear دریافت که این شتاب، فرآیند یکپارچهسازی مداوم (CI) را به یک گلوگاه بحرانی تبدیل کرده است که نه تنها هزینههای زیرساختی را بالا میبرد، بلکه توسعهدهندگان را برای دریافت بازخورد در حالت انتظار نگه میدارد.
تصور کنید در کارخانهای هستید که خط تولید به لطف رباتها ۱۰ برابر سریعتر شده، اما ایستگاه کنترل کیفیت هنوز با همان سرعت قدیمی کار میکند؛ در نهایت کل سالن تولید متوقف میشود. برای Linear، رباتها همان عاملهای کدنویس بودند و کنترل کیفیت، همان خط لوله یکپارچهسازی مداوم (CI) — سیستمی که مثل یک بازرس سختگیر، هر تغییر در کد را قبل از پذیرش تست میکند. برای حل این مشکل، تیم بر روی دو معیار اصلی تمرکز کرد: اینکه یک PR چه مدت در صف CI منتظر میماناند و مجموع زمان مصرفی Runnerها برای هر تست چقدر است. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی جریانهای کاری توسعهدهندگان اشاره کردیم، حذف اصطکاک در بازخورد، کلید مقیاسپذیری است.
ارتقای زیرساخت و ابزارها
اولین فاز بهینهسازی شامل انتقال حجم کاری از GitHub Actions به Runnerهای شخص ثالث بود. این ماشینهای جدید CPUهای سریعتر، حافظه ذخیرهسازی با عملکرد بالاتر و زیرساخت کش برتری ارائه میدادند. طبق گزارش linear.app، این جابجایی به تنهایی باعث شد وظایف بهطور متوسط ۳۴٪ سریعتر اجرا شوند و برخی تسکها مانند tsc (کامپایلر تایپاسکریپت) شاهد کاهش زمان ۵۲ درصدی بودند.
مدرنسازی زنجیره ابزارها (Toolchain) دستاوردهای بیشتری به همراه داشت. تیم به tsgo، یک کامپایلر بومی تایپاسکریپت، مهاجرت کرد که میانگین هفتگی بررسیهای tsc را ۷۳٪ کاهش داد. این اقدام بهطور مؤثری بررسی تایپها (Type-checking) را از یک گلوگاه اصلی خارج کرد.
بخش Linting (بررسی خطاهای نگارشی و استانداردهای کد) هدف بزرگ دیگری بود. پیش از این، قوانین سفارشی لنت به اطلاعات کامل تایپ تایپاسکریپت نیاز داشتند و سیستم را مجبور میکردند برای هر بار اجرا، یک گراف کامل از تایپها بسازد. این موضوع باعث شده بود لنتینگ به یکی از حافظهبرترین (Memory-intensive) وظایف در خط لوله CI تبدیل شود. تیم Linear با بازنویسی این قوانین برای استفاده از تحلیل استاتیک روی درخت نحو انتزاعی (AST)، توانست سازههای تابعمانند و الگوهای Guard را بدون نیاز به اطلاعات تایپ شناسایی کند. این تغییر اجازه داد ESLint تایپاسکریپت را بهطور کامل کنار بگذارد، که نتیجه آن کاهش ۶۸ درصدی زمان لنت API و کاهش ۵۵ درصدی زمان لنت کل مخزن بود. همچنین میزان مصرف حافظه به شدت افت کرد.
حذف وابستگی به اطلاعات تایپ، انتقال به Oxlint را نیز سادهتر کرد، زیرا قوانینی که صرفاً روی نحو (Syntax) عمل میکنند، راحتتر منتقل میشوند. Oxlint در نهایت مجموع دقایق مصرفی Runnerها برای لنتینگ را باز هم کاهش داد.
بهینهسازی مسیر بحرانی
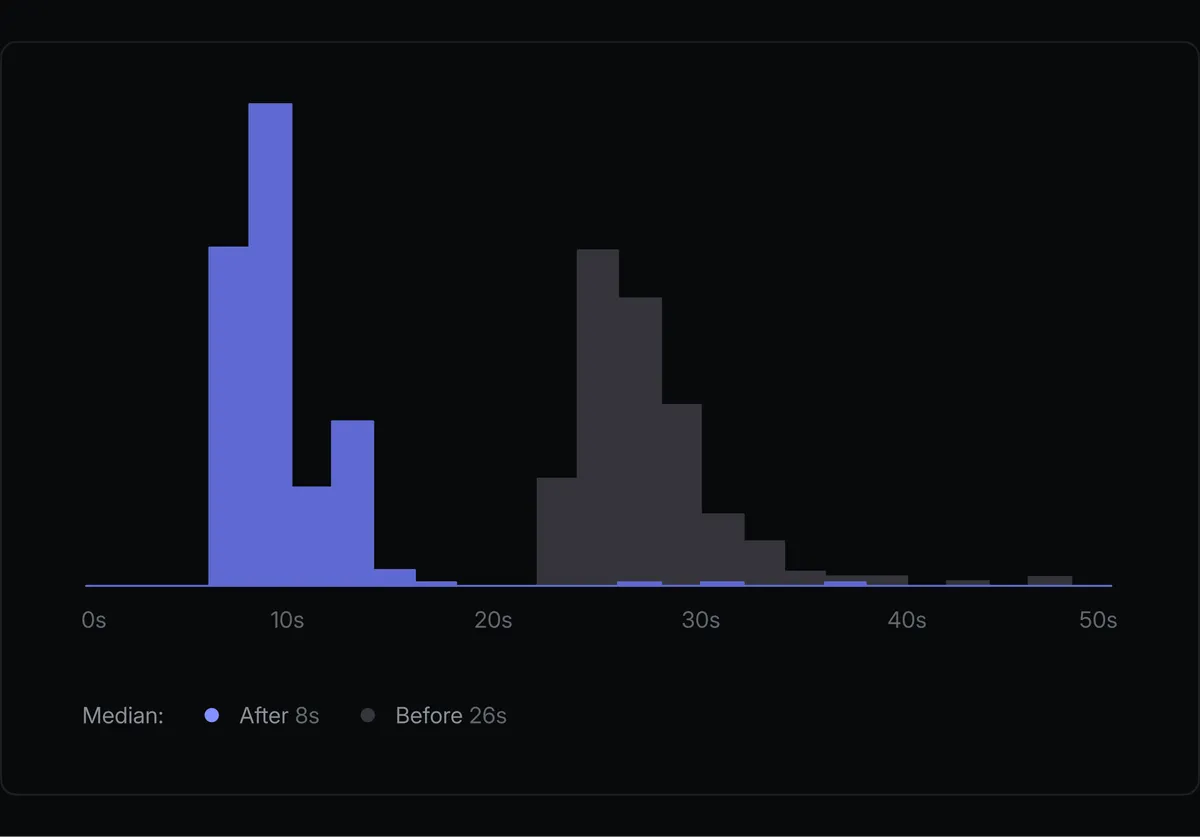
سپس Linear سیستم CI را به عنوان یک کل تحلیل کرد و بر روی وظایف «دروازهای» (Gate jobs) تمرکز نمود؛ یعنی وظایفی که باید پیش از شروع سایر کارها به پایان برسند. آنها متوجه شدند وظایفی که تشخیص تغییرات را انجام میدهند (Change-detection) — مثلاً بررسی اینکه آیا مهاجرتهای دیتابیس وجود دارد یا خیر — برای تصمیمگیری درباره مراحل بعدی، کل درخت کاری (Working tree) را دانلود میکردند، در حالی که تنها به زیرمجموعه کوچکی از فایلها نیاز داشتند.
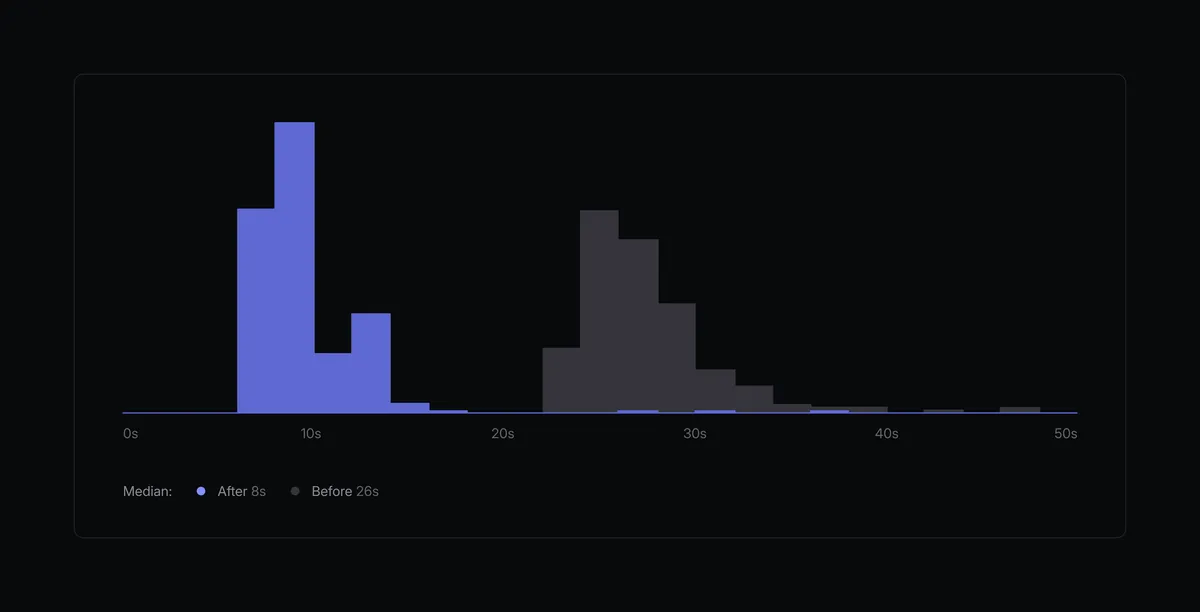
با محدود کردن عمق دریافت دادهها (Fetch depth) و حذف عملیات Checkout برای وظایفی که نیازی به درخت کاری نداشتند، تیم توانست کندترین دروازه را از ۹۴ ثانیه به ۲۰ ثانیه برساند. برای رویدادهای Push کامیت و صف ادغام (Merge-queue)، آنها یک Checkout پراکنده و بدون-بابل (Sparse, blobless) با تاریخچه محدود پیادهسازی کردند که ۱۱ ثانیه دیگر را ذخیره کرد. نتایج این تغییرات چشمگیر بود:
- میانگین زمان وظایف تشخیص تغییرات از ۲۶ ثانیه به ۸ ثانیه کاهش یافت.
- مقدار p90 (۹۰ درصد سریعترین اجراها) از ۳۱ ثانیه به ۱۲ ثانیه رسید.
- کندترین اجرا از ۱۳۸ ثانیه به ۳۷ ثانیه سقوط کرد.
ناپایداری شبکه نیز Runnerهای شخص ثالث آنها را آزار میداد. چون این Runnerها خارج از شبکه گیتهاب هستند، به یک لینک IP مستقیم متکیاند. ارائهدهنده سرویس متوجه شد که توقفهای متناوب به دلیل افت کیفیت در این لینک است. برای رفع این مشکل، آنها actions/checkout استاندارد را با یک اکشن ترکیبی سفارشی جایگزین کردند که شامل موارد زیر است:
- تلاش مجدد (Retries) با تأخیر تصاعدی (Backoff).
- پیکربندی
GIT_HTTP_LOW_SPEED_LIMITوGIT_HTTP_LOW_SPEED_TIMEبرای قطع اتصالات متوقفشده پس از حدود ۳۰ ثانیه. - یک کش Checkout که یک آینه (Mirror) دائمی از گیت را روی یک دیسک چسبنده (Sticky disk) نگه میدارد.
این اقدام مانع از آن شد که دریافتهای متوقفشده باعث بیکار ماندن کل اجرای CI شوند و تضمین کرد که وظایف مسیر بحرانی معطل نمانند.
در نهایت، آنها وظایف غیرضروری را از مسیر بحرانی حذف کردند. پیش از این، نوشتن نشانگرهای کش (Cache markers) بخشی از بررسی نهایی ادغام بود؛ به این معنی که یک PR حتی پس از پاس شدن تستها، میتوانست در صف ادغام منتظر بماند. انتقال این مورد به یک شغل غیر-دروازهای که پس از پایان تکههای تست (Test shards) اجرا میشود، ۴۲ ثانیه از مسیر ادغام برای هر PR در API و هر ورودی صف ادغام کم کرد. در مجموع، این تغییرات در مسیر بحرانی حدود یک دقیقه در زمانهایی که کش خالی بود (Cache misses) صرفهجویی کرد و تعداد دفعات شروع Runnerها را کاهش داد.
کاهش هزینههای راهاندازی تکراری
سربار راهاندازی — یعنی بوت شدن Runnerها، نصب پکیجها و آمادهسازی وابستگیهای بیلد — اغلب بیشتر از خودِ تستها زمان میبرد. Linear این مشکل را از طریق چندین مکانیسم هدفمند حل کرد:
پیشنصب وابستگیها:
- تصویر پایه CI: تیم کلاینت Postgres و Node را به یک تصویر پایه کوچک CI منتقل کرد. پیش از این، تکههای تست API در هر بار اجرا ۷ تا ۸ ثانیه را صرف نصب کلاینت از طریق
aptمیکردند. - هدرهای بومی (Native Headers): آنها هدرهای مورد نیاز برای بیلد بومی را به تصویر اضافه کردند تا از توقفهای اتفاقی در حین راهاندازی جلوگیری کنند و بدین ترتیب انتهای توزیع زمان (Tail of the distribution) را کوتاه کنند.
بهینهسازی نصب پکیجها:
- نصبهای فیلترشده: Linear از یک Monorepo با pnpm workspace استفاده میکند. بهجای نصب کل Workspace، اکنون جریان کاری تست API فقط پکیج API و وابستگیهای مستقیم آن را نصب میکند. این کار زمان
pnpm installرا از بازه ۴۴-۷۳ ثانیه به ۱۶-۱۸ ثانیه کاهش داد. - حذف کش: تیم دریافت که کش کردن
node_modulesکندتر از بازسازی آن است، زیرا کلید کش با تغییر فایل lockfile مدام تغییر میکرد. بازیابی از کش ۲۸ ثانیه زمان میبرد، در حالی که نصب فیلترشده تنها ۷.۵ ثانیه طول میکشید. آنها برای حذف این نوسان، کش را بهطور کلی حذف کردند.
این سه تغییر، زمان راهاندازی هر تکه (Per-shard setup) را حدود ۴۴٪ کاهش داد و آن را از بازه ۱۱۰-۱۴۰ ثانیه به ۶۷-۷۳ ثانیه رساند.
اجتناب از کارهای تکراری:
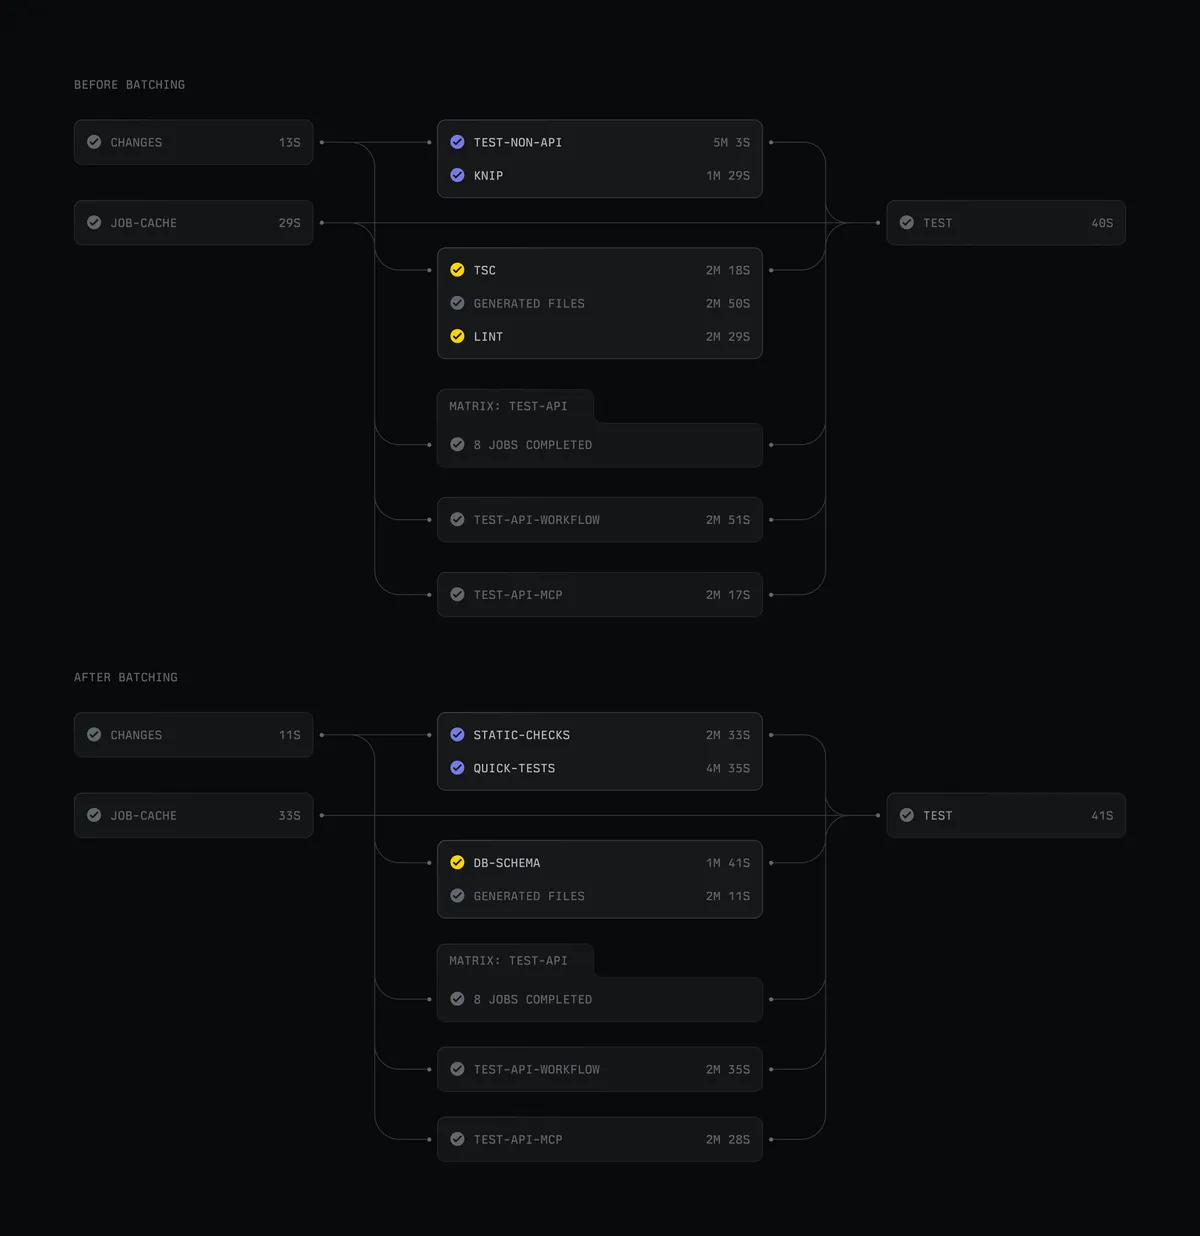
- اسنپشاتهای طرحواره (Schema Snapshots): برای جلوگیری از اجرای مجدد تمام تاریخچه مهاجرتهای دیتابیس در هر بار اجرا، تیم به بارگذاری یک اسنپشات تولیدشده از طرحواره و یک فایل Bootstrap برای PRهایی که تغییری در طرحواره ایجاد نمیکردند، روی آورد. این کار آمادهسازی دیتابیس را از ۱۲ ثانیه به ۱-۲ ثانیه در هر کانتینر کاهش داد. این رویکرد برای حذف کارهای تکراری، مشابه استراتژیهایی است که در ابزارهایی مانند Evertest برای حذف تستهای رگرسیون دستی از طریق اتوماسیون مسیر کاربر به کار میرود تا بهرهوری تیم تست افزایش یابد.
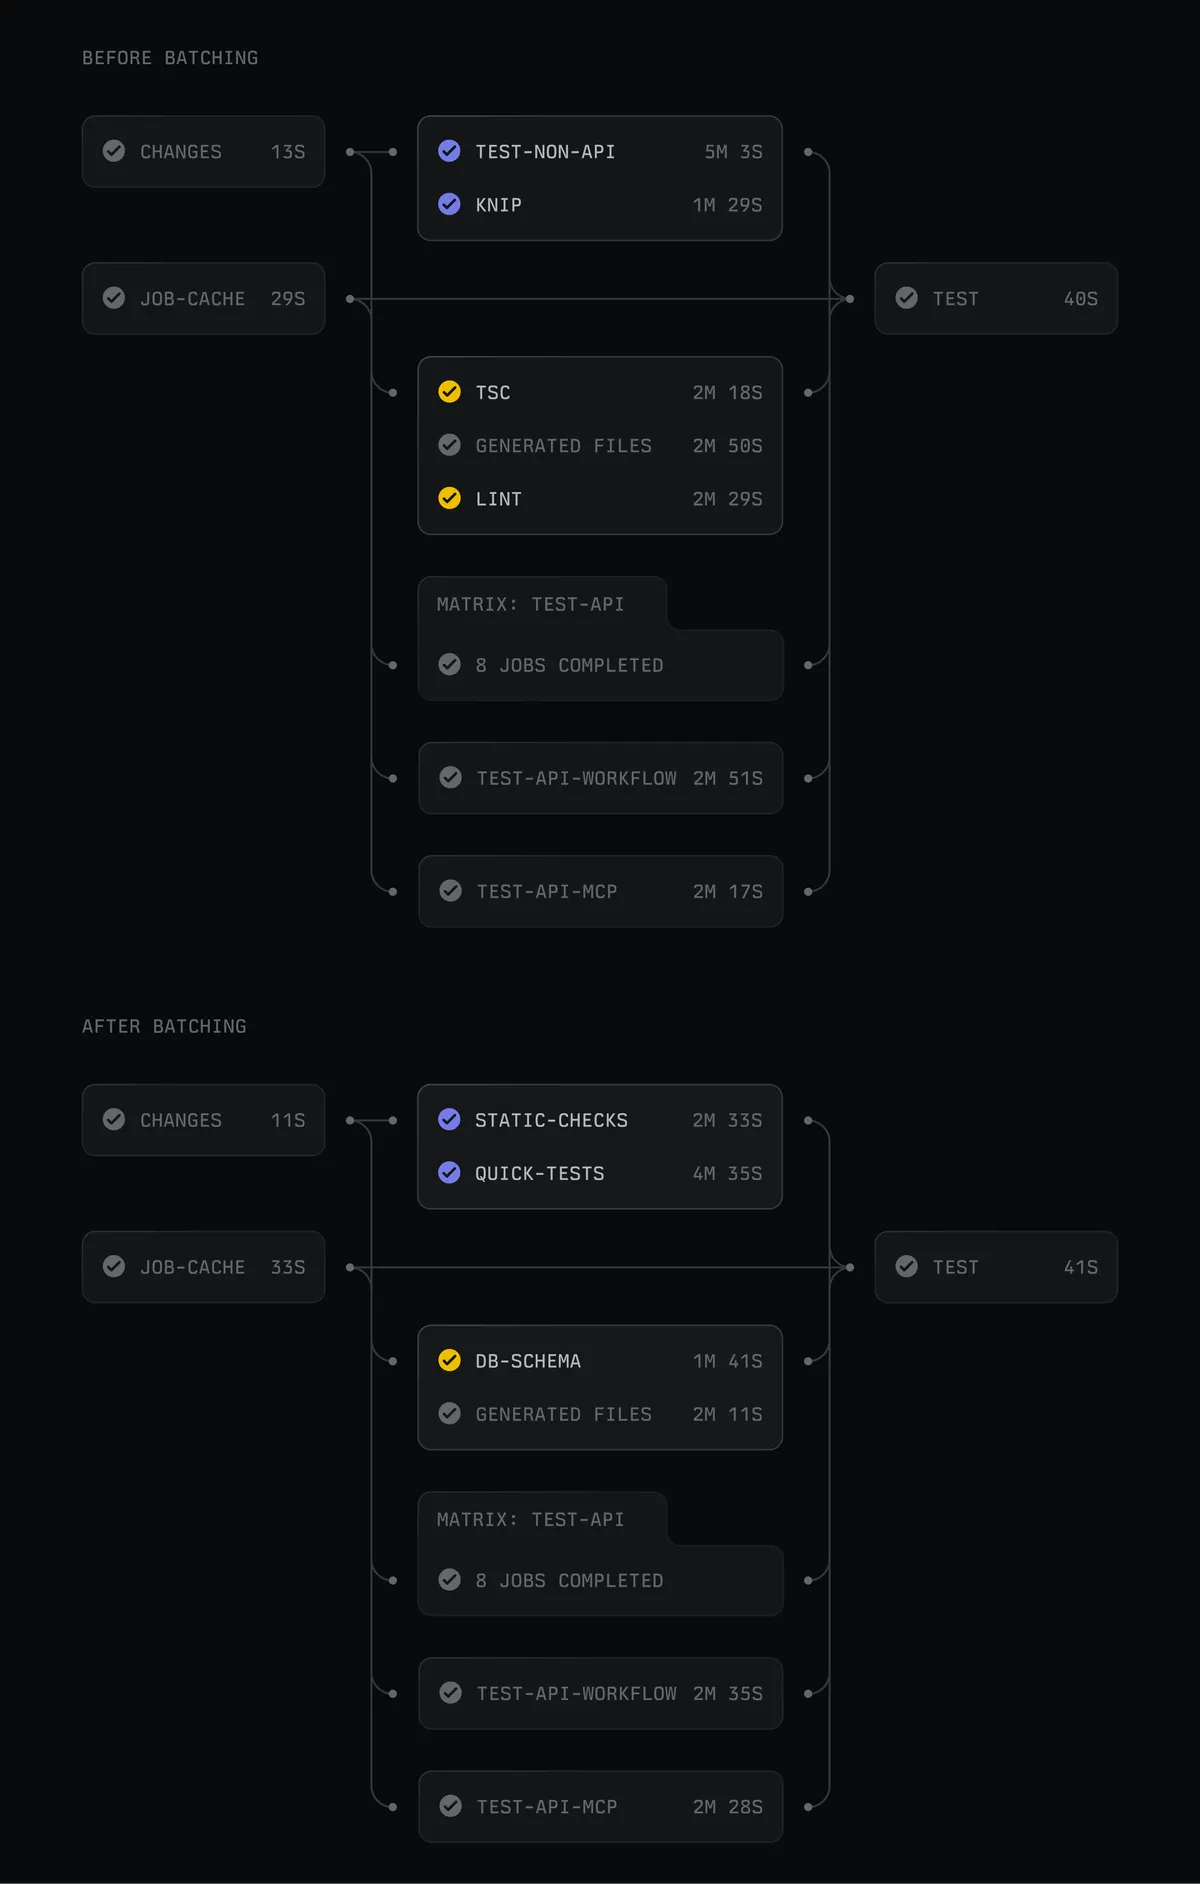
- دستهبندی وظایف (Job Batching): هفت بررسی مستقل که هر کدام نیاز به یک راهاندازی کامل Runner داشتند، در دو شغل ادغام شدند که تسکها را بهطور همزمان اجرا میکردند. این اقدام ماهانه حدود ۸۷,۰۰۰ دقیقه از زمان Runnerها را ذخیره کرد که بر اساس دادههای ژوئن، معادل ۱۱.۸٪ از کل مصرف CI بود.
اجرای بهینه تستها
با کاهش هزینههای راهاندازی، Linear توانست موازیسازی مجموعه تستهای API خود را با شدت بیشتری پیش ببرد. آنها از Vitest استفاده میکنند که کار را بر اساس فایل توزیع میکند و نه بر اساس مدت زمان تست. این موضوع اغلب باعث میشد چند فایل بزرگ بر یک تکه (Shard) غالب شوند و کل مجموعه را به تأخیر بیندازند.
با تقسیم فایلهای بزرگ به فایلهای کوچکتر و متمرکزتر و افزایش تعداد Shardها از ۴ به ۸، تیم توانست سرعت اجرای شغل بحرانی را ۱۹٪ افزایش و هزینه آن را ۱۹٪ کاهش دهد. یک هفته پس از این تغییر، کندترین تکه از ۵.۲۵ دقیقه به ۴.۳۳ دقیقه رسید.
بزرگترین دستاورد آنها معرفی یک پروژه اختیاری با تنظیم isolate: false در Vitest بود. در حالت عادی, Vitest هر فایل تست را ایزوله میکند، که Linear را مجبور میکرد گراف موجودیتها (Entity)، GraphQL و دکوراتورها را در هر تکه دوباره بسازد. اجازه دادن به فایلهای «امن» برای اشتراکگذاری یک رجیستری ماژول در هر Worker، منجر به صرفهجویی ۱۷ درصدی در زمان ماهانه Runnerها شد. کندترین تکه از بازه ۳۰۰-۳۷۹ ثانیه به حدود ۱۹۵ ثانیه کاهش یافت و مجموع زمان Runner برای تکههای API از ۳۲.۸ به ۲۲ دقیقه در هر اجرا رسید.
این بهینهسازی بیشترین ریسک را از نظر صحت (Correctness) داشت. برای مدیریت این ریسک، تیم اقدامات زیر را انجام داد:
- استفاده از یک کامنت صریح برای فعالسازی (Opt-in) در هر فایل واجد شرایط.
- افزودن عملیات Teardown لازم برای حالتهای مشترک (Shared state).
- نگه داشتن فایلهایی که از تایمرهای جعلی (Fake timers) یا حالتهای مشترک غیرقابل تفکیک استفاده میکردند در پروژه ایزوله.
- بهروزرسانی مهارتهای عاملهای هوش مصنوعی برای اطمینان از اینکه تستهای تولیدشده توسط AI بهطور پیشفرض از این محدودیتهای عملکردی پیروی کنند.
اثر تجمعی
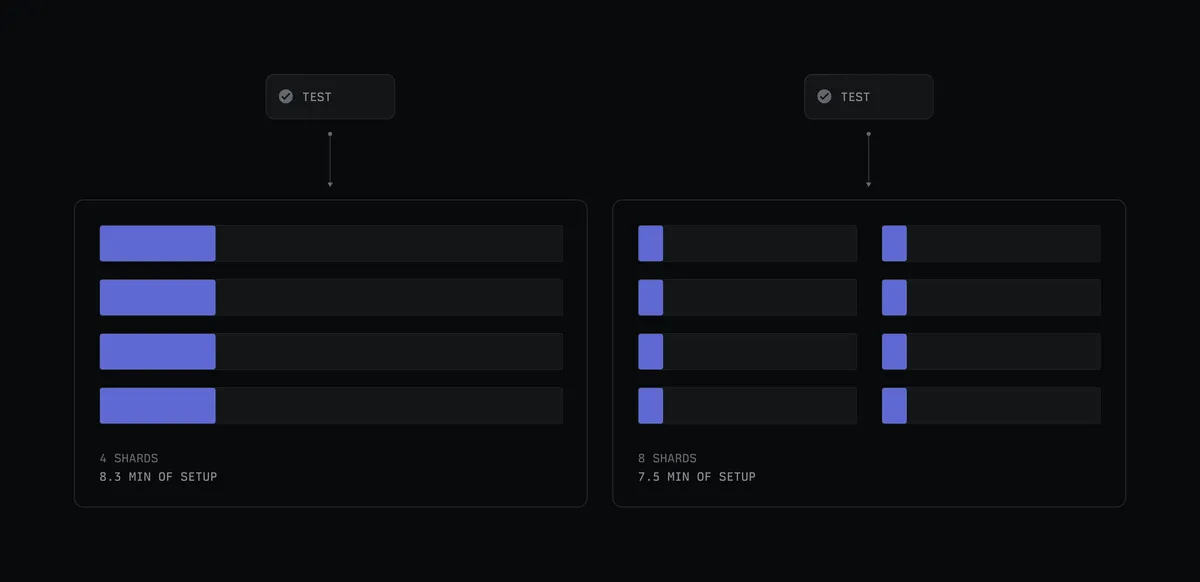
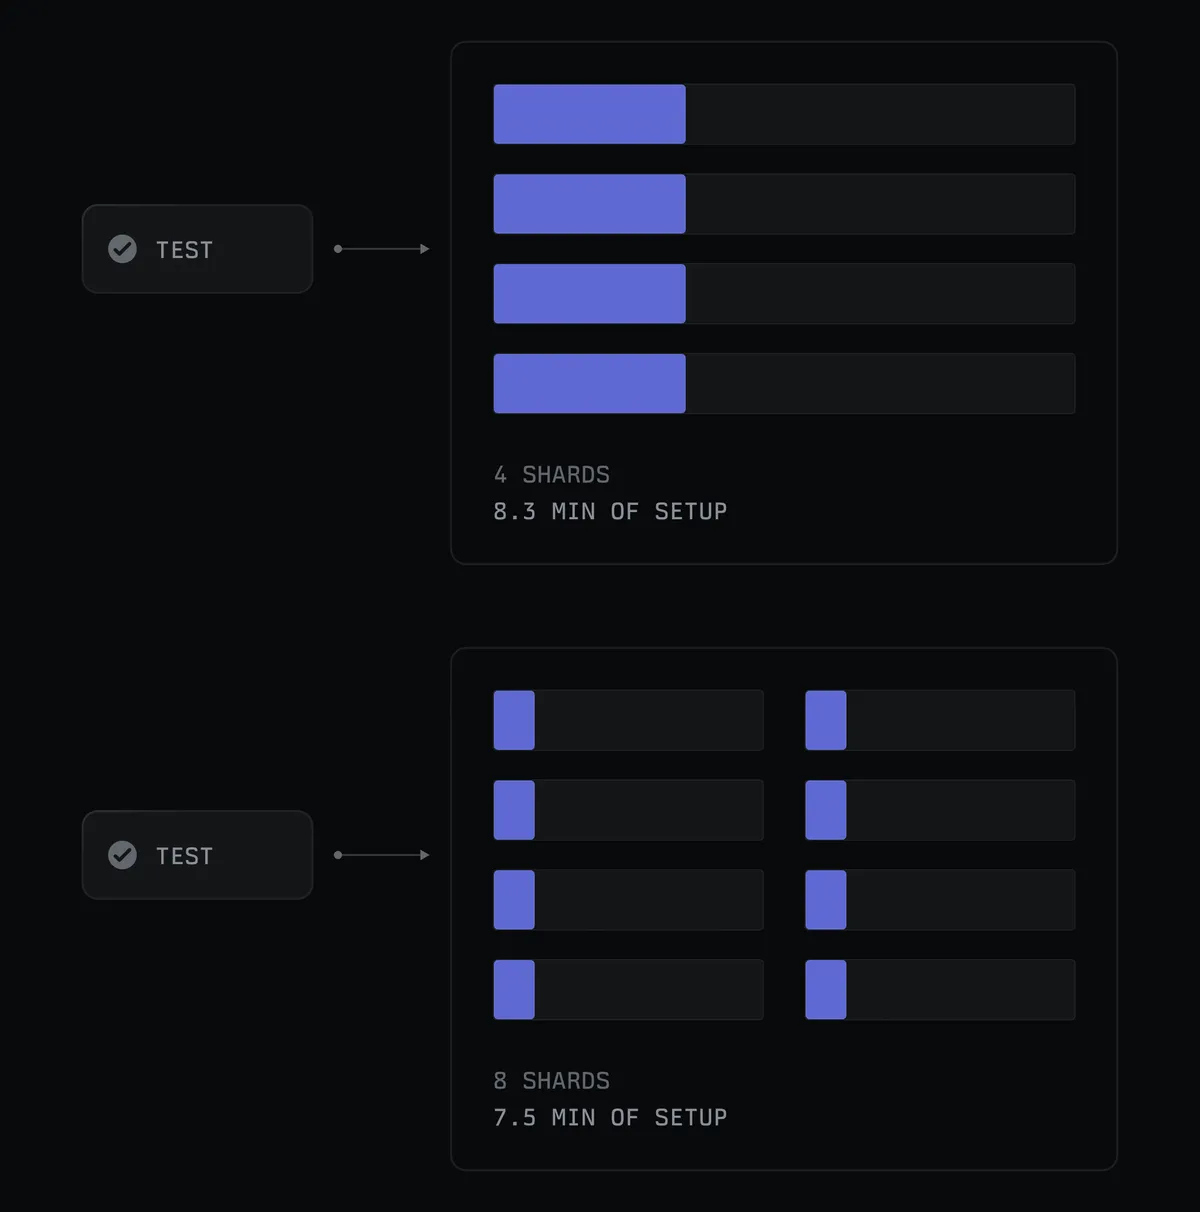
این بهینهسازیها یک چرخه مثبت ایجاد کرد. موازیسازی (Sharding) تنها زمانی جواب میدهد که هزینههای راهاندازی پایین باشد؛ در غیر این صورت، دو برابر کردن تعداد تکهها، زمان راهاندازی را نیز دو برابر میکند. پیش از بهینهسازیها، ۸ تکه تست حدود ۱۵ تا ۱۹ دقیقه فقط صرف راهاندازی میکردند — یعنی بیشتر از خودِ تستها. اما اکنون با کاهش زمان راهاندازی به حدود ۴۰ ثانیه، ۸ تکه در مجموع زمان راهاندازی کمتری نسبت به ۴ تکه قبلی مصرف میکنند.
به طور مشخص، شغل تست قبلاً از ۴ تکه استفاده میکرد و ۸.۳ دقیقه صرف راهاندازی میشد. پس از بهینهسازیها، آنها توانستند ۸ تکه را با تنها ۷.۵ دقیقه زمان راهاندازی اجرا کنند.
بدون این مداخلات، مجموعه تستهای فعلی حدود ۱۱ دقیقه زمان میبرد — یعنی تقریباً دو برابر زمان انتظار فعلی. با اضافه شدن ۲۰۰۰ تست جدید در هفته، شرکت Linear عملکرد CI را یک نبرد دائمی علیه رشد میبیند.
این تغییر رویکرد نشان میدهد در عصر کدنویسی توسط AI، گلوگاه از «نوشتن» به «تأیید» منتقل شده است. مزیت رقابتی دیگر در این نیست که یک توسعهدهنده (یا عامل) با چه سرعتی تایپ میکند، بلکه در این است که زیرساخت با چه سرعتی میتواند ثابت کند کد درست است.
برای تیمهایی که در حال مقیاسبندی جریانهای کاری با کمک AI هستند، درس روشن است: حلقههای بازخورد خود را پیش از آنکه حجم PRهای تولیدشده توسط AI خط لوله شما را فلج کند، بهینه کنید. منتظر ظهور ابزارهای «CI بومی AI» باشید که ممکن است این تغییرات زیرساختی را بهصورت آنی و خودکار انجام دهند.
گام بعدی شما
- اگر حجم PRهای تیمتان به دلیل استفاده از AI زیاد شده، ابتدا زمان «راهاندازی سرد» (Setup time) را تحلیل کنید.
- وابستگیهای ثابت را به تصویر پایه (Base Image) منتقل کنید تا زمان نصب در هر اجرا حذف شود.
- بررسی کنید آیا میتوانید برخی تستها را از حالت ایزوله خارج کرده و حافظه را به اشتراک بگذارید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو