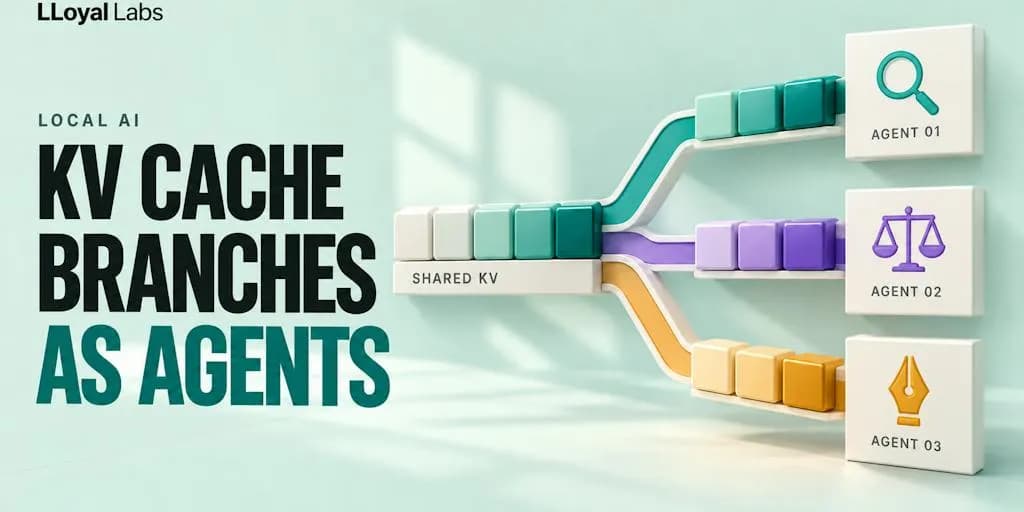
تصور کنید برنامهنویسی هستید که میخواهد یک مدل زبانی را مجبور کند همزمان پنج مسیر استدلالی مختلف را طی کند، بدون آنکه مجبور باشد پنج بار کل متن ورودی را برایش ارسال کند. این دقیقاً همان چیزی است که Lloyal در ۳۰ سپتامبر ۲۰۲۶ ارائه داد؛ ابزاری که مدل و محیط اجرای آن را در یک فرآیند واحد قرار میدهد تا دسترسی مستقیم به حافظه مدل ممکن شود.

بسیاری از فریمورکهای فعلی مانند هماهنگکنندههایی عمل میکنند که جریان کار را مدیریت میکنند، اما وضعیت زنده مدل پشت یک API پنهان میماند. این معماری وقتی چندین عامل به یک زمینه اولیه نیاز دارند، بسیار ناکارآمد است. همانطور که در بحثهای گذشته ما دربارهی پروتکلهای ارتباطی مدلها اشاره کردیم، مدیریت بهینه دادهها کلید مقیاسپذیری است. Lloyal اکنون تمرکز را از مدیریت فراخوانیها به مدیریت حافظه تغییر داده است.
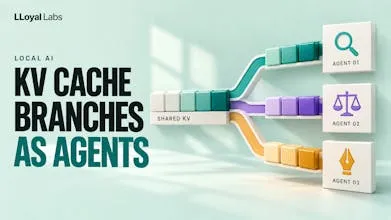
به نقل از گزارش انتشار این ابزار در Product Hunt، مکانیزم اصلی Lloyal بر پایه فورک کردن KV Cache (حافظه کلید-مقدار) — که شبیه به یک پیشنویس سریع است و مدل برای جلوگیری از خواندن مجدد متن از آن استفاده میکند — استوار است. بر اساس مستندات این فریمورک، توسعهدهندگان میتوانند:
- مجموعهای از اسناد را یکبار بخوانند و آن وضعیت را بین چندین عامل فورک (کپی) کنند.
- برای هر شاخه، مسیرهای بررسی متفاوتی تعریف کنند در حالی که زمینه مشترک دستنخورده باقی میماند.
- شاخههای غیربهرهور را بدون متوقف کردن سایر عاملها حذف کرده و حافظه را بازیابی کنند.

این رویکرد این فرض بنیادین را میشکند که وضعیت عامل باید بهصورت خارجی مدیریت شود. با برنامهریزیپذیر کردن KV Cache، اپلیکیشن تصمیم میگیرد دقیقاً چه شواهدی به کدام شاخه برسد و چه یافتههایی در زمان استنتاج (Inference) — یعنی همان لحظه تولید جواب، شبیه به پخت غذا پس از آمادهسازی مواد — باقی بمانند. این تغییر، مدل را از یک جعبه سیاه API به بخشی انعطافپذیر از وضعیت برنامه تبدیل میکند.
برای یک توسعهدهنده، این یعنی کاهش چشمگیر تأخیر و سربار حافظه در اجرای وظایف استدلالی پیچیده و شاخهای. دیگر نیازی نیست یک پرامپت حجیم را به پنج عامل مختلف بدهید؛ یکبار آن را ارسال میکنید و حافظه را فورک میکنید.
گام بعدی شما
- بررسی نحوه ادغام این روش با مدلهای وزنهای باز (Open Weights) برای کاهش هزینههای ابری.
- تست کردن Lloyal برای جایگزینی زنجیرههای طولانی API در گردشهای کاری چندعاملی.
- مطالعه مستندات فورک کردن حافظه برای بهینهسازی مصرف VRAM در محیطهای محلی.
اما تأثیر این مدیریت حافظه بر سرعت پاسخدهی مدلهای محلی حتی خیرهکنندهتر است — به تحلیل ما دربارهی بهینهسازیهای vLLM مراجعه کنید.



گفتگو