اگر مدلهای زبانی شما در حل مسائل ساده میدرخشند اما در برابر چالشهای پیچیده ریاضی یا کدنویسی کاملاً فلج میشوند، احتمالاً با اثر متیو روبهرو هستید. این پدیده بهطور نامحسوسی در حال تخریب پیشرفتهای یادگیری تقویتی (RL) در مدلهای زبانی بزرگ است و باعث میشود «ثروتمندان ثروتمندتر شوند»؛ به این معنا که مدل در حوزههایی که از قبل در آنها توانمند است پیشرفت میکند، در حالی که سختترین مسائل هرگز حل نشوند.
به نقل از مایکل نوخوویچ (Michael Noukhovitch)، در ۱۵ سپتامبر ۲۰۲۶ مکانیزمی به نام Never Give Up یا NGU معرفی شد تا این چرخه را بشکند. هدف این روش، بازتوزیع پویا و هوشمندانهٔ محاسبات (Compute) از وظایف پیشپاافتاده و بدیهی به سمت چالشبرانگیزترین مسائل است تا از اتلاف منابع جلوگیری شود.
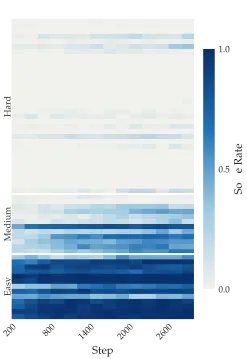
بسیاری از متخصصان RL برای ردیابی پیشرفت، به منحنیهای ارزیابی میانگین تکیه میکنند. اما این میانگینها اغلب یک شکست بحرانی را پنهان میکنند: مدل ممکن است پیشرفت کلی نشان دهد، صرفاً چون مسائل «آسان» را بینقص حل میکند، در حالی که نرخ موفقیتش در مسائل «سخت» همچنان روی صفر باقی مانده است. نوخوویچ این شکاف را — جایی که دستاوردهای RL متناسب با توانایی اولیه مدل است — «اثر متیو» مینامد.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای استدلالی اشاره کردیم، توزیع ناعادلانهٔ سیگنالهای یادگیری میتواند منجر به توقف رشد مدل شود. این پدیده تنها محدود به یک حوزه نیست؛ آزمایشها روی بنچمارکهای Deepcoder و DeepSWE نشان میدهد که این سوگیری در هر دو محیط کدنویسی و عاملمحور (Agentic) RL وجود دارد. در این محیطها، مدل بخش اعظم سیگنال آموزشی خود را صرف بازبینی وظایفی با دشواری متوسط میکند که قبلاً تا حدی آنها را حل کرده است، بهجای آنکه تلاش کند به قلمرو مسائل «بسیار سخت» نفوذ کند. این چالشها نشان میدهند که چرا استفاده از محکهای داخلی و سفارشیشده برای ارزیابی دقیقتر مدلها، بسیار حیاتیتر از تکیه بر لیدربوردهای عمومی است.
مشکل بهرهوری سیگنال
بسیاری تصور میکنند این شکست ناشی از «از دست رفتن سیگنال» (Signal Loss) است؛ یعنی این ایده که اگر مدل در $k$ تلاش (تکمیل)، هیچ پاسخ صحیحی پیدا نکند، هیچ گرادیانی برای یادگیری دریافت نمیکند. در نگاه اول، افزایش $k$ (تعداد نمونهها) یک راه حل منطقی به نظر میرسد. اما آزمایشهای نوخوویچ با مدل Qwen 2.5 0.5B Instruct روی مجموعه داده GSM8k Platinum نتیجهای متناقض و غیرمنتظره داشت: مقادیر کوچکتر $k$ اغلب مسائل سختتر را مؤثرتر از مقادیر بزرگ حل میکنند.
مشکل واقعی، «بهرهوری سیگنال» است. وقتی $k$ بزرگ باشد، احتمال یافتن یک راه حل نادر برای مسئله سخت زیاد میشود، اما همزمان احتمال یافتن یک راه حل نادرِ «غلط» برای مسئله آسان نیز بالا میرود. از آنجا که دستههای آموزشی (Training Batch)، پرامپتهایی را که همگی درست یا همگی غلط هستند فیلتر میکنند، $k$ بزرگ باعث میشود مسائل آسان مدت بیشتری در حلقه آموزش بمانند. در نتیجه، محاسبات ارزشمند روی خطاهای پیشپاافتاده تلف میشود و مدل در جایگاه میزند.
سازوکار Never Give Up (NGU)
روش NGU برای حل این مشکل، یک استراتژی نمونهگیری تطبیقی را معرفی میکند. بهجای استفاده از یک $k$ ثابت، NGU با اندازه نمونه کوچک شروع میکند. اگر پرامپت حل شود، مدل روی آن آموزش دیده و به سراغ مورد بعدی میرود. اگر پرامپت در تمام $k$ تلاش با موفقیت کامل حل شود، فوراً فیلتر میشود تا در محاسبات صرفهجویی شود.
اما اگر تمام تلاشها غلط باشند، سیستم تسلیم نمیشود. با احتمال $p$، پرامپت دوباره به تولیدکننده بازگردانده میشود تا دور جدیدی از نمونهگیری آغاز شود. این روند یک توزیع هندسی از نمونهها ایجاد میکند که در آن مدل تا زمان یافتن راه حل، به تلاش برای مسائل سخت ادامه میدهد و آنها را رها نمیکند.
بر اساس مستندات این پژوهش، در بنچمارک GSM8k Platinum، استفاده از $k=4$ با احتمال NGU برابر با $0.9$، از تمام تنظیمات استاندارد GRPO (بهینهسازی سیاست نسبی گروهی) در مقادیر مختلف $k$ پیشی گرفت، بهویژه در سختترین زیرمجموعههای داده که مدلهای عادی در آنها شکست میخوردند. این موفقیت در بهینهسازی سیاستها، یادآور بهبودهای چشمگیر مدل LFM2.5 در خروجیهای ساختاریافته است که آن هم از قدرت GRPO برای ارتقای دقت بهره برده بود.
مقیاسپذیری در ریاضی و کد
پژوهشگران این رویکرد را با استفاده از DeepScaler و مدل پایه Qwen 3 4B مقیاس کردند. پس از حدود ۱۲۰ ساعت آموزش روی تراشههای H100، روش NGU بهبودهای قابلتوجهی در سختترین بخشهای مجموعههای داده ریاضی AIME 2025 و BRUMO 2025 نسبت به خط پایه قدرتمند GRPO با $k=16$ نشان داد.
در وظایف کدنویسی، بهویژه در بنچمارک Manufactoria، روش GRPO معمولاً دچار رکود میشود. مدل در این حالت معمولاً روی تستهای با دشواری متوسط نوسان میکند بدون اینکه بتواند هرگز تمام تستهای یک مسئله خاص را پاس کند. NGU مدل را مجبور به بهبود تکرار شونده میکند؛ به این معنا که مدل تا زمانی که مجموعهای از پاسخهای جدید، تستهای بیشتری را نسبت به بهترین تلاش قبلی پاس نکند، آنها را نمیپذیرد.
مقابله با کهنگی و انعطافپذیری
یک چالش فنی در NGU، مسئله «کهنگی» (Staleness) است. چون حل یک مسئله سخت ممکن است چندین دور نمونهگیری زمان ببرد، پاسخهای منفی اولیه تا زمانی که مدل در نهایت راه حل را پیدا کرده و آموزش آغاز شود، «خارج از سیاست» (Off-policy) میشوند. تیم پژوهشی برای رفع این مشکل دو ترفند فنی به کار برد:
- آستانه سنی (Age Thresholding): فیلتر کردن پاسخهایی که سن آنها از حد مشخصی ($T=4$) بیشتر شده است تا از تخریب سیگنال یادگیری توسط نمونههای منفی کهنه جلوگیری شود.
- بازمقیاسبندی خط پایه (Baseline Rescaling): استفاده از تمام نمونهها — حتی نمونههای کهنه — برای محاسبه خط پایه GRPO، در حالی که آموزش فقط روی جدیدترین پاسخها متمرکز است. این کار تضمین میکند که سیگنال پاداش همچنان متمرکز باقی بماند.
نکته حیاتی این است که پژوهش نشان میدهد اثر متیو ناشی از فقدان «انعطافپذیری» (Plasticity) یا ناتوانی شبکه در یادگیری پس از گیر کردن در یک نقطه نیست. با ادامه آموزش از یک نقطه بازرسی (Checkpoint) راکد با استفاده از NGU یا یک پاداش باینری «پاس کردن تمام تستها»، مدلها توانستند بازیابی شوند و پیشرفت کنند. این ثابت میکند که مدلهای زبانی بزرگ میتوانند بر نمونههای بد اولیه غلبه کنند.
این تغییر دیدگاه نشان میدهد که گلوگاه RL در مدلهای زبانی، ظرفیت یادگیری مدل نیست، بلکه نحوه تخصیص محاسبات برای یافتن سیگنال است. با تبدیل محاسبات به منبعی که از مسائل آسان به سخت منتقل میشود، NGU نقشهای برای آموزش مدلهایی ارائه میدهد که فقط در دانستههای قبلی خود بهتر نمیشوند، بلکه واقعاً یاد میگیرند مسائل «ناممکن» را حل کنند.
گام بعدی شما
- اگر از GRPO برای آموزش مدلهای استدلالی استفاده میکنید، استراتژی نمونهگیری ثابت $k$ را با یک رویکرد احتمالی برای تکرار مسائل سخت جایگزین کنید.
- در تحلیل دادههای آموزش، نرخ موفقیت را به تفکیک سطح دشواری (Easy/Hard) رصد کنید تا متوجه وقوع اثر متیو شوید.
- برای کاهش اثر کهنگی دادهها در دورههای طولانی نمونهگیری، از مکانیزم Age Thresholding برای فیلتر کردن نمونههای قدیمی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell و مدیریت حافظه در آموزشهای مقیاسبزرگ مراجعه کنید.



گفتگو