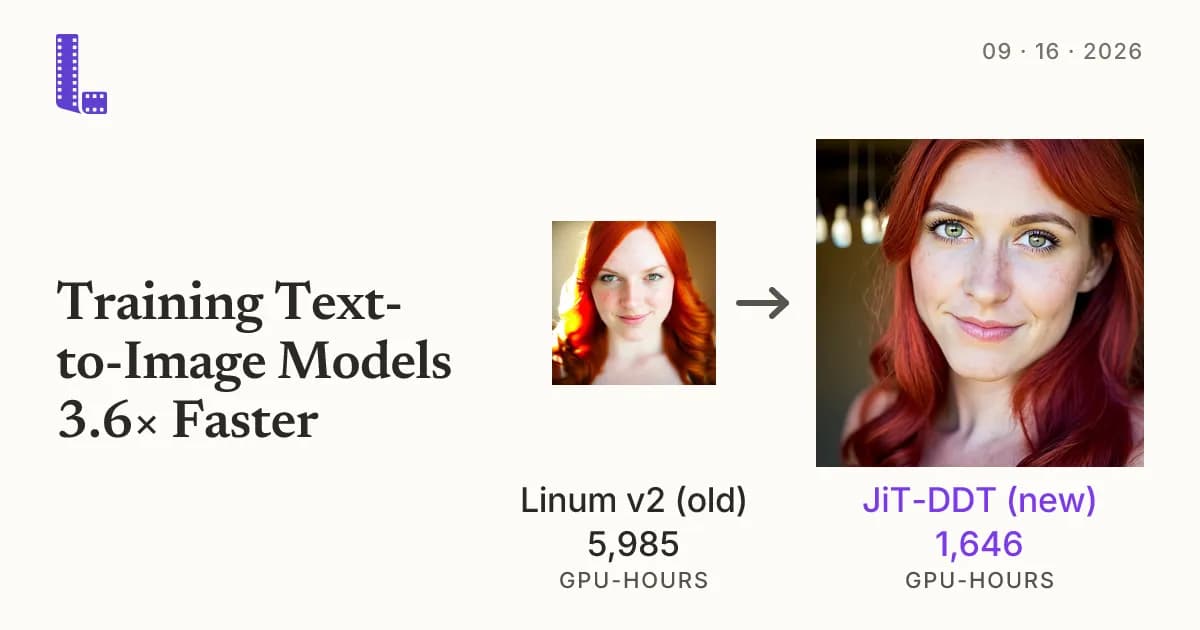
اگر امروز برای آموزش مدلهای تصویری با رزولوشن بالا هزینه میکنید، باید بدانید که یک تغییر ساختاری در معماری مدلها میتواند صورتحساب GPU شما را به شدت کاهش دهد. تیم Linum با معرفی معماری JiT-DDT ثابت کرد که میتوان تصاویر ۵۱۲ در ۵۱۲ پیکسل را با سرعت ۳.۶ برابر بیشتر از روشهای فعلی آموزش داد. این تغییر اجازه میدهد مدل تصاویری با ۴ برابر پیکسلهای بیشتر نسبت به خطمبناهای قبلی تولید کند و در عین حال، گلوگاه محاسباتی پنجره توجه (Attention Context Window) را به شدت کاهش دهد.
بیشتر سامانههای مولد فعلی از مدلهای انتشار نهان (LDM) استفاده میکنند که در آنها یک خودرمزگذار وردشی (VAE) — شبیه به یک دستگاه فشردهساز که عکسهای حجیم را به کدهای کوچک و رمزگذاریشده تبدیل میکند تا پردازش راحتتر شود — تصاویر را پیش از ورود به ترنسفورمر انتشار (DiT) فشرده میکند. طبق گزارش تیم Linum، این فشردهسازی برای کاهش هزینهها ضروری است، اما یک سقف تجربی دارد؛ یعنی یک VAE استاندارد مبتنی بر CNN تنها تا حد مشخصی میتواند فشردهسازی کند بدون اینکه کیفیت تصویر نابود شود. همانطور که در تحلیل قبلی ما دربارهی روشهای تست مدلهای تصویری با استفاده از ادعاهای ویژگی نامتقارن اشاره کردیم، صنعت مدتهاست با تضاد میان «فشردهسازی» و «حفظ جزئیات ظریف» دستوپنجه نرم میکند. این چالش در مدیریت دادههای بصری گسترده است، مشابه آنچه در مدل NeoMME برای کاهش هزینههای ذخیرهسازی بردارها مشاهده شد.
نفرین ابعاد
به نقل از پست پژوهشی منتشر شده در ۱۶ سپتامبر ۲۰۲۶، گلوگاه اصلی در آموزش، هزینه درجهدومِ مکانیزم توجه (Attention) است. در نسخه دوم Linum، یک کلیپ ۵ ثانیهای با کیفیت 720p به ۱۱۰ هزار توکن نیاز داشت که بسیار بیشتر از نمونههای ۸ هزار توکنی است که معمولاً در پیشآموزش مدلهای زبانی بزرگ (LLM) دیده میشود. برای حل این مشکل، Linum از مدلهای LDM فاصله گرفت و به سراغ مدلهای فضای پیکسل بر اساس رویکرد JiT (Just-in-Time) رفت. این رویکرد در راستای تلاشهای مستمر این تیم برای بهینهسازی است، همانطور که Linum پیشتر توانست زمان آموزش حرکات پیچیده ویدیو را به شدت کاهش دهد.
مدلهای سنتی از v-prediction استفاده میکنند که در آن شبکه، «سرعت» (Velocity) تغییرات را پیشبینی میکند. اما با رشد ابعاد کانال، مدل در تطبیق با نویزهای گوسیِ ابعاد بالا دچار مشکل میشود؛ پدیدهای که به آن «نفرین ابعاد» میگویند.
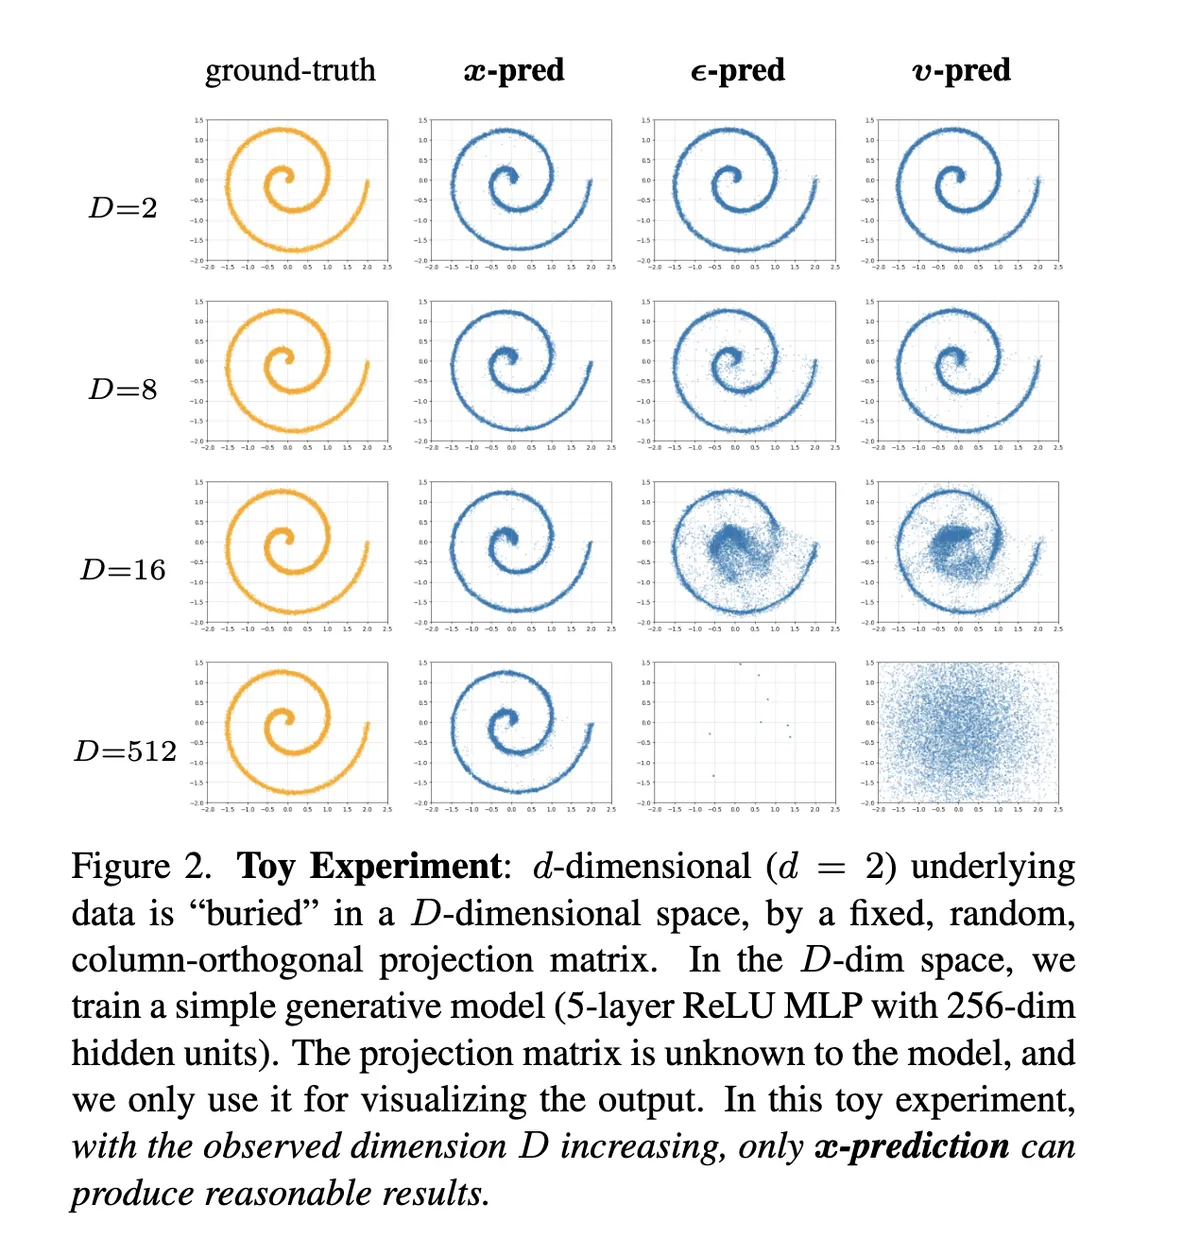
تیم Linum با تغییر استراتژی به x-prediction (پیشبینی مستقیم تصویر پاک)، توانست نویزهای غیرقابلفشرده را نادیده بگیرد و تمام ظرفیت مدل را روی سیگنالهای کمبعدِ منیفولد تصویر متمرکز کند. این کار اجازه داد تا عملیات تکهبندی (Patchification) بهصورت تهاجمی انجام شود و وظیفه فشردهسازی مستقیماً به خودِ DiT سپرده شود و VAE بهطور کامل حذف گردد.
معرفی JiT-DDT
مدل پایه JiT سریع بود و زود همگرا میشد، اما تصاویری «بیش از حد صاف» (Airbrushed) و اشباعشده تولید میکرد که فاقد جزئیات ظریف بود. برای رفع این نقص، معماری JiT-DDT (ترنسفورمر انتشار مجزا یا Decoupled Diffusion Transformer) معرفی شد. این ساختار مدل را به دو بخش تخصصی تقسیم میکند:
- رمزگذار شرطی (Conditional Encoder): بر ساختارهای فرکانس پایین تمرکز دارد. این بخش نسخهای ۶۴ در ۶۴ از تصویر را با استفاده از تکههای (Patches) ۶۴ در ۶۴ پیشبینی میکند.
- رمزگشای سرعت (Velocity Decoder): بر جزئیات فرکانس بالا تمرکز میکند. این بخش حالتهای پنهان رمزگذار و تصویر نویزی را میگیرد تا خروجی نهایی ۵۱۲ در ۵۱۲ را تولید کند.
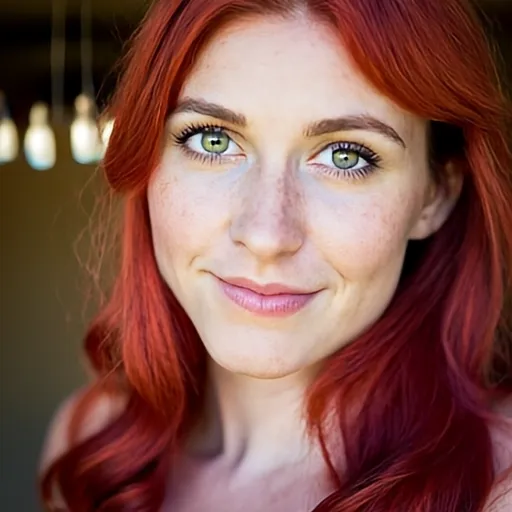
این جداسازی مانع از «تضاد بهینهسازی» (Optimization Dilemma) میشود؛ وضعیتی که در آن یک ماژول واحد باید همزمان هم مؤلفههای فرکانس بالا را کاهش دهد تا معنای کلی (Semantics) را بفهمد و هم همان جزئیات را برای تصویر نهایی بازسازی کند. حالا رمزگذار طرح کلی و ساختاری را مدیریت میکند و رمزگشا را آزاد میکند تا منحصراً روی بازیابی جزئیات تمرکز کند.
بهینهسازیهای فنی
برای افزایش بیشتر کارایی، تیم Linum چندین تغییر معماری را پیادهسازی کرد:
- ستون فقرات تکجریانی (Single-Stream Backbone): بهجای استفاده از توجه متناوب (Alternating) بین self-attention و cross-attention، توکنهای بصری و متنی در یک جریان واحد ادغام (Concatenate) شدند. این کار باعث افزایش FLOPs در هر توکن میشود اما اجازه میدهد روابط بیانگرتری بین متن و تصویر شکل بگیرد.
- بهینهساز Muon: با الگوبرداری از مدلهای Kimi شرکت Moonshot، تیم Linum از بهینهساز Muon برای ماتریسهای دوبعدی (مانند وزنهای Attention و FFN) استفاده کرد، در حالی که برای لایههای ورودی و خروجی همچنان از AdamW بهره برد.
- بردار معنایی Qwen: مدل T5-XXL جای خود را به حالتهای پنهان Qwen3.5-4B داد. در این روش، اطلاعات از سه بلوک مختلفِ full-attention تجمیع میشوند.
- PixelREPA: برای تسریع همگرایی، تیم از یک تابع زیان اصلاحشده برای همراستاسازی نمایش (Representation Alignment) استفاده کرد. آنها ۲۰٪ از توکنها را ماسک کرده و حالت پنهان رمزگذار را با ویژگیهای DINOv3-L همراستا میکنند. این تمرکز بر بهرهوری محاسباتی یادآور دستوردههای پیشآموزش Magic است که هزینههای مدلهای باز را تا ۱۰ برابر کاهش داد.
حل شکاف جزئیات
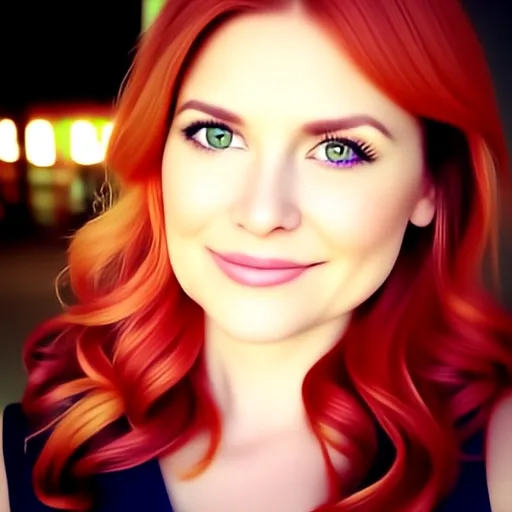
حتی با ساختار DDT، نتایج اولیه تنها بهبود اندکی داشتند. پیشرفت واقعی زمانی رخ داد که «زمانبندی نویز» (Noise Schedule) تغییر کرد. تیم Linum دریافت که حیاتیترین بخش مسیر — جایی که ساختار کلی تصویر تعیین میشود — در باند کوچکی از مقادیر بالای t رخ میدهد.
آنها با اجرای استراتژی جابهجایی نویز دو مرحلهای، مدل را مجبور کردند زمان بیشتری را صرف یادگیری این گذارهای حیاتی کند. همچنین «بهبوددهندههایی» (Refiners) که بلوکهای تخصصی برای هر مودالیته (تصویر و متن) هستند، مشابه آنچه در Z-Image علیبابا استفاده شده، اضافه شدند.
مقایسه عملکرد
مقایسه JiT-DDT با نسخه دوم Linum تکاندهنده است. نسخه دوم از یک DiT فضای نهان ۲ میلیارد پارامتری به همراه VAE در رزولوشن ۲۵۶ در ۲۵۶ استفاده میکرد. مدل جدید JiT-DDT از یک DiT فضای پیکسل با ۲.۵ میلیارد پارامتر فعال در رزولوشن ۵۱۲ در ۵۱۲ استفاده میکند. با وجود ۴ برابر شدن تعداد پیکسلها، زمان آموزش JiT-DDT به اندازه ۳.۶ برابر کمتر از مدل قبلی است.
بررسی خروجیها نشان میدهد JiT-DDT در بازسازی سبکهای هنری (مانند طراحی با زغال یا نقاشی رنگ روغن) بسیار وفادارتر است و نورپردازی واقعگرایانهتری تولید میکند. با این حال، تیم اشاره کرد که مدل همچنان در بازسازی چهرههای انسانی، زمانی که سوژه اصلی تصویر نیستند، دچار مشکل است.
این تحول نشان میدهد صنعت در حال حرکت از پشتههای مجزای VAE-DiT به سمت مدلهای یکپارچه و سرتاسری (End-to-End) در فضای پیکسل است. با تلقی کردن فضای نهان به عنوان چیزی که باید برای «تولید» یاد گرفته شود (به جای بازسازی)، توسعهدهندگان میتوانند «دیوار فشردهسازی VAE» را دور بزنند.
برای متخصصان، این یعنی هزینه آموزش مدلهای باکیفیت سریعتر از پیش کاهش مییابد. توانایی دور زدن نفرین ابعاد با x-prediction، راه را برای فشردهسازی تهاجمیتر در مدلهای ویدئویی باز میکند، جایی که تعداد توکنها در حال حاضر بزرگترین مانع مقیاسپذیری است.
کد و وزنهای مدل JiT-DDT اکنون تحت لایسنس Apache 2.0 به عنوان یک دستاورد پژوهشی در دسترس است. گام بعدی تیم، تست این معماری روی ۱۰ برابر داده بیشتر است تا ببینند آیا میتوان همراستاسازی کمکی DINO را بهطور کامل حذف کرد یا خیر.
گام بعدی شما
- اگر روی مدلهای تبدیل متن به تصویر کار میکنید، معماری JiT-DDT را برای حذف VAE و کاهش هزینه GPU تست کنید.
- بررسی کنید که آیا x-prediction میتواند مشکلهای مربوط به نویز در دادههای ابعاد بالای شما را حل کند.
- وزنهای باز این مدل را برای مقایسه کیفیت سبکهای هنری با مدلهای فعلی خود به کار بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو