اگر امروز از مدلهای بینایی-زبانی روی سختافزارهای شخصی استفاده میکنید، احتمالاً با تأخیرهای آزاردهنده در لحظه تولید پاسخ مواجه شدهاید. اما حالا یک راهکار جدید، سرعت این فرآیند را تا ۳.۱۳ برابر افزایش داده است.
در ۲۴ سپتامبر ۲۰۲۶، شرکت Liquid AI مدل آزمایشی LFM2.5-VL-DSpark را منتشر کرد. این مدل در واقع یک «پیشنویس» برای شتابدهی به مدل هدف LFM2.5-VL-3B است که میتواند سرعت استنتاج (Inference) — همان لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز — را روی دستگاههای لبه بهطور چشمگیری بالا ببرد.
بیشتر مدلهای بینایی-زبانی (VLM) با حجم محاسباتی سنگین برای پردازش همزمان تکههای تصویر و توکنهای متنی دستوپنج نرم میکنند. این موضوع باعث ایجاد یک گلوگاه میشود؛ بهطوری که زمان لازم برای تولید اولین توکن (مرحله پیشپُرکردن یا Prefill) و رمزگشاییهای بعدی، تعامل بهلحظه را روی سختافزارهای مصرفکننده کند میکند. این چالشها در راستای تلاشهای گستردهتر برای بهینهسازی مدلهای چندوجهی است، مشابه آنچه در مدل LensVLM برای حفظ دقت در عین فشردهسازی شدید دادههای بصری مشاهده شد.
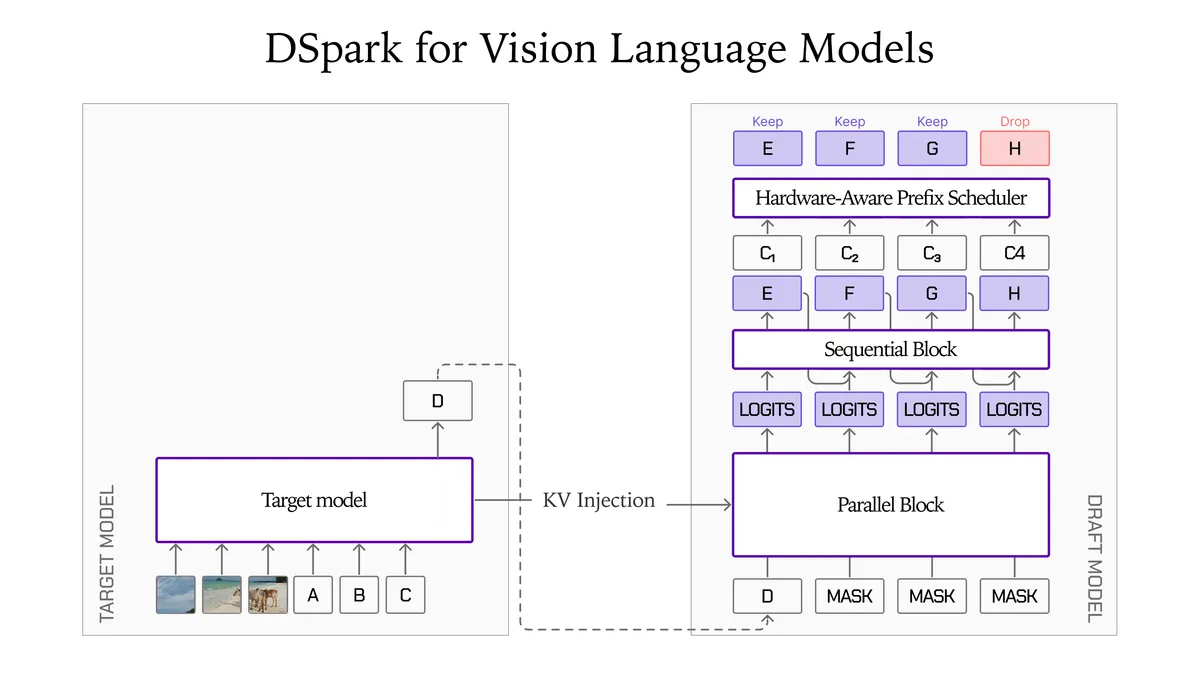
برای حل این مشکل، Liquid AI از یک مسیر رمزگشایی گمانهزنانه (Speculative Decoding) استفاده کرده است. این سازوکار — شبیه به دستیاری است که سریعاً چند کلمه احتمالی را حدس میزند و سپس استاد اصلی آنها را در یک نگاه تأیید یا رد میکند — از یک مدل کوچکتر به نام «پیشنویس» (Drafter) برای پیشبینی بلوکی از توکنهای کاندید استفاده میکند. مدل هدف بزرگتر سپس این توکنها را در یک گذر واحد تأیید میکند. چون مدل پیشنویس بسیار کوچکتر است، توکنها را بسیار سریعتر از مدل اصلی پیشنهاد میدهد.
رمزگشایی گمانهزنانه در مدلهای VLM چگونه کار میکند؟
پیشنویس بینایی از همان معماری پیشنویسهای متنی LFM2.5-DSpark استفاده میکند. این مدل حالتهای نهان (Hidden States) مدل هدف را در مجموعهای ثابت از لایههای استخراجشده (Tapped Layers) رصد کرده و بر اساس آنها، بلوکی از k توکن کاندید را پیشنویس میکند.
برای مدیریت دادههای چندوجهی (Multimodal) — مدلی که همزمان متن، عکس و صدا را میفهمد، مثل ما که با چند حس دنیا را میخوانیم — تکههای تصویر و توکنهای متن پیش از رسیدن به لایهها، به یک نمایش مشترک (Shared Representation) تبدیل میشوند. این کار باعث میشود پیشنویس فارغ از اینکه ورودی تصویر است یا متن، روی بردارهای حالت نهان با ابعاد یکسان عمل کند. در نتیجه، الگوریتم استنتاج با نسخههای متنی هیچ تفاوتی ندارد. این رویکرد بهینهسازی نمایش دادهها یادآور تکنیکهای مدل NeoMME در کاهش هزینههای ذخیرهسازی بردارهای بصری است که بهرهوری حافظه را هدف قرار داده بود.
آموزش و معماری
تیم توسعه از دستورالعمل DSpark و ترکیبی از دادههای تنظیم نظارتشده (SFT) بینایی-زبانی استفاده کردند که وزن آنها بر اساس حجم کاری مورد انتظار تنظیم شده بود. آنها برای بهینهسازی طراحی، آزمایشهای حذف (Ablations) را روی ۳، ۴ و ۵ لایه انجام دادند تا بهترین ساختار را بیابند. مدل نهایی برای ۱۰ دوره (Epoch) آموزش دید و با افزایش توکنهای آموزشی، نرخ پذیرش توکنها بهبود یافت، تا زمانی که به نقطه بازده نزولی رسید.
به نقل از وبلاگ Liquid AI، پیشنویس DSpark یک معماری سادهشدهی «فقط-توجه» (Attention-only) با مشخصات زیر است:
- تعداد پارامترها: ۲۷۹.۵ میلیون پارامتر (۸.۹٪ افزایش نسبت به مدل هدف 3B).
- تفکیک اجزا:
- پشته رمزگشا (۴ لایه): ۱۹۳.۰ میلیون
- تصویرسازی حالت نهان: ۲۱.۰ میلیون
- سر مارکوف: ۶۵.۵ میلیون
- نرمالسازها و سر اطمینان: ۶.۴ هزار
- پیکربندی: ۴ لایه رمزگشا با اندازه بلوک ۹ (بسته به سختافزار، اندازه بلوک ۸ یا ۹ در زمان استنتاج توصیه میشود).
- یکپارچگی: پشتیبانی از روز اول برای llama.cpp، MLX-VLM و SGLang.
بنچمارکهای عملکردی
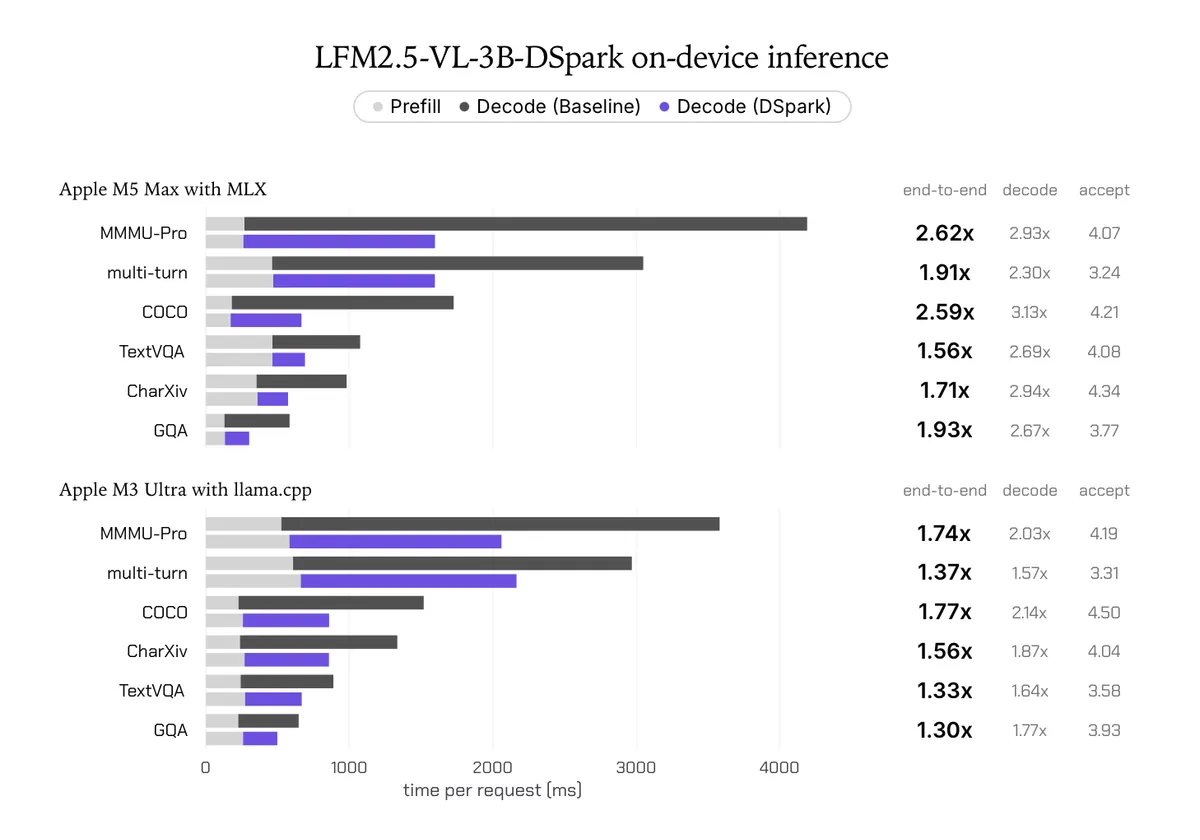
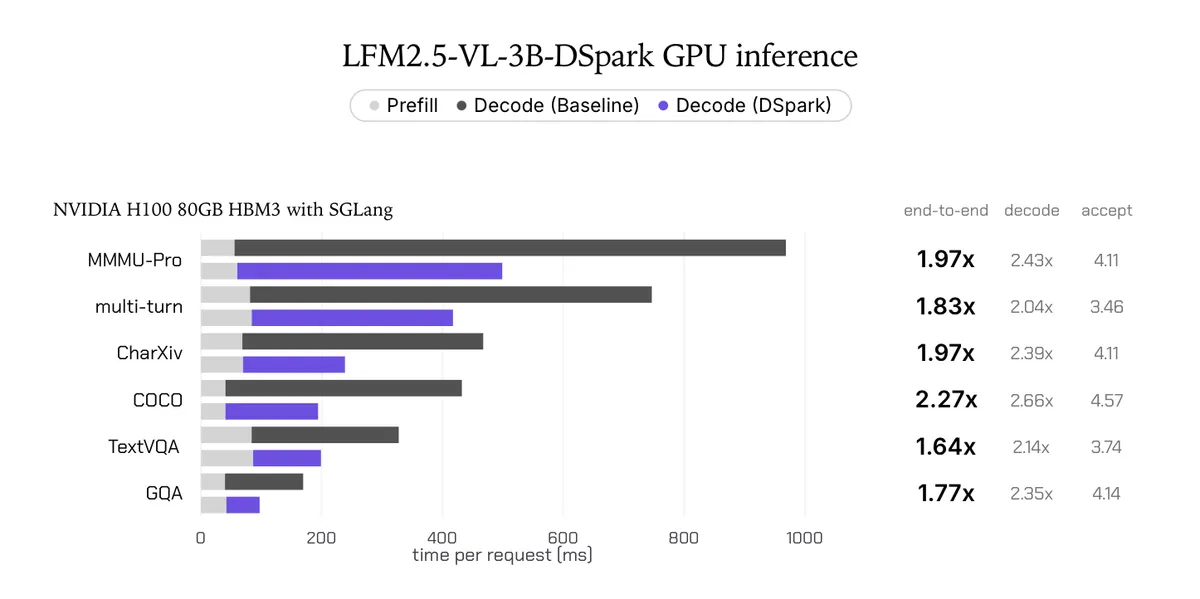
Liquid AI عملکرد مدل را روی ۶ وظیفه متنوع، شامل پرسشوپاسخ عمومی (General VQA)، پرسشوپاسخ متنی در تصویر (Text VQA)، شرحنویسی تصویر (Image Captioning)، پرسشوپاسخ نمودار (Chart VQA)، استدلال پیچیده و مکالمات چند-مرحلهای با استفاده از محک MMSpec اندازهگیری کرد. نتایج بسته به سختافزار متفاوت بود:
- Apple M5 Max (MLX): سرعت رمزگشایی ۲.۳۰ تا ۳.۱۳ برابر و تأخیر کلی (End-to-End) ۱.۵۶ تا ۲.۶۲ برابر بهبود یافت.
- Apple M3 Ultra (llama.cpp): سرعت رمزگشایی ۱.۵۷ تا ۲.۱۴ برابر و بهرهوری کلی ۱.۳۰ تا ۱.۷۷ برابر افزایش یافت.
- NVIDIA H100 GPU: شتاب رمزگشایی به ۲.۰۴ تا ۲.۶۶ برابر و بهبود کلی ۱.۶۴ تا ۲.۲۷ برابر رسید.
محدودیتهای گمانهزنی برای بینایی
با این حال، تیم سازنده به یک محدودیت حیاتی بر اساس «قانون آمدال» اشاره کرد. در مدلهای زبانی (LLM)، مرحله پیشپُرکردن عمدتاً وابسته به توان محاسباتی (Compute-bound) است و با افزایش طول پرامپت، بهصورت (نیمه) مربعی رشد میکند. در مدلهای VLM، پیچیدگی بیشتر است چون تصاویر باید ابتدا از یک رمزگذار بینایی (Vision Encoder) عبور کنند و سپس صدها توکن بصری توسط بدنه زبانی پردازش شوند.
دستگاههای لبه توان محاسباتی بسیار کمتری نسبت به GPUهای مرکز داده دارند؛ بنابراین مرحله پیشپُرکردن بخش بزرگی از تأخیر کلی را تشکیل میدهد. اگرچه شتابدهندههای عصبی GPU در تراشه M5 این فاصله را کم کردهاند، اما رمزگشایی گمانهزنانه فقط مرحله رمزگشایی (Decode) را شتاب میدهد، نه رمزگذاری بینایی یا پیشپُرکردن را. وقتی این مراحل اولیه زمانبر باشند، سود کلی کمتر از عدد خام شتاب رمزگشایی است. این چالشهای مدیریت حافظه و محاسبات در لبه، مشابه دغدغههایی است که در بهینهسازی KV Cache توسط DeepSeek برای کاهش اشغال حافظه مورد بررسی قرار گرفت.
برای توسعهدهندگان، این تغییر به معنای آن است که هوش مصنوعی بینایی با کارایی بالا روی سختافزارهای محلی، بدون نیاز به VRAM عظیم یا GPUهای صنعتی، در دسترس است. Liquid AI با تبدیل مقدار اندکی حافظه (۲۸۰ میلیون پارامتر) به جهشی بزرگ در تعداد توکن در ثانیه، مانع ورود به برنامههای چندوجهی بهلحظه را کاهش داده است.
این رویکرد معیار «آماده برای لبه» بودن مدلهای VLM را تغییر میدهد و ثابت میکند رمزگشایی گمانهزنانه فقط برای متن نیست و میتواند با حالتهای نهان چندوجهی سازگار شود، به شرطی که پیشنویس بتواند روی نمایشهای مشترک تصاویر و متن عمل کند.
گام بعدی شما
- مدلها را در قالبهای Safetensors و GGUF از Hugging Face دانلود کنید.
- برای فعالسازی، از نسخههای خاص SGLang (PR #40651)، llama.cpp (PR #29339) یا MLX-VLM (PR #2280) استفاده کرده و پرچم
--speculative-algorithm DSPARKرا فعال کنید. - عملکرد مدل را روی سختافزارهای مختلف با تمرکز بر تفاوت تأخیر پیشپُرکردن و رمزگشایی بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو