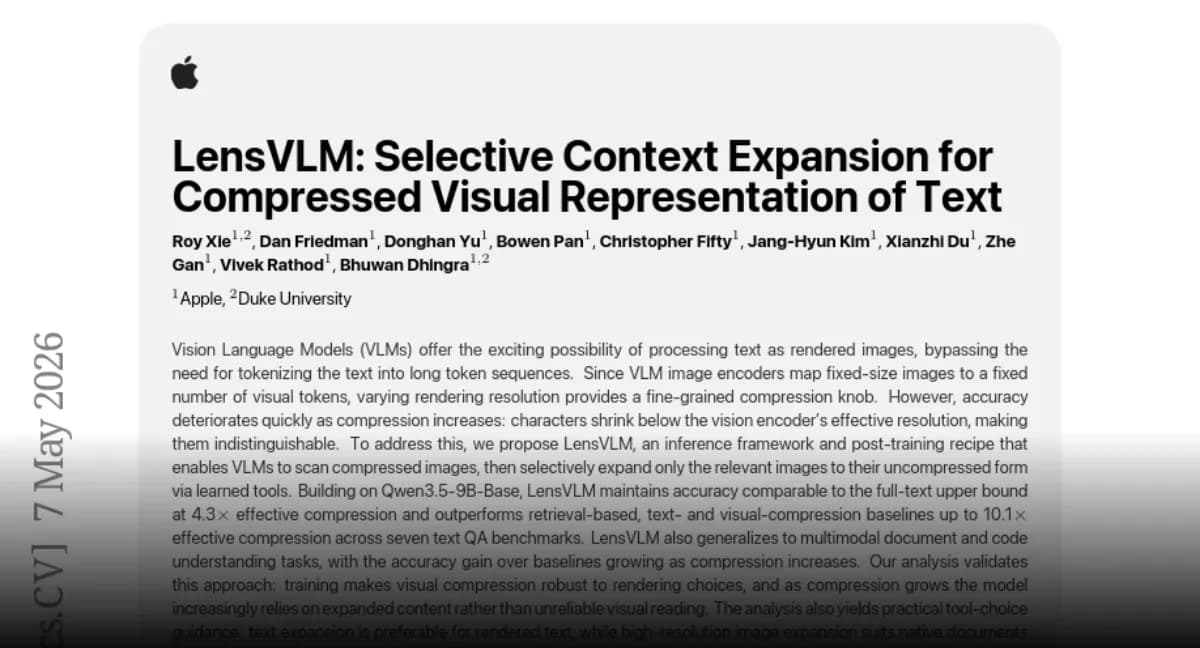
تصور کنید بخواهید یک سند ۱۰۰ صفحهای را در چند ثانیه تحلیل کنید، اما مجبور باشید بین «سرعت پایین با دقت بالا» یا «سرعت بالا با خطای زیاد» یکی را انتخاب کنید. LensVLM این بنبست را میشکند و اجازه میدهد مدلها روی بخشهای حیاتی تصویر «زوم» کنند تا دقت خود را حتی در فشردهسازیهای شدید حفظ کنند.
به نقل از مستندات منتشر شده در ۲۳ سپتامبر ۲۰۲۶، این چارچوب استنتاج (Inference) و دستورالعمل پسآموزش، مشکل ریز شدن کاراکترها در تصاویر فشرده را حل میکند. در مدلهای بینایی-زبانی (Vision-Language Model یا VLM)، وقتی تصویر بیش از حد فشرده میشود، توکنهای بصری دیگر نمیتوانند جزئیات متن را تشخیص دهند و صحت پاسخها بهشدت افت میکند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی توکنهای بصری اشاره کردیم، کاهش حجم ورودی همیشه به قیمت از دست رفتن اطلاعات تمام میشود. اما LensVLM ابتدا یک اسکن سریع از تصویر فشرده میگیرد و سپس تنها بخشهای ضروری را به حالت اصلی و بدون فشردهسازی بازمیگرداند. این رویکرد در ادامه تلاشهای صنعت برای کاهش هزینههای ذخیرهسازی است، مشابه آنچه در مدل NeoMME برای کاهش ۲۵۵ برابری حجم بردارها مشاهده شد.
این سیستم که بر پایه مدل Qwen3.5-9B-Base توسعه یافته، در هفت محک (Benchmark) مختلف پرسشوپاسخ تصویری (VQA) نتایج خیرهکنندهای ثبت کرده است:
- حفظ صحت پاسخها در سطح حداکثری حتی با فشردهسازی ۴.۳ برابری.
- برتری نسبت به روشهای بازیابی-محور و فشردهسازی بصری تا ۱۰.۱ برابر فشردهسازی موثر.
- تعمیمپذیری بالا در درک کدهای برنامهنویسی و اسناد چندوجهی.
این نتایج نشان میدهد که مدلهای کوچکتر اما بهینهشده میتوانند با سامانههای پیچیده استخراج سند رقابت کنند و کارایی مشابهی ارائه دهند.
طبق گزارش تحلیل فنی huggingface.co، رفتار مدل با افزایش فشردهسازی تغییر میکند؛ مدل از تکیه بر خوانش بصری مستقیم به سمت وابستگی شدید به محتوای گسترشیافته (Expanded Content) میرود. پژوهشگران دریافتند که برای متون رندر شده، گسترش متن بهینه است، اما برای اسنادی که چیدمان (Layout) در آنها اهمیت دارد، گسترش تصاویر با رزولوشن بالا نتایج بهتری میدهد.
این دستاورد، فرض رایج درباره «پیچ تنظیم فشردهسازی» در مدلهای VLM را تغییر میدهد. توسعهدهندگان دیگر مجبور نیستند بین تأخیر زیاد (رزولوشن کامل) و دقت پایین (فشردهسازی) یکی را انتخاب کنند، بلکه میتوانند از یک رویکرد پویا و ابزار-محور برای مدیریت توجه بصری استفاده کنند. این تغییر پارادایم در کنار معماریهای جدیدی مانند Linum که با حذف VAE سرعت آموزش را افزایش دادهاند، مسیر استنتاج سریع را هموارتر میکند.
گام بعدی شما
- بررسی پیادهسازی فنی و نتایج بنچمارکها در صفحه arXiv (کد ۲۶۰۵.۰۷۰۱۹) برای بهینهسازی جریانهای کاری استخراج داده از اسناد.
- تست مدلهای خانواده Qwen برای شناسایی نقاط ضعف در پردازش تصاویر با رزولوشن پایین.
- بررسی جایگزینی متدهای OCR سنتی با رویکرد گسترش انتخابی LensVLM.
اما تأثیر این روش بر کاهش هزینههای پردازشی در مقیاس صنعتی حتی چشمگیرتر است — به تحلیل ما دربارهی بهینهسازی حافظه VRAM در استنتاج مدلهای بزرگ مراجعه کنید.



گفتگو