رتبه هشتم در میان تقریباً ۴۰۰۰ تیم؛ این نتیجهای است که تیم FAIR در متا در رقابت سپتامبر ۲۰۲۶ شرکت NVIDIA در پلتفرم Kaggle به دست آورد. موفقیت آنها، که بخشی از سری پژوهشی AIRA بود، بر آموزش یک مدل Nemotron با ۳۰ میلیارد پارامتر برای استدلال موثرتر متمرکز بود. کلید این پیروزی، اثبات این نکته بود که یک محیط بهینهشده میتواند عملکرد عامل (Agent) را بیش از ۱۰ امتیاز بهبود بخشد، بدون آنکه حتی یک خط از وزنها (Weights) تغییر کند.
این چرخش به سمت آموزشهای سبک «دوجو» (Dojo) — جایی که عاملها از طریق تمرینات تکرارشونده در محیطهای کنترلشده صیقل میخورند — تغییری بنیادین در استراتژی توسعه است و فاصله گرفتن از رویکرد صرفاً افزایش تعداد پارامترها (Parameters) را نشان میدهد. این رویکرد در واقع یکی از دو مسیر متضاد برای آموزش عاملهای هوش مصنوعی است که بین تغییر وزنها و بهینهسازی قوانین تفاوت ایجاد میکند. همانطور که در تحلیل قبلی ما دربارهی چرخشهای سختافزاری متا اشاره کردیم، این رویکرد نرمافزاری بر زیرساختهای پیرامون مدل زبانی بزرگ (LLM) متمرکز است. این وضعیت را مانند دوندهای تصور کنید که نه با سختتر تمرین کردن، بلکه به دلیل آسفالت شدن پیست دو و محکمتر بستن بند کفشهایش، سریعتر میدود.
زمینه: معیارهای ارزیابی
برای درک این پیشرفت، باید به معیارها نگاه کنیم. محک اصلی MLE-bench است که توسط OpenAI در اواخر ۲۰۲۴ ایجاد شد و شامل ۷۵ تکلیف واقعی از رقابتهای Kaggle است. در این آزمون، به عاملها دادهها و یک بودجه زمانی مشخص داده میشود تا کد بنویسند و نتایج را ارسال کنند؛ سپس این نتایج در برابر مجموعههای آزمون واقعی Kaggle داوری میشوند.
معیار کلیدی در اینجا «نرخ مدال» (Medal Rate) است؛ یعنی نسبتی از تکالیف که در آنها عامل توانسته حداقل یک مدال برنز کسب کند. لازم به ذکر است که اکثر نتایج اولیه AIRA بر روی MLE-bench lite اندازهگیری شدند که زیرمجموعهای شامل ۲۲ مسئله با دشواری کمتر است، نه مجموعه کامل ۷۵ تکلیفی.
بر اساس تحلیل فنی منتشر شده در ۲۶ سپتامبر ۲۰۲۶، تکامل این سیستم در سه مرحله متمایز رخ داد:
تکامل AIRA
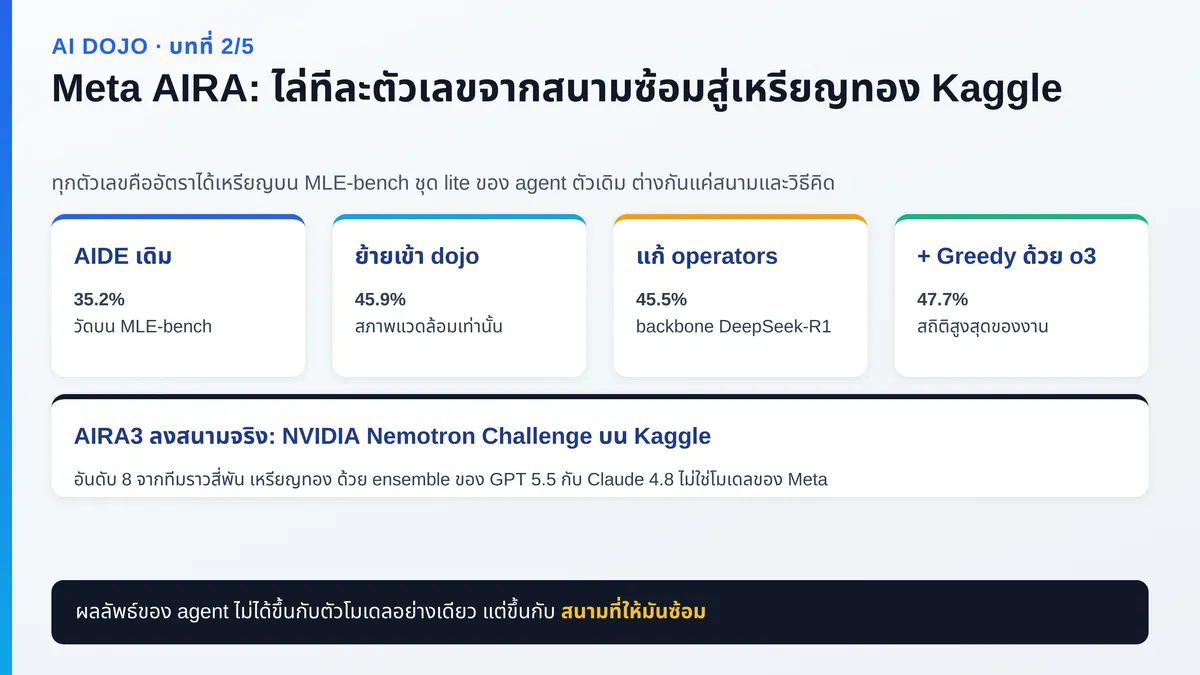
- AIRA (مرحله اول): با انتقال عامل AIDE به محیط AIRA-dojo، تیم مشاهده کرد که نرخ مدال در زیرمجموعه MLE-bench lite با استفاده از همان مدل o1-preview از ۳۵.۲٪ به ۴۵.۹٪ جهش کرد. این افزایش ۱۰.۷ امتیازی کاملاً به مدیریت بهتر وابستگیها (Dependency Management) و کاهش اصطکاک سیستم نسبت داده شد. بهبودهای بعدی در زیرساخت و افزایش زمان تفکر، این عدد را بدون تغییر در فرمول عامل به ۵۵.۰٪ رساند.
- AIRA2 (مرحله دوم): این نسخه که در اوایل ۲۰۲۶ عرضه شد، به یک معماری توزیعشده روی ۸ واحد GPU تغییر یافت که به زیر-عاملها اجازه میداد بهصورت موازی کار کنند. در این مرحله، MLE-bench-30 (شامل ۳۰ تکلیف از سطح آسان تا سخت) و AIRS-Bench (شامل ۲۰ تکلیف در سبک پژوهشهای باز) معرفی شدند. با استفاده از Gemini 3.1 Pro Preview، این سیستم در ۲۴ ساعت به رتبه صدکی (Percentile Rank) ۸۱.۵ در MLE-bench-30 رسید. برای مقایسه، مدل Gemini 3.0 Pro Preview در ۲۴ ساعت امتیاز ۷۱.۸ و در ۷۲ ساعت امتیاز ۷۶.۰ را کسب کرده بود.
- AIRA3 (مرحله سوم): در آخرین تکرار، کنترلکننده مرکزی حذف و یک معماری غیرمتمرکز «تخته اعلانات» (Bulletin Board) جایگزین شد؛ جایی که چندین عامل در محیطهای مجزا، فرضیات و یافتههای خود را بهطور مستقل مبادله میکنند.
جزئیات فنی: اپراتورها و جستوجو
تیم متا «مغز» عامل را از طریق دو مکانیزم بازطراحی کرد:
اول، اپراتورها (Operators) یا همان دستورالعملهای تفکر. عامل AIDE در ابتدا از چهار اپراتور استفاده میکرد: پیشنویس (Draft)، عیبیابی (Debug)، بهبود (Improve) و حافظه (Memory). AIRA اینها را بهروز کرد تا دشواری راهنماییها را بر اساس تعداد گزینهها تنظیم کند و حافظه را شخصیسازی نماید (مثلاً اپراتور Draft برای جلوگیری از تکرار به «خواهر و برادرهای» گرهها نگاه میکند، در حالی که Debug به «اجداد» گرهها رجوع میکند). همچنین یک «تخته یادداشت» (Scratchpad) برای تفکر ایجاد شد که در خروجی نهایی حذف میشود. استفاده از DeepSeek-R1 با این اپراتورهای جدید، امتیاز نسخه lite را در مقایسه با ۳۹.۸٪ در AIDE، به ۴۵.۵٪ رساند. این بهینهسازی در لایهی استدلال، در کنار پیشرفتهایی نظیر کاهش شدید حجم حافظه KV Cache در مدلهای DeepSeek، کارایی مدلهای استدلالی را به شدت افزایش داده است.
دوم، سیاستهای جستوجو (Search Policies). تیم استراتژیهای Greedy، MCTS (جستوجوی درختی مونتکارلو) و استراتژیهای تکاملی (Evolutionary) را آزمایش کرد. روی مدل DeepSeek-R1، روش MCTS به ۴۷.۱٪ و روش تکاملی به ۴۲.۷٪ رسید. بیشترین عملکرد روی مجموعه lite، مقدار ۴۷.۷٪ بود که با ترکیب اپراتورهای AIRA و سیاست Greedy روی مدل o3 به دست آمد.
مطالعات حذف (Ablation Studies) روی MLE-bench-30 (با بودجه ۲۴ ساعته) یک بینش حیاتی را فاش کرد: قابلیت اطمینان سیگنال ارزیابی بسیار مهمتر از تعداد زیر-عاملها است. حذف مدار ارزیابی HCE (مجموعه آزمون پنهان) باعث شد رتبه صدکی از ۷۱.۸ به ۵۶.۸ سقوط کند. در مقابل، حذف زیر-عاملها تنها رتبه را به ۶۸.۶ و حذف فرآیند تکامل آن را به ۶۴.۰ کاهش داد. این ثابت میکند که عاملها برای تکرار موثر، به بازخوردهای دقیق و بدون نشت (Non-leaked) نیاز دارند.
برای جامعه فنی، این یافته فرض بنیادین مبنی بر اینکه «مغز» یا همان LLM گلوگاه اصلی است را تغییر میدهد. جالب است که پیکربندی برنده مدال طلا حتی از مدلهای متا استفاده نکرد، بلکه GPT 5.5 و Claude 4.8 را با زیرساخت آموزشی متا ترکیب کرد. این نشان میدهد چارچوب «دوجو» مستقل از مدل (Model-agnostic) است و میتواند هر مدل استدلالی قدرتمندی را ارتقا دهد. برای کسانی که میخواهند چنین سیستمهایی را پیادهسازی کنند، آموزشهای کاربردی برای ساخت عاملهای گواهیشده با ابزارهای Hugging Face نقطه شروع مناسبی برای یادگیری چارچوبهای مشابه است.
توسعهدهندگان اکنون باید پایداری محیط و دقت حلقههای بازخورد (Feedback Loops) عاملهای خود را بر جستوجوی مدلهای کمی بزرگتر ترجیح دهند. باید منتظر ظهور بنچمارکهای استاندارد «دوجو» باشیم که کارایی محیط را بهطور مجزا از هوش مدل اندازهگیری میکنند.
گام بعدی شما
- بهجای جستوجوی مدلهای بزرگتر، روی پایداری محیط و دقت حلقههای بازخورد عاملهای خود تمرکز کنید.
- معماریهای غیرمتمرکز را برای تبادل فرضیات بین چندین زیر-عامل در محیطهای مجزا آزمایش کنید.
- از ابزارهای تفکر موقت (Scratchpad) برای جداسازی فرآیند استدلال از خروجی نهایی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو