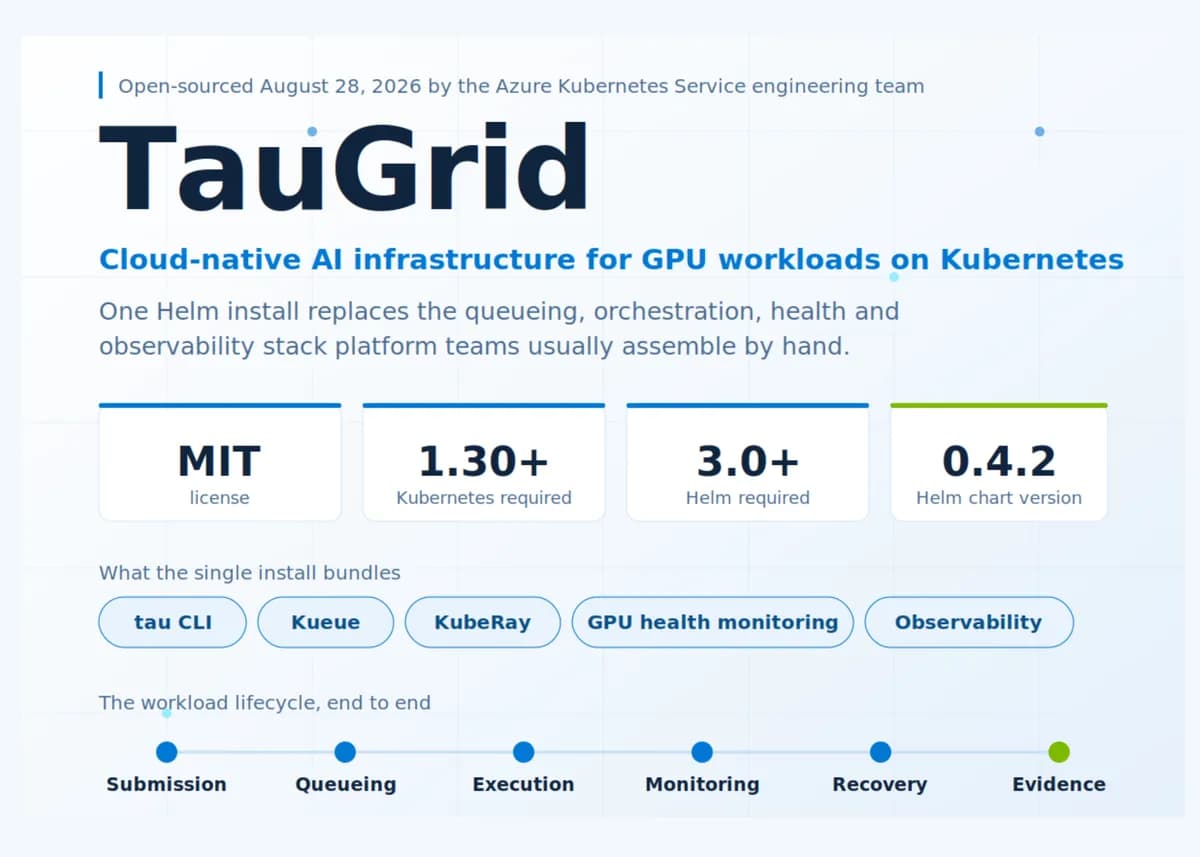
تصور کنید میخواهید یک مدل هوش مصنوعی را در مقیاس صنعتی اجرا کنید، اما باید ساعتها وقت خود را صرف چسباندن ابزارهای پراکنده برای مدیریت صفها، محیطهای اجرای توزیعشده و بررسی سلامت سختافزار کنید. مایکروسافت در ۲۸ اوت ۲۰۲۶ با متنباز کردن TauGrid این اصطکاک را به پایان رساند. TauGrid یک پشته (Stack) بومی کوبرنتیز است که تمام این ابزارهای مجزا را در قالب یک نصب سادهٔ Helm در اختیار توسعهدهندگان قرار میدهد.
زمینه (Context)
بسیاری از تیمهای پلتفرم در حال حاضر با «کار سختِ سرهمبندی» زیرساختهای هوش مصنوعی مواجهاند. آنها مجبورند اسکریپتهای ارسال درخواست و داشبوردهای نظارتی را بهصورت دستی به هم متصل کنند تا مطمئن شوند گرههای واحد پردازش گرافیکی (GPU) — که مثل موتورهای قدرتمند یک ماشین هستند و تمام فشار محاسباتی را تحمل میکنند — سالم میمانند. TauGrid به عنوان یک راهکار عملی برای تیمهایی عرضه شده است که قدرت کوبرنتیز را میخواهند اما نمیخواهند درگیر سربار عملیاتیِ یکپارچهسازی دستی شوند. در حالی که ما پیشتر به تنشهای داخلی مایکروسافت درباره استخراج دادههای هوش مصنوعی پرداخته بودیم، این انتشار جدید بر روی «لولهکشی» و زیرساخت اجرای هوش مصنوعی تمرکز دارد.
این پشتهٔ نرمافزاری که عمدتاً با زبان Go نوشته شده و تحت مجوز MIT منتشر شده است، تفکیک دقیقی بین نقشها ایجاد میکند: تیمهای پلتفرم زیرساخت (مانند فضای کاری، صفها، پروفایلهای محاسباتی، ذخیرهسازی، هویت و قابلیت مشاهده) را مدیریت میکنند و پژوهشگران صرفاً بر روی مخازن کد و رابط خط فرمان (CLI) تمرکز میکنند.
طبق مستندات مایکروسافت، TauGrid پنج مؤلفه کلیدی را در یک بسته یکپارچه میکند:
- tau CLI: رابط اصلی پژوهشگران برای ارسال دستورات و مدیریت بارهای کاری.
- Kueue: مدیریت صفبندی بارهای کاری و کنترل پذیرش (Admission Control).
- KubeRay: سازماندهی و مدیریت خوشههای Ray.
- GPU Health Monitoring: ارائه بررسیهای سطح گره برای تضمین پایداری سختافزار.
- Observability: ردیابی عملکرد خوشه و بارهای کاری در لحظه.
جزئیات (Details)
پژوهشگران برای تعریف نیازهای خود از یک فایل tau.yaml استفاده میکنند. برای مثال، یک دستور PyTorch را میتوان بهگونهای تنظیم کرد که روی یک GPU مدل A100 با ۱۶ پردازنده مرکزی (CPU) و ۶۴ گیگابایت حافظه اجرا شود. در این مسیر، سیستم از تصاویر بهینهشده در Microsoft Container Registry (MCR) استفاده میکند؛ برای نمونه تصویر mcr.microsoft.com/aks/ai-runtime/ray:py3.12-ray2.56.0-cuda13.0 با نسخه torch>=2.4.0 مورد استفاده قرار میگیرد. این تلاش برای بهینهسازی مصرف منابع در مقیاس بزرگ است، مشابه آنچه در موتور FreeToken برای اجرای مدلهای غولپیکر روی تک GPU مشاهده کردیم.
وقتی کاربر دستور tau run را اجرا میکند، سیستم ابتدا سیاستهای پلتفرم را بررسی کرده، سپس یک Kubernetes Job یا یک KubeRay RayJob را رندر کرده و آن را از طریق Kueue ارسال میکند. بر اساس مستندات فنی، این فرآیند از ۶ مرحلهٔ مشخص عبور میکند:
- ارسال (Submission): ورود اولیه بار کاری به سیستم.
- صفبندی (Queueing): قرارگیری دستورات در یک ClusterQueue مشترک در Kueue و پذیرش آنها بر اساس سهمیه (Quota) و اولویت.
- اجرا (Execution): جایگذاری دستور روی GPUهای سالم توسط کوبرنتیز.
- نظارت (Monitoring): ردیابی لحظهای وضعیت اجرای مدل.
- بازیابی (Recovery): مدیریت تلاشهای مجدد (Retries)، تشخیص خطا و بازگشت از نقاط بازرسی (Checkpoints).
- مستندسازی (Evidence): ثبت متادیتا، پیکربندی، لاگها، متریکها و نقاط بازرسی برای تضمین اینکه هر اجرا قابل بازتولید و حسابرسی باشد.
نصب این سیستم از طریق Helm Chart (نسخه ۰.۴.۲) بسیار سریع است و با دستور helm install taugrid oci://mcr.microsoft.com/aks/ai-runtime/helm/taugrid از MCR دریافت میشود. پیشنیازهای این سیستم شامل یک خوشه کوبرنتیز نسخه ۱.۳۰ به بالا با گرههای GPU، ابزار kubectl و Helm نسخه ۳.۰ به بالا است.
تصاویر رسمی برای پورتال TauGrid و کنترلر اصلی تحت مسیر mcr.microsoft.com/aks/ai-runtime/ عرضه میشوند. مایکروسافت توصیه میکند بهجای تگ latest از تگهای نسخهبندی شده یا Digestهای تغییرناپذیر استفاده شود. رابط خط فرمان (CLI) از طریق GitHub Releases برای لینوکس و macOS در دسترس است و برای ویندوز (amd64) یک نصبکننده PowerShell ارائه شده که بدون تغییر در PATH، مجموع چکسامهای (Checksums) نسخه را تأیید میکند.
اگرچه TauGrid برای انعطافپذیری طراحی شده، اما برخی قابلیتهای نظارتی فعلاً به Azure Data Explorer وابسته هستند. با این حال، مایکروسافت قصد دارد تمام وابستگیهای Azure را برای استفاده در محیطهای درونسازمانی (On-premises) حذف کند. این تغییر باعث میشود بار زیرساختی از دوش پژوهشگر به تیم پلتفرم منتقل شود. پژوهشگران دیگر نیازی به پیکربندی مستقیم کوبرنتیز ندارند و صرفاً با CLI و مخزن کد خود تعامل میکنند. این جداسازی مسئولیتها احتمال خطاهای پیکربندی در آموزشهای مقیاسبزرگ را بهشدت کاهش میدهد.
برای کل صنعت، TauGrid سیگنالی از حرکت به سمت «پشتههای استاندارد هوش مصنوعی» است. بهجای اینکه هر شرکتی یک لایه سازماندهی سفارشی بسازد، شاهد ظهور نقشههای راه (Blueprints) متنباز و بستهبندی شده برای محاسبات GPU هستیم. این رویکرد مایکروسافت با استراتژیهای رقیبانش همسو است؛ برای مثال AWS نیز با HyperPod InstantStart تلاش کرده است تا مدیریت خوشههای GPU را به شکلی خودکارتر و عاملمحور پیش ببرد. این امر مانع ورود شرکتهای متوسط برای استقرار خوشههای هوش مصنوعی در سطح تولید را کاهش میدهد.
کاربران باید توجه کنند که TauGrid بهصورت پیشفرض هیچ تلهمتری (Telemetry) به مایکروسافت ارسال نمیکند. با این حال، اگر اپراتورها بخواهند لاگهای خارجی داشته باشند، باید خروجیهای راه دور (Remote Export) را بهصورت دستی پیکربندی کنند.
گام بعدی شما
- اگر از کوبرنتیز برای مدیریت GPUها استفاده میکنید، مخزن
Azure/taugridدر گیتهاب را بررسی کنید. - برای استقرار سریع، دستور
helm installرا مطابق مستندات MCR اجرا کنید. - برای راهنمای استقرار، وبلاگ مهندسی AKS را دنبال کنید.
- تنظیمات مربوط به خروجیهای نظارتی (Remote Export) را برای فعالسازی لاگهای خارجی پیکربندی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو