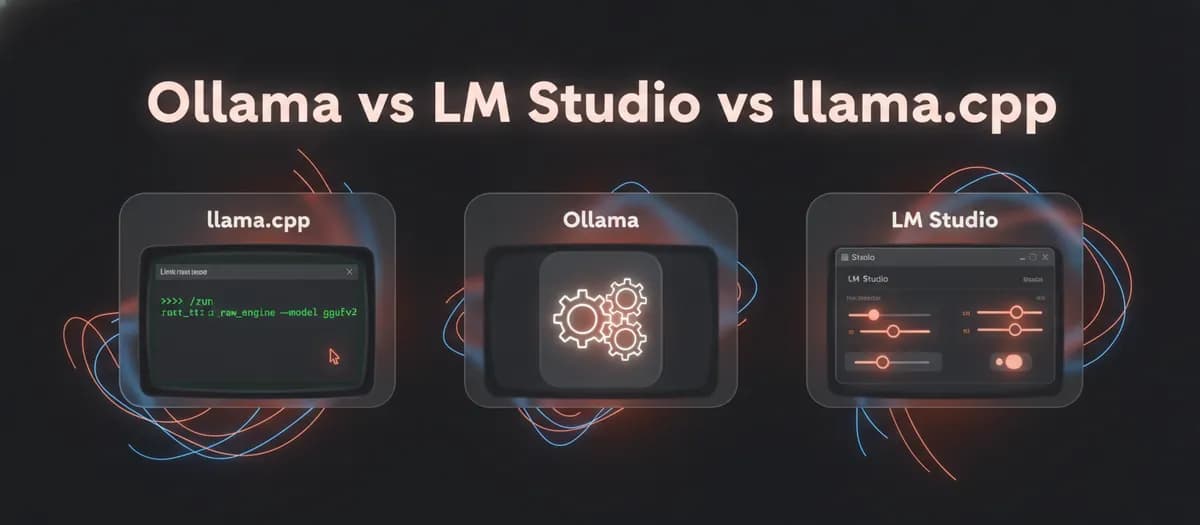
تصور کنید مدلهای پیشرفته هوش مصنوعی را بدون پرداخت هزینه برای هر توکن و بدون ترس از نشت دادهها به ابرهای متفرقه، روی سختافزار خودتان داشته باشید. در ۱۸ سپتامبر ۲۰۲۶، بررسی جامع اکوسیستم مدلهای محلی نشان داد که انتخاب بین اولاما (Ollama)، الام استودیو (LM Studio) و لاماسیپلاسپلاس (llama.cpp) نه بر اساس «بهترین بودن»، بلکه بر اساس لایهای از پشته نرمافزاری (Software Stack) است که میخواهید با آن تعامل کنید.
استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی است نه دورهی آموزش آشپز — از یک سرگرمی خاص به یک ضرورت حرفهای تبدیل شده است. برای توسعهدهندگانی که با کدهای حساس تحت قراردادهای محرمانگی (NDA) کار میکنند، مدلهای محلی تضمین میکنند که دادهها هرگز دستگاه را ترک نکنند. در این حالت، هیچ نیازی به بررسی سیاستهای امنیتی شرکت نیست، زیرا کدها روی لپتاپ باقی میمانند. این روند بازتابدهنده فشار گستردهتر صنعت برای افزایش بهرهوری است؛ برای مثال، ما پیشتر پوشش دادیم که چگونه Oxlo.ai با استفاده از مسیریابی (Routing) و حافظه پنهان (Caching)، تأخیر LLM را به ۳۰۰ میلیثانیه کاهش داد. این نشان میدهد که بهینهسازی نحوه سرویسدهی مدلها به اندازه خودِ مدلها اهمیت دارد.
برای درک این ابزارها، یک ماشین را تصور کنید. llama.cpp موتور خام است؛ قدرتمند، اما انتظار میرود بدانید هر پیچ و مهره کجا بسته میشود. Ollama ماشینی با گیربکس اتوماتیک است؛ کلید را میچرخانید و میرانید. LM Studio ماشینی با داشبورد لمسی کامل است که همه چیز را در آن میبینید و با لمس کردن کنترل میکنید. هر سه از مدلهای یکسانی استفاده میکنند، اما سطوح متفاوتی از انتزاع (Abstraction) را ارائه میدهند.
llama.cpp: زیربنای همه چیز
llama.cpp که توسط جورجی گرگانوف ساخته شده، پروژهای متنباز با زبان C/C++ است که اجرای مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را روی لپتاپهای معمولی ممکن کرد. این پروژه دلیل اصلی این است که اجرای یک مدل مناسب روی یک ماشین عادی به امری واقعبینانه تبدیل شد. طبق مستندات این پروژه، محبوبیت فرمت GGUF مدیون این ابزار است؛ فایلی واحد که هم وزنهای مدل و هم متادیتای لازم برای بارگذاری را در خود دارد.
این ابزار کنترل دقیقی را از طریق ابزارهای خط فرمان فراهم میکند:
- llama-cli: برای چت در محیط ترمینال.
- llama-server: برای ایجاد یک API محلی از طریق HTTP جهت اتصال برنامههای دیگر.
- llama-quantize: برای فشردهسازی مدلها به فرمتهای کوچکتر و بهینهتر.
این موتور از ماشینهای مبتنی بر CPU-only پشتیبانی میکند و از طریق Metal (در محصولات اپل)، CUDA (در کارتهای انویدیا) و Vulkan شتاب میگیرد. با این حال، کاربر باید مدلها را به صورت دستی دانلود کند و با پرچمهای (Flags) ترمینال و مسیرهای فایل راحت باشد. این ابزار برای کسانی طراحی شده است که کنترل مطلق میخواهند، در حال ساخت سامانههای سفارشی هستند یا میخواهند مکانیسمهای زیر پوست نرمافزار را درک کنند.
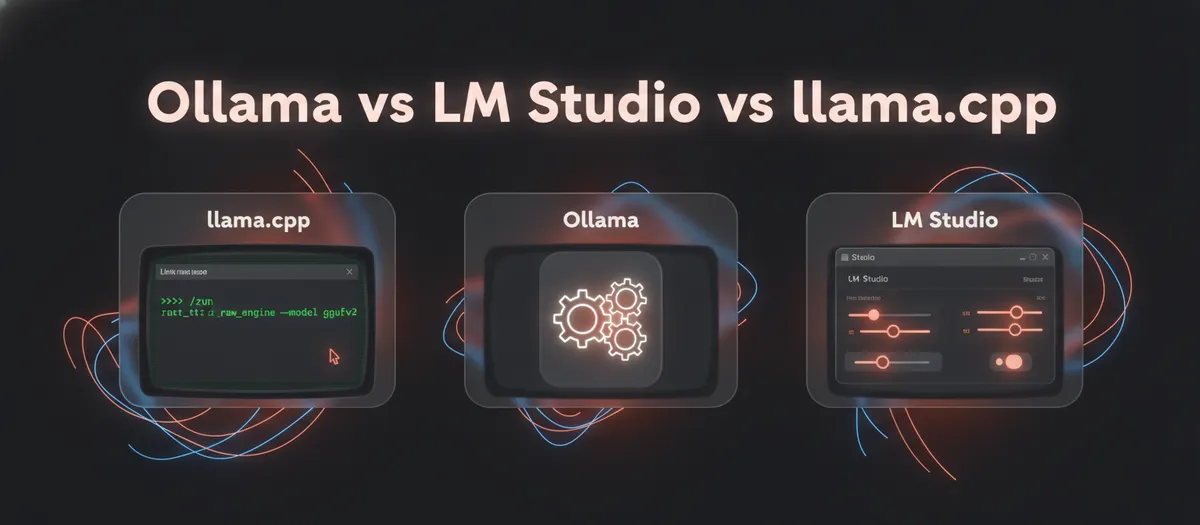
Ollama: ابزار توسعهدهندگان
Ollama شبیه به داکر برای مدلهای زبانی عمل میکند. این ابزار پیچیدگیهای اجرا را در تجربهای ساده و جریانیافته gói میکند. با یک دستور ساده مثل ollama run llama3 تمام مراحل دانلود، بارگذاری و اجرا به صورت خودکار انجام شده و کاربر مستقیماً وارد محیط چت میشود.
به گزارش توسعهدهندگان، قدرتمندترین ویژگی آن برای برنامهنویسان، سرور HTTP محلی است که به صورت پیشفرض روی پورت ۱۱۴۳۴ اجرا میشود. این سرور یک نقطه اتصال (Endpoint) سازگار با OpenAI فراهم میکند. شما میتوانید با تغییر URL پایه در کد خود، درخواستها را به ماشین شخصی بفرستید:
from openai import OpenAI
client = OpenAI(
base_url="http://localhost:11434/v1",
api_key="ollama" # توسط کلاینت لازم است اما در واقع بررسی نمیشود
)
response = client.chat.completions.create(
model="llama3",
messages=[{"role": "user", "content": "Explain recursion to a 10-year-old."}]
)
print(response.choices[0].message.content)
Ollama همچنین مفهوم Modelfile را معرفی کرده است. این یک فایل پیکربندی کوچک است که در آن پرامپت سیستمی (System Prompt) و پارامترها را تنظیم کرده و سپس آن را به عنوان مدل نامگذاری شدهی خود ذخیره میکنید. این در واقع یک «داکرفایل برای رفتار مدل» است. این ابزار که روی مک، لینوکس و ویندوز در دسترس است، هم رابط خط فرمان (CLI) و هم اپلیکیشن دسکتاپ ارائه میدهد. نکته مهم این است که Ollama از نظر تاریخی بر پایه llama.cpp برای استنتاج ساخته شده است، به این معنی که یک پوشش (Wrapper) کاربرپسندتر روی سختکوشیهای آن موتور فراهم میکند.
LM Studio: رابط بصری
LM Studio یک اپلیکیشن دسکتاپ با اولویت رابط گرافیکی (GUI) است که برای مک، ویندوز و لینوکس عرضه شده است. این برنامه نیاز به ترمینال را کاملاً حذف کرده و یک مرورگر داخلی برای جستوجو و دانلود مدلهای GGUF مستقیماً از Hugging Face در اختیار کاربر قرار میدهد.
مزایای کلیدی آن عبارتند از:
- کنترلهای بصری: استفاده از اسلایدرها و فیلدها برای تنظیم دما (Temperature) و پنجره زمینه (Context Length)، به جای پرچمهایی که باید به خاطر بسپارید.
- شفافیت سختافزاری: نمایش واضح میزان انتقال بار به GPU (GPU Offloading) و استفاده از VRAM، که باعث میشود راحتتر بفهمید چرا یک مدل بارگذاری نمیشود.
- پشتیبانی از اپل سیلیکون: پشتیبانی از مدلهای MLX در کنار فرمت GGUF.
اگرچه این ابزار API سازگار با OpenAI دارد، اما برای سرورهای بدون مانیتور (Headless) مناسب نیست. همچنین، برخلاف دو مورد قبلی، خودِ اپلیکیشن یک پروژه متنباز نیست که بتوانید آن را فورک (Fork) کنید، بنابراین کاربران باید لایسنس فعلی را برای استقرار در محیطهای شرکتی بررسی کنند. این ابزار برای مبتدیان، دانشجویان، طراحان و مهندسان پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن برای گرفتن بهترین جواب — ایدهآل است.
محدودیتهای فنی و بهینهسازی
اجرای هوش مصنوعی محلی، نبردی علیه محدودیتهای سختافزاری است. یک اشتباه رایج، تلاش برای بارگذاری یک مدل ۷۰ میلیارد پارامتری روی لپتاپی با ۱۶ گیگابایت رم است که معمولاً به کرش کردن سیستم و این نتیجهگیری غلط منجر میشود که «هوش مصنوعی محلی خراب است».
کاربران باید مفهوم کوانتش (Quantization) — یعنی فشردهسازی وزنهای مدل — را درک کنند. این مدلها معمولاً با برچسبهایی مثل Q4_K_M یا Q8_0 شناخته میشوند:
- Q4_K_M: یک نقطه شروع متعادل و محبوب؛ فایل کوچکتر، مصرف حافظه کمتر و افت کیفیت اندک.
- Q8_0: کیفیتی بسیار نزدیک به مدل اصلی اما بسیار سنگین برای منابع سیستم.
مدیریت حافظه گلوگاه اصلی است. فایل مدل باید در RAM یا VRAM جای بگیرد و فضای اضافهای برای پنجره زمینه (Context Window) باقی بماند. برای مثال، یک فایل ۴.۵ گیگابایتی روی ماشینی با ۸ گیگابایت رم کل، فضای بسیار محدودی خواهد داشت. اگر مدلی بارگذاری نشد، کاهش طول پنجره زمینه اغلب تنها راه حل است، زیرا یک پنجره زمینه بزرگ، حتی قبل از اینکه شما اولین کلمه را تایپ کنید، حافظه را میبلعد.
موازنه استراتژیک
انتخاب ابزار به هدف شما بستگی دارد. اگر در حال یادگیری یا تست پرامپتها هستید، LM Studio سریعترین مسیر است. اگر در حال ساخت یک اپلیکیشن یا خودکارسازی یک گردش کار هستید، Ollama بهترین یکپارچگی را فراهم میکند. اگر به حداکثر کارایی، جاسازیهای سفارشی (Custom Embedding) یا کنترل عمیق نیاز دارید، llama.cpp تنها گزینه است.
بسیاری از کاربران حرفهای از یک رویکرد ترکیبی استفاده میکنند: با LM Studio قابلیتهای یک مدل را کشف و تست میکنند و سپس همان مدل خاص را از طریق Ollama برای اسکریپتهای تولیدی مستقر میکنند. این یک تردید در انتخاب نیست، بلکه استفاده از ابزار مناسب برای هر مرحله از کار است. برای مدیریت بهینه این ترکیب، استفاده از یک گردش کار ترکیبی (Hybrid Workflow) میتواند تعادلی میان قدرت ابر و حریم خصوصی مدلهای محلی ایجاد کند.
این تغییر جهت به سمت هوش مصنوعی محلی چندین مشکل واقعی را حل میکند:
- هزینه: تست ۳۰۰ نسخه مختلف از یک پرامپت در APIهای پولی گران است؛ اما در حالت محلی، تنها هزینه، برق و صبر شماست.
- اتصال: مدلها در پروازها، قطارها یا مکانهایی با وایفای ضعیف هتل، به صورت آفلاین کار میکنند.
- آموزش: این تجربه یک درس ملموس در مورد حافظه LLM و VRAM ارائه میدهد که هیچ مقاله وبلاگی نمیتواند جایگزین آن شود.
- مهارت شغلی: راهاندازی گردش کارهای خصوصی LLM محلی اکنون به یک وظیفه واقعی در شرکتهای بزرگ تبدیل شده است.
اشتباهات رایج
برای جلوگیری از سرخوردگی، این نکات کاربردی را به یاد داشته باشید:
- کوچک شروع کنید: با مدلهایی در محدوده ۳ تا ۸ میلیارد پارامتر شروع کنید. اگر اینها کار کردند، سپس مقیاس را بالا ببرید.
- دانلود بیش از حد نکنید: از دانلود پنج مدل مختلف قبل از تست کردن یکی از آنها خودداری کنید. پهنای باند و SSD شما از شما سپاسگزار خواهند بود.
- انتظارات را مدیریت کنید: یک مدل ۷ میلیارد پارامتری روی لپتاپ برای خلاصهسازی، پیشنویس نوشتن و دستهبندی عالی است، اما در استدلالهای سخت (Hard Reasoning) با مدلهای ابری پیشرو رقابت نمیکند. در این راستا، برای ارزیابی دقیق عملکرد مدل روی دادههای خاص خود، استفاده از محکهای داخلی (Custom Benchmarks) بسیار موثرتر از تکیه بر لیدربوردهای عمومی است.
- لایسنسها را چک کنید: «وزنهای باز» (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده — همیشه به معنای رایگان بودن برای استفاده تجاری نیست. همیشه شرایط خاص هر مدل را بررسی کنید.
- واقعیت سختافزاری: اگر مدل کند است، معمولاً مشکل از حافظه یا انتقال بار به GPU است. تغییر ابزار از Ollama به LM Studio حافظه VRAM شما را زیاد نمیکند.
- تداخل پورتها: اگر با پیام "Port 11434 already in use" مواجه شدید، معمولاً به این معنی است که Ollama از جلسات قبلی هنوز در پسزمینه در حال اجراست.
برای کسانی که امروز شروع میکنند، توصیه میشود با یک مدل کوچک در محدوده ۳ تا ۸ میلیارد پارامتر آغاز کنند. این کار تجربهای روان را تضمین میکند، پیش از آنکه بخواهید وزنهای بزرگتر و سختگیرتر را امتحان کنید. گام بعدی شما این است که VRAM در دسترس خود را بررسی کرده و نسخه Q4_K_M یک مدل کوچک را دانلود کنید تا ببینید چگونه با دادههای محلی شما تعامل میکند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو