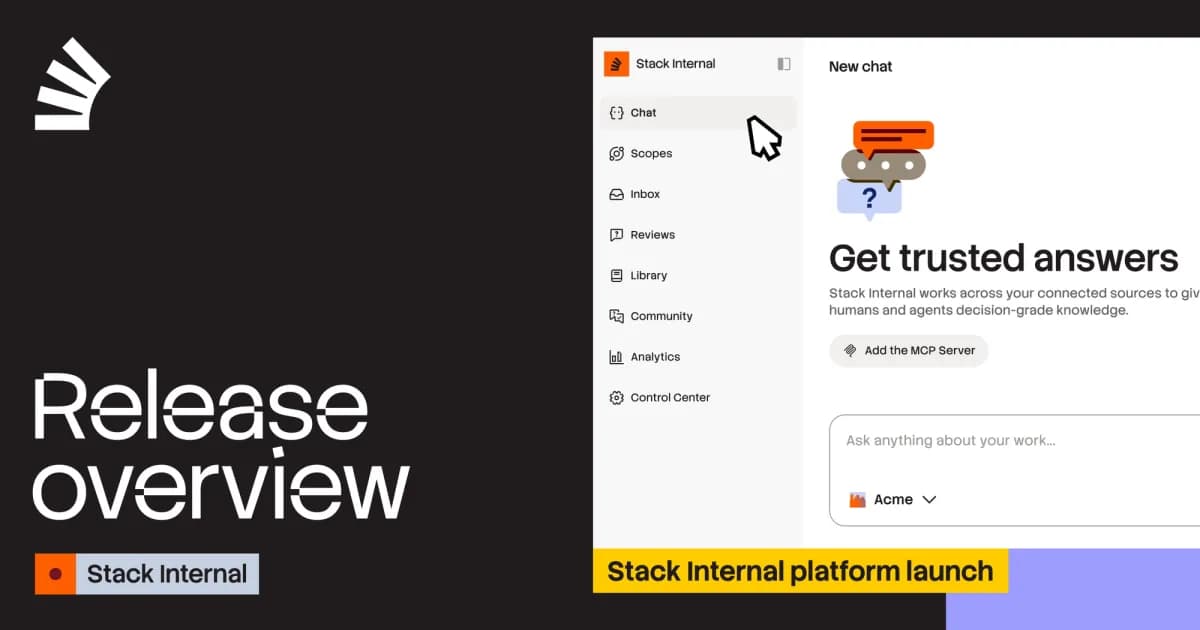
تصور کنید هر روز چه حجم عظیمی از هوش جمعی سازمان شما در کانالهای خصوصی اسلک یا اسناد فراموششده گوگل داکس دفن میشود. برای متوقف کردن این نشت اطلاعات، Stack Overflow در ۳۰ سپتامبر ۲۰۲۶ پلتفرم Stack Internal را بهصورت عمومی عرضه میکند تا دادههای پراکنده شرکتی را به دانشی در سطح «تصمیمساز» برای انسانها و عاملهای هوش مصنوعی تبدیل کند.
بیشتر سیستمهای هوش مصنوعی سازمانی بر پایه بازیابی ساده کار میکنند که اغلب اطلاعات قدیمی یا متناقض را بیرون میکشد. Stack Internal با بهکارگیری همان مکانیسمهای نظارت و رایگیری که جامعه عمومی استک اورفلو را برای دو دهه پیش برد، تفاوت ایجاد میکند. این پلتفرم با حافظه سازمانی مانند یک دارایی زنده برخورد میکند که پیش از اعتمادِ یک عامل (Agent) به آن، باید توسط متخصصان تأیید شود.
همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، اعتماد به خروجی مدلها بدون داشتن یک لایه اعتبارسنجی انسانی ریسک بالایی دارد. در جولای، این پلتفرم ابتدا برای مشتریان فعلی معرفی شد تا از دانش خود از طریق چت، API و پروتکل زمینهٔ مدل (MCP) استفاده کنند. نسخه ۲۰۲۶.۷ که در ۳۰ سپتامبر منتشر میشود، دسترسی را برای طیف گستردهتری از کاربران باز میکند.
به نقل از گزارش stackoverflow.blog، هر کسی میتواند با یک فضای کاری رایگان (Starter) شروع کند. این سطح به کاربران اجازه میدهد تا سه منبع داده را متصل کنند تا ثبت دانش تأییدشده و همکاری با همتیمیها آغاز شود. برای سازمانهای بزرگتر، این انتشار ابزارهای حاکمیتی پیشرفتهای از جمله نقشهای سفارشی برای مدیران دانش و تحلیلگران گزارشدهی را معرفی میکند.
این پلتفرم برای اطمینان از جذب مداوم زمینههای حیاتی، از چندین رابط متصلکننده استفاده میکند:
- Microsoft Teams: استخراج آموختهها از کانالهای استاندارد، خصوصی و مشترک.
- Slack و Google Docs: اکنون مجوزهای منبع را رعایت میکنند تا محتوای محدود و خصوصی را بهصورت امن جذب کنند. این یکپارچگی در حالی رخ میدهد که اسلک بهتازگی با افزودن داشبوردهای تعاملی به محیط چت، تجربه مدیریت داده در لحظه را برای تیمها ارتقا داده است.
- Ingestion API: امکان استخراج دادهها از هر ویکی، مخزن کد یا ابزار تیکتینگ که تیمها در حال حاضر از آن استفاده میکنند.
Stack Internal صرفاً متن را ذخیره نمیکند، بلکه دانش را بر اساس سیگنالهای خاصی ارزیابی میکند: منشأ (Provenance)، تازگی، تخصص، تأیید متقابل و اعتبارسنجی انسانی. این سیگنالها به یک امتیاز اعتماد ماشینخوان تبدیل میشوند تا عاملهای هوش مصنوعی با کیفیتترین پاسخها را استخراج کنند.
اگر سیستم در لحظه پاسخدهی متوجه اطلاعات متناقض شود، بهطور خودکار این تناقض را علامتگذاری میکند تا از توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه تعریف میکند — جلوگیری شود و تخصص تیمی به دانش نهادینه تبدیل گردد.
وقتی شکافی در دانش شناسایی شود، سیستم بر اساس موضوعات، متخصصان موضوعی (SMEs) را بهطور خودکار شناسایی میکند. سپس یک جریان کاری برای اعتبارسنجی فعال میشود که متخصص مربوطه را مستقیماً در اسلک مطلع میکند. این متخصصان میتوانند پاسخ را مستقیماً در اسلک تأیید یا بهروزرسانی کنند یا درخواستها را از طریق رابط کاربری پلتفرم مدیریت نمایند.
برای انتقال این دانش به محیط عملیاتی، Stack Overflow یک سرور MCP (Model Context Protocol) ارائه میدهد. این قابلیت اجازه میدهد دانش تأییدشده مستقیماً به ابزارهایی مثل Claude، Codex، Cursor یا هر عامل دیگری که تیم استفاده میکند، تزریق شود. به این ترتیب، کدها یا راهکارهای ارائه شده توسط هوش مصنوعی بهجای حدسهای مدل، بر اساس شواهد خاص شرکت مبنیسازی میشوند.
بر اساس مستندات فنی، ایجاد اعتماد نیازمند حاکمیت سختگیرانه است. مدیران اکنون میتوانند کنترل کنند چه کسی محتوا را حذف کند یا دادههای گزارش بازرسی (Audit Log) را ببیند. این پلتفرم ردیابی کامل فعالیتها و گزارشهای بازرسی قابل استخراج بهصورت سلفسرویس را فراهم میکند تا منشأ هر تصمیمی که یک عامل میگیرد، شفاف باشد.
برای ردیابی تعاملات، یک داشبورد سلامت دانش و استفاده جدید با معیارهایی مثل «تعداد کاربران فعال روزانه» و «نرخ پاسخهای مفید» اضافه شده است.
برای امنیت سازمانی، نسخه ۲۰۲۶.۷ بر پایه نسخه ۲۰۲۶.۶ ساخته شده که کنترلهای امنیتی متمرکز مدیران را ارائه میداد. این موارد شامل موارد زیر است:
- کلیدهای API با اجبار هدر (Header-enforced).
- محدودیتهای نرخ (Rate limits) قابل تنظیم.
- ابزارهای چرخه عمر خودکار، مانند انقضای مقالات، برای جلوگیری از «پوسیدگی دانش».
همچنین نقاط اتصال (Endpoints) جدید v3 امکان ایجاد جدولهای ردهبندی شهرت تجمعی، کشف کاتالوگ نشانها (Badges) و فیلتر کردن فعالیتهای کاربر برای نظرات و پاسخها را فراهم میکند. علاوه بر این، یک API واردکننده محتوای محدودشده (Scoped)، مهاجرت یکپارچه مقالات، سوالات و پاسخها را با حفظ کامل نام نویسنده امکانپذیر میسازد.
این چرخش، صنعت را از تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند — به سمت نظارت فعال بر دانش میبرد. این رویکرد در واقع گامی است به سوی ساخت سیستمعاملهای هوش مصنوعی که بهجای پاسخهای تکمرحلهای، مدیریت جامع جریانهای کاری سازمانی را بر عهده میگیرند. با اجبار به حضور انسان در چرخه تأیید، شرکتها میتوانند با پنجرهٔ زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد — به عنوان منبع حقیقت برخورد کنند، نه یک حدس احتمالی.
برای یک کارمند عادی، این یعنی «دانش قبیلهای» که معمولاً در ذهن چند مهندس ارشد است، کدگذاری و در دسترس میشود. این اتفاق اصطکاک ورود نیروهای جدید را کم میکند و مانع از تکرار اشتباهات فنی در تیمهای مختلف میشود.
تصور کنید مهندسی راهکاری را در محیط IDE خود پیدا کند که در ویکی شرکت وجود ندارد. Stack Internal قصد دارد این لحظه را بهسادگی ثبت کند، شواهد را حفظ نماید تا نفر بعدی یا عامل هوش مصنوعی، راهکار را در چند ثانیه بیابد.
در آینده منتظر انتشار قابلیت 'Scopes' باشید که به کاربران اجازه میدهد دانش را بهصورت هدفمند جابهجا کنند. کاربران میتوانند دانش در حال کار را در یک فضای فردی نگه دارند، یک تصمیم را با تیم پروژه به اشتراک بگذارند و در نهایت، راهنمای تأییدشده را در سطح کل سازمان در دسترس قرار دهند.
گام بعدی شما
- اگر مدیر فنی هستید، بررسی کنید کدام منابع داده (اسلک یا تیمز) بیشترین دانش پراکنده سازمان شما را در خود دارد.
- در صورت استفاده از Cursor یا Claude، قابلیتهای MCP را برای اتصال به پایگاه دانش داخلی بررسی کنید.
- برای جلوگیری از پوسیدگی دانش، سیستمی برای انقضای مقالات قدیمی در مستندات خود تعریف کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو