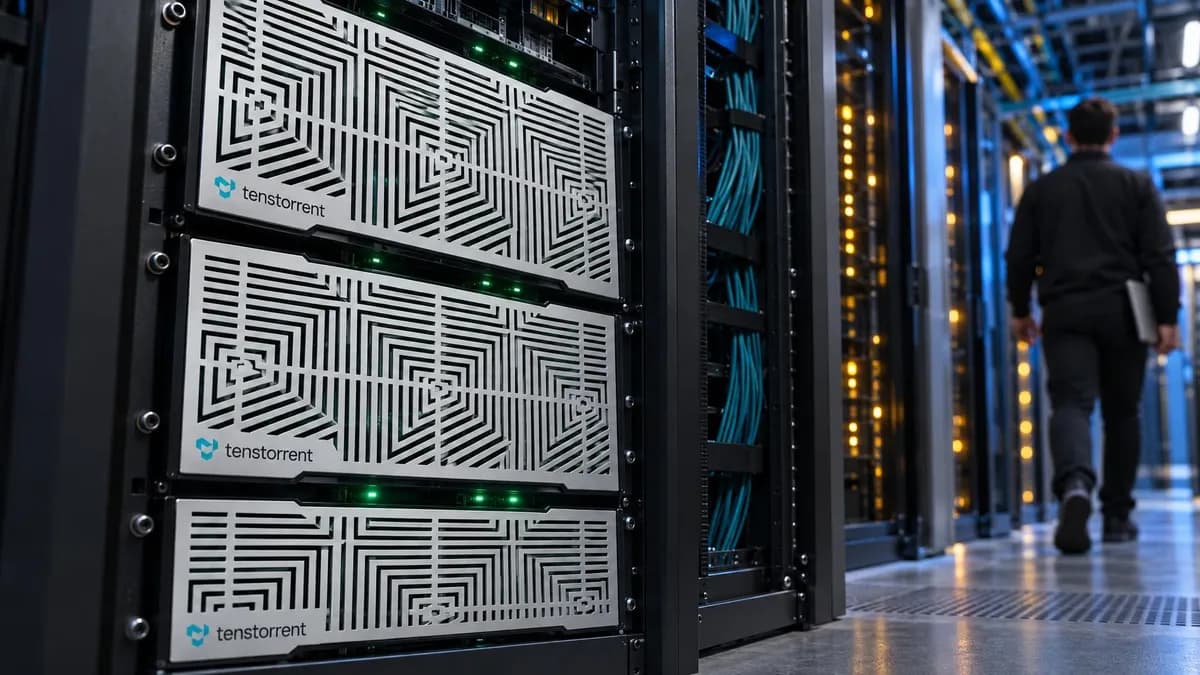
اگر امروز برای اجرای عاملهای صوتی باکیفیت در سرورهای شخصی هزینه میپردازید، احتمالاً با قبضهای سنگین انویدیا دستوپنجه نرم میکنید. اما حالا راهی برای کاهش ۴ برابری این هزینهها بدون افت کیفیت صدا پیدا شده است. در ۱ اکتبر ۲۰۲۶، شرکتهای Tenstorrent و Smallest.ai یک پشتهٔ صوتی در سطح تولید را معرفی کردند که امکان اجرای مدلهای تبدیل متن به گفتار (TTS) — شبیه به یک گویندهٔ مجازی که متن را به صدای طبیعی تبدیل میکند — را بهصورت محلی و در لحظه فراهم میکند.
برای اکثر سازمانها، انتخاب همواره بین هزینه بالای خوشههای GPU یا ریسکهای امنیتی و حریم خصوصی در فضای ابری بوده است. این همکاری جدید با هدف تأمین هوش مصنوعی حاکمیتی (Sovereign AI) برای بخشهای حساس مانند بهداشت، مخابرات و مالی طراحی شده تا سازمانها بتوانند حاکمیت کامل بر دادههای خود داشته باشند. این زیرساخت اجازه میدهد تا سازمانها حجم بالای پردازشهای صوتی را کاملاً درون دیوارهای خود و بدون خروج دادهها مدیریت کنند. این تلاش برای بهینهسازی هزینهها در حالی صورت میگیرد که رقابت در بازار مدلهای صوتی شدت یافته و حتی غولهایی مانند علیبابا قیمتهای خدمات صوتی خود را تا ۹۵ درصد کاهش دادهاند تا سهم بازار خود را حفظ کنند.
به نقل از عمرو الاشماوی، نایبرئیس استراتژی و توسعه کسبوکار Tenstorrent، نباید بین عملکرد و هزینه انتخابی صورت گیرد. او تأکید کرد که Tenstorrent محاسباتی مقیاسپذیر و کارآمد ساخته است که نه تنها هزینههای جاری گردشکارهای موجود را کم میکند، بلکه اجرای حجمهای کاملاً جدیدی از پردازش را که پیش از این غیرعملی بودند، ممکن میسازد.
قلب تپندهٔ این سامانه، مدل Lightning V2 است که بهصورت بومی روی سرورهای Tenstorrent Galaxy Blackhole اجرا میشود. این مدل هماکنون روی سختافزارهای Tenstorrent با مدل قیمتگذاری بر اساس میزان مصرف و بدون نیاز به تعهدات مالی اولیه در دسترس است.
طبق مستندات فنی Smallest.ai، این دستاورد از طریق استفاده از دقت محاسباتی BlockFloat8 (BF8) به دست آمده است. آنها دریافتند که بیش از ۸۰٪ مدل میتواند در حالت BF8 مستقر شود بدون اینکه افت کیفیت قابل اندازهگیری در صدا رخ دهد. همچنین، بیش از ۹۵٪ لایههای Lightning V2 در حالت دقت محاسباتی پایین (LoFi) اجرا میشوند. این رویکرد بهینهسازی حافظه یادآور دستاوردهای اخیر در مدلهای زبانی است، مشابه آنچه در پروژه PrismML برای کاهش ۹ برابری اثر حافظه با حفظ دقت بالا مشاهده شد.
مشخصات سختافزاری
پلتفرم Galaxy Blackhole یک نیروگاه پردازشی است که برای مقیاسهای بزرگ طراحی شده است:
- محاسبات: ۳۲ تراشه ASIC (مدار مجتمع کاربردیویژه) Blackhole که توان ۲۳ PFLOPS محاسبات Block FP8 را ارائه میدهند.
- حافظه: ۶.۲ گیگابایت SRAM روی تراشه (با سرعت ۲.۹ پتابایت بر ثانیه) و ۱ ترابایت حافظه GDDR6 (با سرعت ۱۶ ترابایت بر ثانیه).
- اتصالات: ۱۰ لینک 400 GbE برای هر ASIC جهت ایجاد یک شبکه شتابدهنده (Fabric) با سرعت ۳۲ ترابایت بر ثانیه. سیستمها از طریق حداکثر ۵۶ پورت 800 GbE QSFP-DD مقیاسپذیر میشوند.
- میزبان: پردازنده AMD EPYC 9004 با حداکثر ۵۷۶ گیگابایت حافظه DDR5 که روی سیستمعامل اوبونتو ۲۲.۰۴ اجرا میشود.
- توان و قیمت: شاسی ۶ واحدی با خنککننده هوا که بهطور متوسط ۸ تا ۱۰ کیلووات برق مصرف میکند و قیمت لیست شده آن ۱۶۰,۰۰۰ دلار است.
اقتصاد استنتاج
بر اساس پژوهشی که توسط Smallest.ai در ۲۴ مارس ۲۰۲۶ ارائه و در ۷ آوریل ۲۰۲۶ بازبینی شد، شکاف قیمتی بزرگی در هزینههای خرید تجهیزات وجود دارد. این مقاله توسط رانجیت ام اس (مهندس ارشد عملکرد استنتاج)، اکشات ماندلوی (مدیر فنی) و سودارشان کامات (مدیرعامل) نوشته شده است.
در حالی که GPUهای مدرن با قابلیت BF8 اغلب حدود ۴۰,۰۰۰ دلار قیمت دارند، Tenstorrent اجرای مشابه را روی سختافزاری در ردهٔ ۱,۰۰۰ دلاری ممکن کرده است. رانجیت اشاره کرد که با کار روی شبکه روی تراشه (NoC) و استفاده از SRAM بزرگتر، آنها توانستند به ۴ برابر بهرهوری بیشتر با کسری از هزینهٔ زیرساختهای GPU برسند.
در مدلسازی مقیاس وسیع برای ۵۵۰ درخواست همزمان ۵ ثانیهای TTS در حالت بهرهوری کامل، نویسندگان محاسبه کردند که ۱۱ عدد GPU L40S حدود ۱۰۰,۰۰۰ دلار هزینه دارد. در مقابل، ۲۷ شتابدهنده P100 تنها ۲۷,۰۰۰ دلار و ۲۷ شتابدهنده P150 حدود ۳۷,۰۰۰ دلار هزینه میبرند. این یعنی کاهش ۳ تا ۴ برابری هزینههای سرمایهای اولیه (CapEx).
تحلیل دستاوردهای عملکردی
علاوه بر هزینههای خرید، این همکاری منجر به کاهش شدید نیاز به محاسبات (Compute) شده است:
- مدل انتشار صوتی (Diffusion Acoustic Model): ۴ برابر کاهش محاسبات.
- وکودر عصبی (Neural Vocoder): ۸ برابر کاهش محاسبات.
- اندازه مدل: تقریباً ۲ برابر کاهش.
- انتقال حافظه: ۱.۸ برابر کاهش در حجم دادههای منتقل شده.
در تستهای تکدستگاهی، L40S توانست همزمانی (Concurrency) ۳ را با تأخیر ۳۰۰ میلیثانیه مدیریت کند (با هزینه ۹,۰۰۰ دلار). در مقابل، P150 و P100 هر کدام همزمانی ۱ را با تأخیر ۲۵۰ میلیثانیه اجرا کردند، در حالی که قیمت لیست شده آنها به ترتیب ۱,۴۰۰ و ۱,۰۰۰ دلار بود. این منجر به سودآوری هزینهای گزارش شده به میزان ۲.۶ و ۳.۶ برابری شد.
در سطح هسته (Kernel)، یک لایه بهینهشده با حدود ۶ میلیارد عملیات ضرب-جمع (MAC) در P150 در ۳۱ میکروثانیه اجرا میشود، در حالی که همین کار در L40S حدود ۶۰ میکروثانیه زمان میبرد. نویسندگان پیشبینی میکنند با گسترش این بهینهسازی، بهبود ۸ تا ۱۲ برابری نسبت به خط پایه L40S ممکن است.
شاخصهای عملکردی نیز رقابتی باقی ماندهاند. امتیاز ادراکی DNSMOS برای این سیستم ۳.۸۰۱ ثبت شد، در حالی که برای انویدیا ۳.۸۷۲ بود؛ تفاوتی جزئی (۰.۰۷۱) که نویسندگان آن را یک تغییر ادراکی جزئی میدانند. همچنین نرخ خطای کلمه (WER) نرمالشده بین دو سیستم تنها ۰.۰۰۹ بود.
شکنندگی عددی و چالش PCC
اما مسیر رسیدن به این بهرهوری ساده نبود. تیم متوجه شد که مدلهای TTS نسبت به مدلهای زبانی بزرگ (LLM) «شکنندهتر» هستند؛ زیرا موجهای صوتی پیوسته را از طریق پالایشهای تکراری میسازند. خطاهای عددی کوچک در مراحل حذف نویز میتوانند به صورت نویزهای شنیداری (Artifacts) ظاهر شوند.
آنها دریافتند که معیارهای استاندارد شباهت تانسوری، مانند ضریب همبستگی پیرسون (PCC)، غیرقابل اعتماد هستند. در یک مورد، خروجیهای L40S و CPU مدل AMD EPYC 7352 ضریب تنها ۰.۷۲ داشتند با وجود ورودیهای یکسان، اما صداها از نظر ادراکی غیرقابل تشخیص بودند. در مقابل، لایهای با ضریب ۱.۰ باعث خرابی صوتی شد که شناسایی و جداسازی آن بیش از یک ماه زمان برد.
این یعنی توسعهدهندگان نمیتوانند برای تأیید صحت مدل پس از کوانتایزیشن (Quantization) — یعنی تبدیل اعداد دقیق به فرمتهای کوتاهتر برای سرعت بیشتر — به ریاضیات سنتی تکیه کنند. در عوض، باید از اعتبارسنجی ادراکی پایان-به-پایان استفاده کنند تا مطمئن شوند صدا برای گوش انسان خراب نیست. این چالشهای فنی در سنتز صدا، اهمیت رویکردهای جدید را دوچندان میکند؛ برای مثال استارتاپ Treble با سرمایهای ۱۸ میلیون دلاری در حال توسعه شبیهسازهای فیزیکی صداست تا با عبور از مدلهای صرفاً آماری، به کیفیت و پایداری بیشتری دست یابد.
محدودیتها و چشمانداز آینده
نویسندگان پذیرفتهاند که برخی لایهها هنوز برای اجرای با دقت پایین بیش از حد حساس هستند و بدون افت کیفیت قابل اجرا نیستند. همچنین پیکربندیهای کامپایلر و برنامه هنوز به طور کامل بهینه نشدهاند.
برای یک مدیر کسبوکار، این تغییر یعنی تبدیل هوش مصنوعی صوتی از یک آزمایش لوکس به یک ابزار کاربردی. Tenstorrent با کاهش کفِ هزینه سختافزاری، استقرار هزاران عامل صوتی در لحظه را بدون پرداخت «مالیات انویدیا» ممکن کرده است.
شرکت Smallest.ai از همین حالا به آینده نگاه میکند. در پستی در ۲۸ سپتامبر ۲۰۲۶، این شرکت اشاره کرد که Lightning V2 نخستین مدل TTS است که سنتز باکیفیت را تحت کوانتایزیشن BF8 و محاسبات با دقت کاهشیافته ارائه میدهد. همچنین مدل جدیدتر آنها، Lightning V3، در حال حاضر از نظر بهرهوری از V2 پیشی گرفته است و قصد دارند همین اصول طراحی مشترک (Co-design) را برای دستیابی به پیشرفتهای هزینهای بیشتر در V3 به کار بگیرند.
گام بعدی شما
- اگر در حال طراحی سیستمهای پاسخگویی صوتی هستید، بررسی کنید که آیا مدلهای شما قابلیت اجرا در حالت BF8 را دارند یا خیر.
- برای کاهش هزینههای زیرساخت، جایگزینی GPUهای عمومی با شتابدهندههای ASIC را در معماری خود بسنجید.
- در ارزیابی مدلهای صوتی، به جای معیارهای ریاضی (مانند PCC)، روی تستهای ادراکی انسانی تمرکز کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell و رقابت با ASICها مراجعه کنید.



گفتگو